Model / Badania
Tydzień 32 · 3–9 sierpnia 2026
 Model / Badania
Model bezpieczeństwa Mistrala dorównuje rywalom prawie siedem razy większym
3 min
Mistral wypuścił Shieldstral, model do moderacji treści o 3 miliardach parametrów, który mieści się w 16 GB pamięci karty i działa na jednym GPU na licencji Apache 2.0. Kryterium filtrowania podaje się jako zwykłe pytanie po angielsku, więc politykę zmienia się jednym zdaniem, bez trenowania od nowa. Według raportu samego producenta dostał 99,4% na HarmBench, przed 94,5% dwudziestomiliardowego GPT-OSS-Safeguard, będąc prawie siedem razy mniejszym od rywali. Przy wejściu spreparowanym pod obejście filtra skuteczność jednak spada.
 Model / Badania
Otwarte wagi, których jeszcze nie ma, a i tak nie odpalisz ich w domu
4 min
Alibaba wypuściło Qwen3.8-Max, model z mieszanką ekspertów o 2,4 biliona parametrów, i obiecało w ciągu tygodnia otworzyć jego wagi razem z mniejszym Qwen3.8-27B. Niezależny pomiar Vals AI ostudził zapał: zamiast reklamowanych 86,6 punktu na Terminal-Bench wyszło 67,4, choć w zbiorczym rankingu model i tak zrównał się z Claude Opus 4.7 przy około 2,3 razy niższym koszcie. Otwarte wagi to na razie obietnica bez karty modelu i licencji, a pełny model w kwantyzacji 4-bitowej potrzebuje około 1,2 TB VRAM, więc na własny serwer realnie trafi dopiero mały 27B.
 Model / Badania
Google uczy Gemmę pisać całymi blokami i wyciąga z jednej karty 1500 tokenów na sekundę
4 min
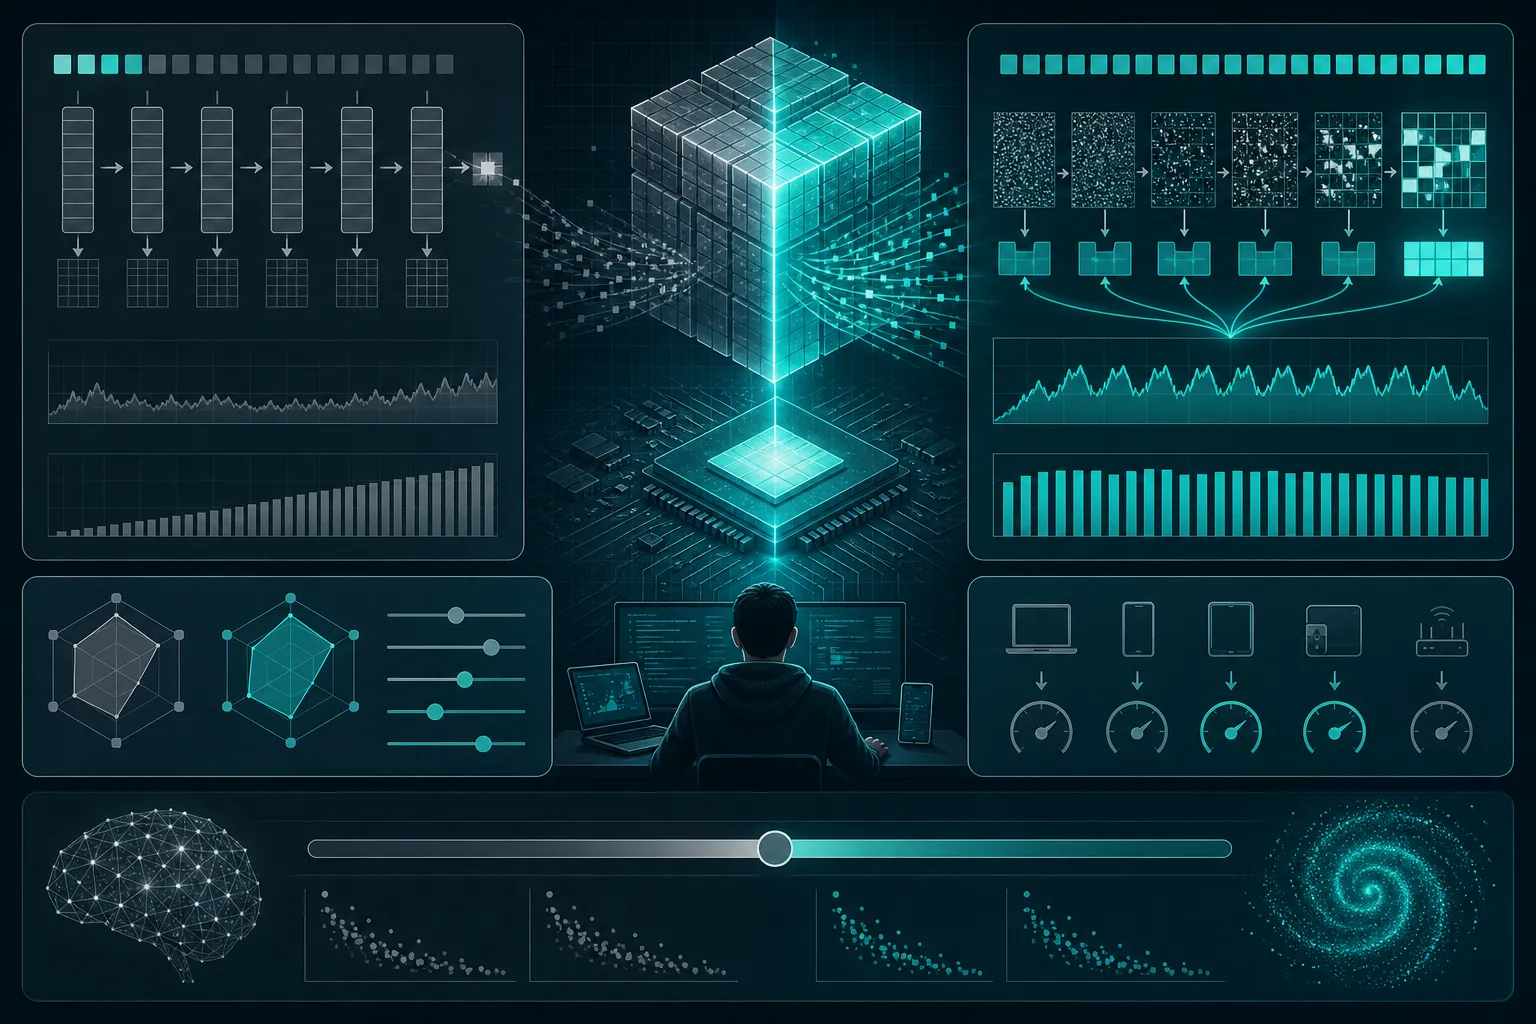
Google DeepMind opisał 31 lipca DiffusionGemmę, eksperymentalny model, który zamiast pisać token po tokenie bierze cały blok 256 tokenów jako szum i w kilku przejściach wygładza go w tekst. Na jednej karcie H100 daje to około 1500 tokenów na sekundę, bo odsłania średnio 20 tokenów na przejście zamiast jednego. To dostrojona Gemma 4 w wariancie mixture-of-experts, przerobiona na model dyfuzyjny za mniej niż 10% pierwotnego budżetu tokenów i wypuszczona z otwartymi wagami. Tyle że raport chwali się prędkością, a nie podaje ani jednej liczby, ile jakości kosztuje szybki tryb dyfuzyjny.
 Model / Badania
Liquid AI zmieścił agenta w 2,5 GB i puścił go bez chmury
4 min
Liquid AI wypuściło 4 sierpnia LFM2.5-2.6B, model o 2,6 miliarda parametrów, który mieści się w niecałych 2,5 GB i działa lokalnie na laptopie, telefonie czy Raspberry Pi, bez ani jednego zapytania do chmury. Kluczowa jest metoda: model dotrenowano wprost w harnessie agenta i nagradzano za faktyczny wynik, dzięki czemu na teście ToolSandbox wyprzedził trzykrotnie większego Qwen3.5-9B, choć na BFCLv4 już przegrywa. Skoro nie płacisz za tokeny do API, każde uruchomienie kosztuje zero, a firma otwarcie przyznaje, że do trudniejszych zadań programistycznych lepszy bywa większy model.
 Model / Badania
Kimi K3 prowadzi w kodowaniu i przedstawia się jako Claude
5 min
Kimi K3 od chińskiego Moonshot AI wskoczył na pierwsze miejsce w kodowaniu frontendu, 1679 punktów wobec 1631 dla Claude Fable 5. Liczy 2,8 biliona parametrów, ale dzięki rzadkiej mieszance ekspertów przy każdym tokenie pracuje tylko 16 z 896 podsieci, więc rachunek za inferencję jest bliższy modelowi stumiliardowemu. Ciągnie się za nim zarzut destylacji, bo świeży K3 przedstawiał się jako Claude, a Anthropic oskarża Moonshot o przepuszczenie przez Claude'a 3,4 miliona wymian, choć dla kogoś, kto chce tanio generować dobry kod, otwarte wagi ważą więcej niż pochodzenie trenowania.
Tydzień 31 · 27 lipca – 2 sierpnia 2026
 Model / Badania
OpenAI ścina Lunę o 80% i przesuwa opłacalność na tanią półkę
4 min
Od 30 lipca OpenAI ścina cenę modelu Luna o 80%, do 20 centów za milion tokenów na wejściu i 1,20 dolara na wyjściu, a Terra tanieje o 20%. Sol zostaje bez zmian. Oszczędności wzięły się stąd, że pod okiem ludzi Sol przepisał niskopoziomowy kod serwujący model na kartach graficznych i obniżył koszt jego działania o 20%. Przy tej cenie układ, w którym drogi model planuje, a tani wykonuje, przestaje być sztuczką optymalizatorów i staje się domyślny, bo strona wykonawcza kosztuje grosze.
 Model / Badania
Nanbeige twierdzi, że jego model 3B ogrywa w agentowych testach rywali cztery razy większych
4 min
Nanbeige Lab twierdzi w pracy na arXiv z 24 lipca, że jego Nanbeige4.2-3B z 3 miliardami parametrów bije w zadaniach agentowych trzy i cztery razy większych rywali, Qwen3.5-9B i Gemma4-12B. Sztuczka to Looped Transformer: te same warstwy przepuszczane kilka razy z rzędu dają głębię rozumowania bez wzrostu liczby parametrów, a zysk jest w pamięci, nie w szybkości. Mały w użyciu, ale nie tani w budowie, bo trenowano go od zera na 28 bilionach tokenów. Liczby podaje samo laboratorium, bez konkretnych wartości w abstrakcie, więc do hasła o pobiciu większych dokładam spory znak zapytania.
 Model / Badania
Po co model ponad trzy razy większy, skoro mniejszy programuje lepiej?
3 min
Thinking Machines Lab wypuściło Inkling-Small, model z otwartymi wagami, który przy każdym tokenie uruchamia tylko 12 miliardów z 276 miliardów parametrów, a mimo to dorównuje ponad trzy razy większemu Inklingowi i wyprzedza go na kodzie, 80,2% wobec 77,6% na SWEBench Verified. Przewagę dało nie skalowanie, tylko dwa dodatkowe tygodnie treningu pod agentowe programowanie. Cena jest jedna: na wiedzy o świecie mniejszy model wyraźnie odstaje, 20,6% do 43,9% na SimpleQA. Mniej aktywnych parametrów oznacza też niższy rachunek za każdą odpowiedź.
 Model / Badania
Ant Group rozdaje Ling-3.0-Flash za darmo do 3 sierpnia, wagi obiecuje wkrótce potem
3 min
Ant Group, firma stojąca za Alipay, wystawiła lekki model Ling-3.0-Flash za darmo na OpenRouter do 3 sierpnia 2026, a otwarte wagi obiecuje wkrótce potem. Model trzyma natywnie 256 tysięcy tokenów kontekstu, rozciąga się do miliona i przy każdym tokenie liczy tylko ułamkiem swoich podsieci, dzięki czemu reklamuje się pod agenty do kodu i pracy z narzędziami. Siedem firmowych nagrań pokazuje wyłącznie udane przebiegi, więc darmowy dostęp i zapowiedź otwartych wag to jedyny fragment tej premiery, którego nie trzeba brać na wiarę.
 Model / Badania
Samoewolucja M2.7? Pod spodem sto rund prób i błędów
3 min
MiniMax wypuścił M2.7 i oparł całą premierę na jednym słowie: samodoskonaleniu. Pod spodem kryje się pętla ponad stu rund, w których model sam przepisywał kod swojego harnessu, odpalał testy i cofał nieudane zmiany, aż wyciągnął 30% poprawy na wewnętrznych zestawach. Na MLE Bench Lite od OpenAI zdobył średnio 66,6% medali, za Opusem 4.6 (75,7%) i GPT-5.4 (71,2%), a w samym kodowaniu ma 56,22% na SWE-Pro. Problem w tym, że wszystkie te liczby zmierzył sam MiniMax, bez niezależnej weryfikacji.
 Model / Badania
Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych
3 min
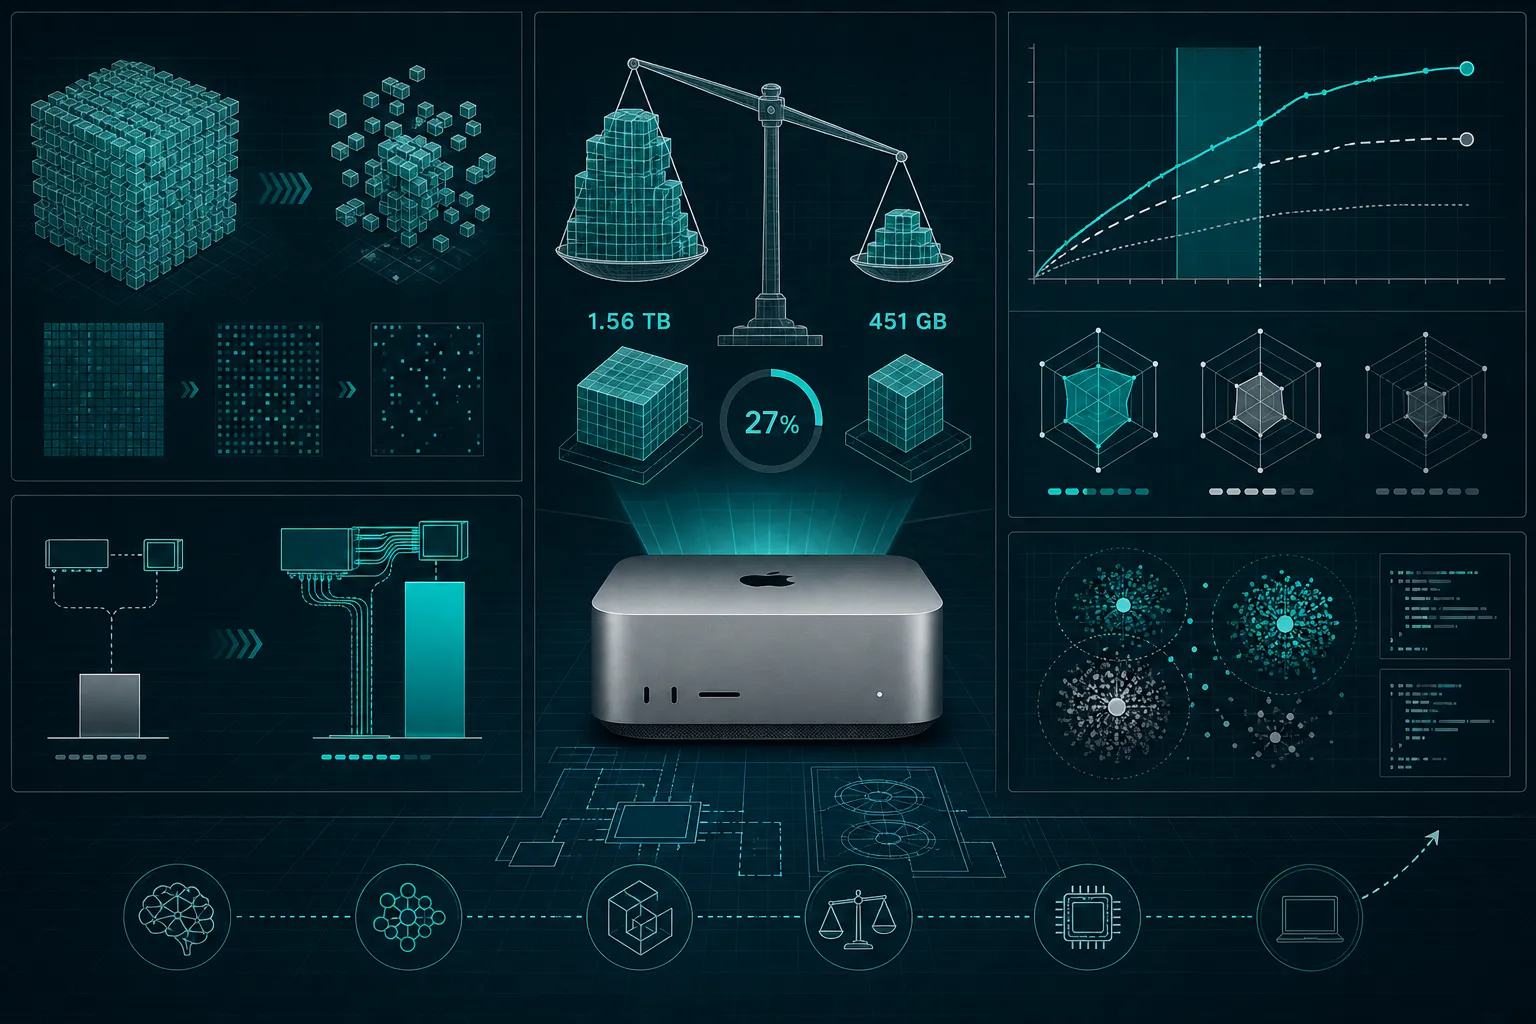
Niezależny projekt PipeNetwork udostępnił wersję chińskiego modelu Kimi K3, która wchodzi na jeden Mac Studio: 451 GB zamiast 1,56 TB, ładowana w 62 sekundy. Sztuczka to metoda REAP od Cerebras, która wycina większość ekspertów mieszanki (z 896 do 242 na warstwę), oszczędzając akurat te od kodu, więc uzupełnianie kodu przechodzi cięcie niemal bez szwanku, choć model częściej gubi wątek. Najciekawsze nie jest jednak samo cięcie, tylko to, że autor złapał własny błąd pomiarowy zaniżający wydajność 39 razy (0,14 zamiast 5,51 tok/s) i publicznie go sprostował.
 Model / Badania
Laguna S 2.1 bije modele kilkanaście razy większe i pokazuje zapisy
3 min
Laguna S 2.1 od Poolside dostała 40,4% na benchmarku DeepSWE, cztery razy więcej niż kilkanaście razy większy DeepSeek V4 Pro Max, a firma opublikowała pełne zapisy każdej próby, żeby liczbę dało się sprawdzić samodzielnie. Model ma 118 miliardów parametrów, ale na każdy token uruchamia tylko około 8 miliardów, więc wywołanie przez API kosztuje 0,10 dolara za milion tokenów na wejściu, jakieś 50 razy mniej niż Claude Opus 5. To wąski specjalista wyłącznie od kodu, bez niezależnego wskaźnika ogólnej inteligencji, a wynik trzyma się tylko z włączonym trybem myślenia, bo bez niego spada do 16,5%.
Tydzień 30 · 20–26 lipca 2026
 Model / Badania
Anthropic wypuścił Claude Opus 5, a migracja to głównie kasowanie instrukcji
3 min
Anthropic wypuścił w piątek 24 lipca Claude Opus 5, w tej samej cenie co Opus 4.8, a najważniejsza zmiana leży nie w specyfikacji, lecz w tym, że migracja promptów sprowadza się do kasowania zabezpieczeń dopisywanych dla słabszych modeli. Skoro model według producenta sam sprawdza swoją pracę, instrukcje typu "zweryfikuj wynik" czy rozbijanie roboty na podagentów zaczynają teraz szkodzić i przepalać tokeny. Parametr effort dostał pięć poziomów, powyżej high nie da się już wyłączyć myślenia, a przy myśleniu zgaszonym model potrafi wpisać wywołanie narzędzia jako tekst, zamiast je wykonać.
 Model / Badania
Poolside wypuszcza model do kodu, który mieści się na jednej maszynie
4 min
Poolside wypuściło Lagunę S 2.1, model do kodu z otwartymi wagami, który mimo 118 miliardów parametrów uruchamia na token tylko 8 miliardów i mieści się na jednej maszynie, a skwantyzowany schodzi do jakichś 40 GB. Na Terminal-Bench 2.1 dostał 70,2%, tyle co modele wielokrotnie od niego większe, ale na trudniejszym DeepSWE ma już 40,4%, daleko za Claude Fable 5 z 70%, i pod presją zaczyna zmyślać. Nie chodzi o to, że mały bije dużego, tylko że "dość dobry, żeby mieć go na własność" to już realna półka w agentowym kodowaniu.
 Model / Badania
Google przyznaje, że przegrywa w kodowaniu, a zamiast flagowca wypuszcza tańszy model
4 min
Sundar Pichai na telekonferencji wynikowej przyznał, że Google wypada słabiej w kodowaniu i kodowaniu agentowym. Flagowy Gemini 3.5 Pro, planowany na czerwiec, wciąż się nie pojawił, bo jego wyniki w programowaniu rozczarowały. Zamiast niego Google wypuściło tańsze modele Flash, z Gemini 3.6 Flash na czele, który na benchmarku DeepSWE zużywa do 65% mniej tokenów i podniósł wynik z 37% do 49%. Prawdziwy problem to jednak nie harmonogram premier, tylko brak własnego narzędzia do kodu zbierającego dane o tym, jak ludzie realnie programują z modelem.
 Model / Badania
Liquid AI powiększył słownik modelu po treningu, żeby przyspieszyć języki azjatyckie
3 min
Liquid AI pokazało, że słownik tokenizera w gotowym modelu można powiększyć już po treningu, w miejscu, zamiast trenować wszystko od zera. Nowy algorytm skleja dotychczasowe tokeny w większe i przywraca jakość dwuetapowym douczaniem. Powstały model LFM2.5-8B-A1B ma słownik 128 tysięcy tokenów i koduje tajski nawet czterokrotnie oszczędniej, a hindi i wietnamski około dwuipółkrotnie. Autorzy szacują, że tekst w tych językach powstaje od 2,2 do 3,7 raza szybciej, choć to wyliczenie, a nie stoper włączony na prawdziwym telefonie.
 Model / Badania
Wyspecjalizowany Gemini znajduje więcej luk niż Opus 4.6
4 min
Google DeepMind pokazał w zeszły wtorek Gemini 3.5 Flash Cyber, mały model wyostrzony pod jedno zadanie: szuka luk w cudzym kodzie, sam buduje działający exploit w piaskownicy, żeby odsiać fałszywe alarmy, i dopiero potem pisze łatkę. Na silniku JavaScriptu V8 wskazał 55 potwierdzonych błędów, wobec 47 od zwykłego 3.5 Flash i 36 od Claude Opus 4.6, bo nowszym rywalom w szukaniu luk przeszkadzają ich własne zabezpieczenia. Google wypuszcza go jednak wyłącznie dla rządów i zaufanych partnerów, więc najlepsze narzędzie tygodnia jest zarazem tym, do którego dostęp ma garstka.
 Model / Badania
Koreański Motif-3 ma 314 miliardów parametrów i licencję, która nie pozwala go użyć
3 min
Koreańska Motif Technologies wrzuciła na Hugging Face model Motif-3 Beta: 314 miliardów parametrów w architekturze MoE, z których na token pracuje tylko około 13 miliardów, plus natywne okno 256 tysięcy tokenów. Niezależny pomiar Artificial Analysis daje mu 44 punkty przy medianie 15 i 34. miejsce wśród 577 systemów, choć odpowiada, gadając znacznie więcej od konkurencji. Tyle że wagi, mimo że otwarte do pobrania, wolno wykorzystywać wyłącznie niekomercyjnie, a produkt postawisz na nich dopiero po pisemnej zgodzie. Model, którego nie wdrożysz, jest ciekawostką, nie narzędziem.
 Model / Badania
Chiński model wygrał ranking kodowania. Co pokazały pierwsze niezależne testy?
5 min
Kimi K3, chiński model z otwartymi wagami, wygrał frontendowy ranking Areny o 48 punktów przed Claude Fable 5, ale pierwsze niezależne testy prostują ten obraz. Jessica Wachtel z The New Stack dała obu to samo zadanie na narzędziu fd: diffy wyszły co do bajta identyczne, tylko K3 kosztował jedną trzecią ceny i był kilka razy wolniejszy, całość zajęła mu 28 minut zamiast siedmiu. Jego wskaźnik halucynacji skoczył za to do 51 procent, a uruchomienie go u siebie wymaga 64 kart graficznych, więc realną alternatywą na dziś zostają GLM 5.2 i DeepSeek V4 Pro.
Tydzień 29 · 13–19 lipca 2026
 Model / Badania
Największy otwarty model świata jest już na szczycie, tylko nie uruchomisz go w domu
5 min
Chiński Moonshot AI wypuścił 16 lipca Kimi K3, który tego samego dnia stanął na szczycie Frontend Code Arena z wynikiem 1 679 punktów, 48 oczek przed Claude Fable 5. Z 2,8 biliona parametrów to największy model z otwartymi wagami w historii, ale nikt nie odpali go w domu: pełne wagi zajmą około 1,7 TB, a agresywna kompresja nie schodzi poniżej 650 GB. Znaczenie i tak jest realne, bo otwarte wagi spłaszczają marże, dają wybór, gdzie liczyć, i uczą mniejsze modele przez destylację. Wagi, licencję i raport techniczny obiecano na 27 lipca.
 Model / Badania
Model, którego nikt nie nauczył oszczędzać własnego myślenia
4 min
Ring-Zero, praca zespołu InclusionAI z chińskiego Ant Group z 14 lipca, to pierwszy udokumentowany przypadek dociągnięcia trenowania zero RL, które pomija etap uczenia na ludzkich przykładach, aż do biliona parametrów bez rozsypania procesu. Model wykształcił przy tym pięć zachowań, których nikt nie zaprogramował i które ujawniają się dopiero w tej skali, w tym "context anxiety": sam zerka na resztki okna kontekstowego i skraca własne rozumowanie. Ring-2.5-1T-Zero notuje 84,2% na AIME 2026, ale wszystkie wyniki pochodzą od samego twórcy i nikt niezależny ich nie potwierdził.
 Model / Badania
Pierwszy model Miry Murati nie wygrywa benchmarków. I dobrze.
4 min
Mira Murati pokazała Inkling, pierwszy model laboratorium Thinking Machines Lab, i od razu przyznała, że nie jest najmocniejszy. Wagi wyszły na czystej licencji Apache 2.0, a pod spodem działa mixture of experts z 975 mld parametrów, z których na token pracuje tylko 41 mld, z oknem kontekstowym do miliona tokenów. Na SWE-Bench Verified dostaje 77,6%, powyżej amerykańskiego Nemotrona 3 Ultra, ale poniżej chińskich liderów DeepSeek V4 Pro i GLM 5.2. Sensem jest rzadki, naprawdę otwarty amerykański model dla zespołów gotowych dostroić go na własnym klastrze GPU z 2 TB pamięci.
 Model / Badania
Needle sprowadza wybór funkcji z chmury na urządzenie
3 min
Cactus-Compute wypuściło Needle, model z otwartymi wagami, który robi na urządzeniu jedno: z pytania użytkownika i listy funkcji wybiera, którą wywołać i z jakimi argumentami. Powstał przez destylację Gemini 3.1 do zaledwie 26 milionów parametrów, na architekturze enkoder-dekoder bez warstw feed-forward, dzięki czemu decyzja o wyborze narzędzia zostaje na telefonie i nic nie trafia do chmury. Karta modelu daje pełną przejrzystość i licencję MIT, ale ani jednej liczby o skuteczności, więc trafność sprawdzisz sam na własnym zestawie funkcji, dotrenowując model w 45 minut.
 Model / Badania
Model do RAG, który zmieści się na jednej karcie
3 min
NVIDIA wypuściła 16 lipca Nemotron-3-Embed-1B, model osadzeń do RAG, którego atutem nie jest jakość, tylko rozmiar: 1,14 miliarda parametrów mieści się na jednej karcie GPU, więc cały etap wyszukiwania po dokumentach można trzymać u siebie, razem z danymi. Wersja ściśnięta do 4 bitów traci na benchmarku RTEB ledwie 0,38 punktu, a wektor da się obciąć z 2048 do 512 liczb, oszczędzając miejsce w bazie wektorowej. Wśród 34 przetestowanych języków nie ma jednak polskiego, więc jakość na polskich dokumentach trzeba sprawdzić samemu.