Wydanie · Tydzień 40 · 28 września – 4 października 2026
Archiwum wydań →MCP przestało być eksperymentem i stało się instalacją, na której stawia się resztę: Uber chowa przed agentem pięć tysięcy narzędzi, Pi przyjmuje protokół, który odrzucało, a OpenAI, Anthropic i AWS budują na nim sklepy z wtyczkami i doradców. Teraz pytanie brzmi, ile z tego agent powinien widzieć naraz.
Premiera / Narzędzie · 20
 Premiera / Narzędzie
Uber chowa przed agentami katalog pięciu tysięcy narzędzi
4 min
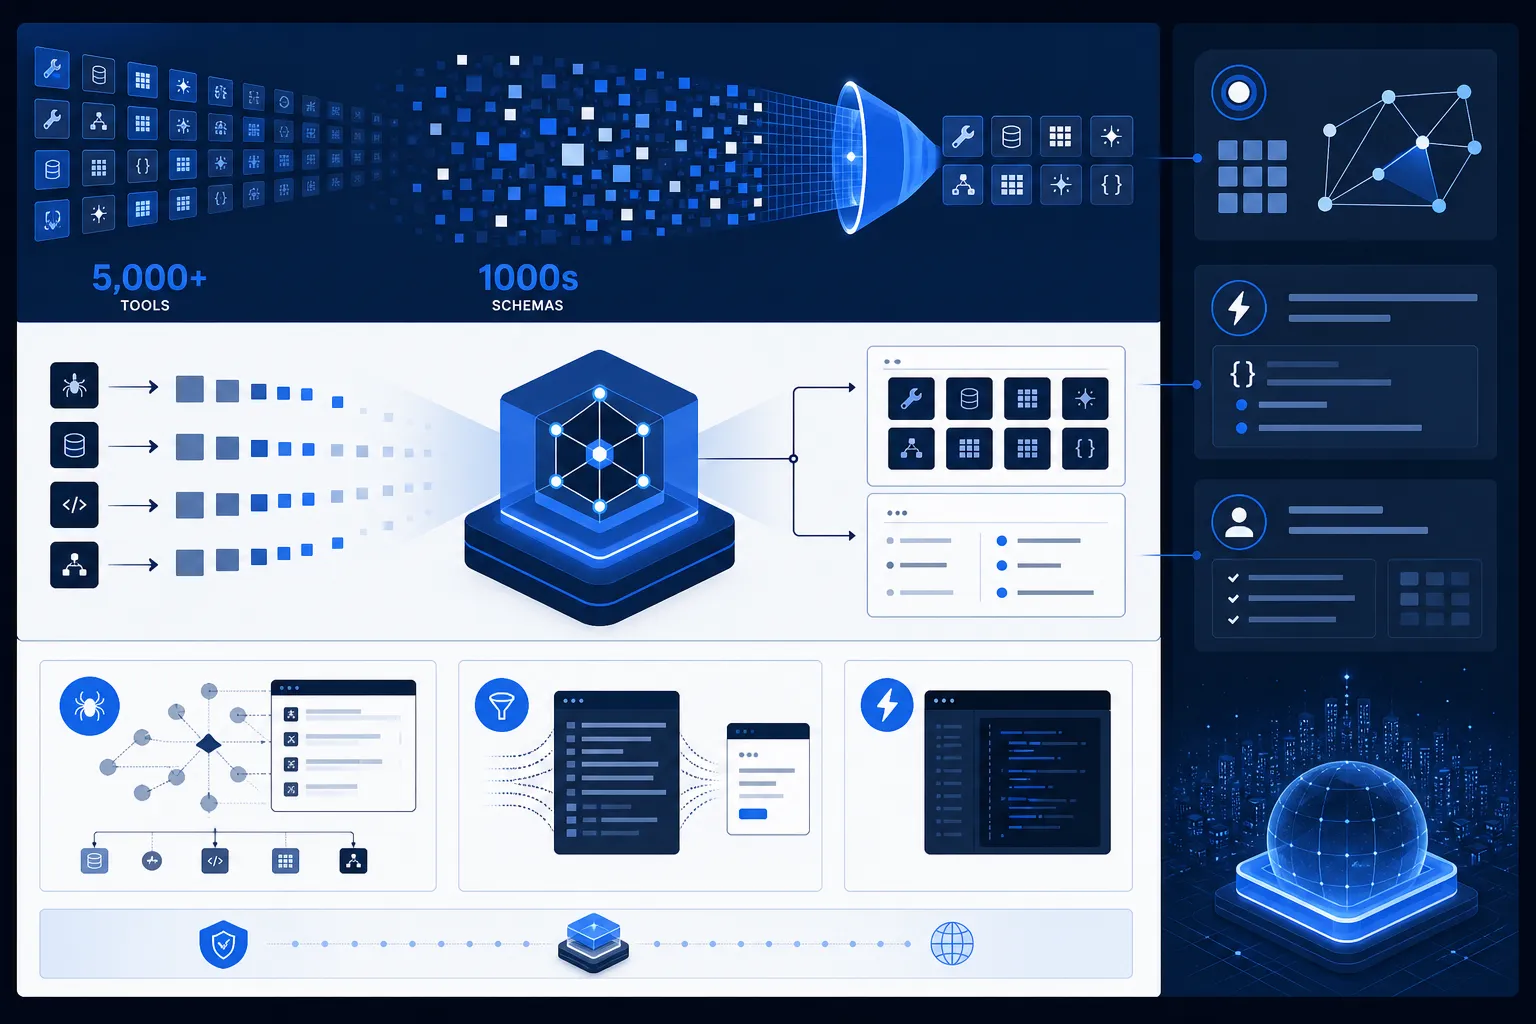
Uber ma w produkcji ponad 800 serwerów MCP z 5 tysiącami narzędzi, więc agent, który dostałby pełny katalog, utonąłby w opisach, zanim przeczytałby polecenie. Dlatego na start dostaje tylko cztery narzędzia: do znalezienia serwera, przejrzenia jego narzędzi, pobrania schematu i wywołania, a z odpowiedzi usługi bierze wyłącznie potrzebne pola. Każde narzędzie opisane automatycznie przez model językowy trafia do katalogu wyłączone, dopóki nie włączy go zespół właściciela usługi. Ten sposób warto skopiować nawet przy dziesięciu narzędziach.
 Premiera / Narzędzie
Pi 1.0 przyjęło MCP, które przez miesiące odrzucało
4 min
Pi, otwartoźródłowy agent do pisania kodu Mario Zechnera, przez miesiące odrzucał MCP, bo opisy narzędzi zajmują kontekst modelu, a sam serwer Playwrighta zjadał na starcie około 13,7 tys. tokenów. Pi 1.0, które trafiło na szczyt Hacker News, obsługuje już protokół przez Codemode, czyli model pisze skrypt w JavaScripcie uruchamiany w piaskownicy, dzięki czemu do rozmowy wraca tylko wynik. Uważam ten zwrot za przemyślany, choć nikt jeszcze nie zmierzył, ile tokenów to realnie oszczędza.
 Premiera / Narzędzie
Planista w chmurze i wykonawcy na karcie graficznej w Antigravity SDK
3 min
23 września Google dodał do Antigravity SDK obsługę modeli działających na własnym komputerze, na start Gemmy 4 26B na silniku LiteRT, ale też Ollamy czy LM Studio. W pokazie Gemini 3.8 Flash w chmurze rozplanował łatanie trzech modułów, widząc tylko nazwy plików i zużywając 95 tokenów, a kod poprawiały lokalne kopie Gemmy, więc nie opuścił maszyny. Dla firm, które nie mogą wysyłać kodu na zewnątrz, to rozsądny kierunek, choć pokaz jest skromny, a sprzęt potrzebuje ponad 24 GB pamięci karty graficznej.
 Premiera / Narzędzie
Jevgrep szuka kodu za agenta. Ile naprawdę na tym oszczędzasz?
4 min
Jevgrep, narzędzie wiersza poleceń wypuszczone przez Davida Zhanga 26 września, szuka kodu po opisie jego zachowania, a o trafności wyników decyduje osobno płatny model Jev firmy TypeSafe AI. Obiecane 40% oszczędności okupiono gorszym wynikiem na SWE-bench, więc uczciwą liczbą jest 25,8% z powtórki na wersji 0.4.3, liczone razem z opłatami za Jev, choć tylko na dziesięciu zadaniach. Wersja 0.5 przerzuca część pracy z powrotem na agenta, przez co przy rozliczaniu za tokeny wychodzi o 2 do 3% drożej, a fragmenty kodu i tak trafiają do zewnętrznego modelu.
 Premiera / Narzędzie
Pasek boczny, panel i przeglądarka plików: co OpenAI dało twórcom pluginów
4 min
Od DevDay 29 września plugin w ChatGPT może mieć własne okno: miejsce w pasku bocznym, panel obok rozmowy i przeglądarkę plików wybranego typu, na przykład modeli STL do druku 3D. Rozszerzenia opierają się na MCP i MCP Apps, a OpenAI dokłada do nich własne metadane oraz usługę Sites, która uruchamia serwer MCP w jego chmurze. To kolejne podejście firmy do sklepu z aplikacjami, więc serwer MCP traktowałbym jako część przenośną, a warstwę OpenAI robiłbym możliwie cienką, z klientem i rozliczeniami po swojej stronie.
 Premiera / Narzędzie
Anthropic otwiera portal dla autorów wtyczek do Claude'a
3 min
Od 25 września autorzy wtyczek do Claude'a mogą zgłaszać je do katalogu przez nowy portal Anthropica, a sama wtyczka łączy w jedną paczkę konektory MCP i Agent Skills. Dla autora liczy się głównie to, co widzi po publikacji: liczbę instalacji w podziale na produkt i wersję, wyświetlenia strony w katalogu i wyszukiwania, które do niej prowadzą. Zgłoszenie przechodzi automatyczny skan bezpieczeństwa i przegląd, tyle że ogłoszenie nie mówi, co sprawdza skan ani ile trwa przegląd, a liczby wtyczek w katalogu Anthropic nie podaje.
 Premiera / Narzędzie
Cursor rysuje odpowiedź w czacie. Najlepiej wychodzi mu tłumaczenie własnych zmian
3 min
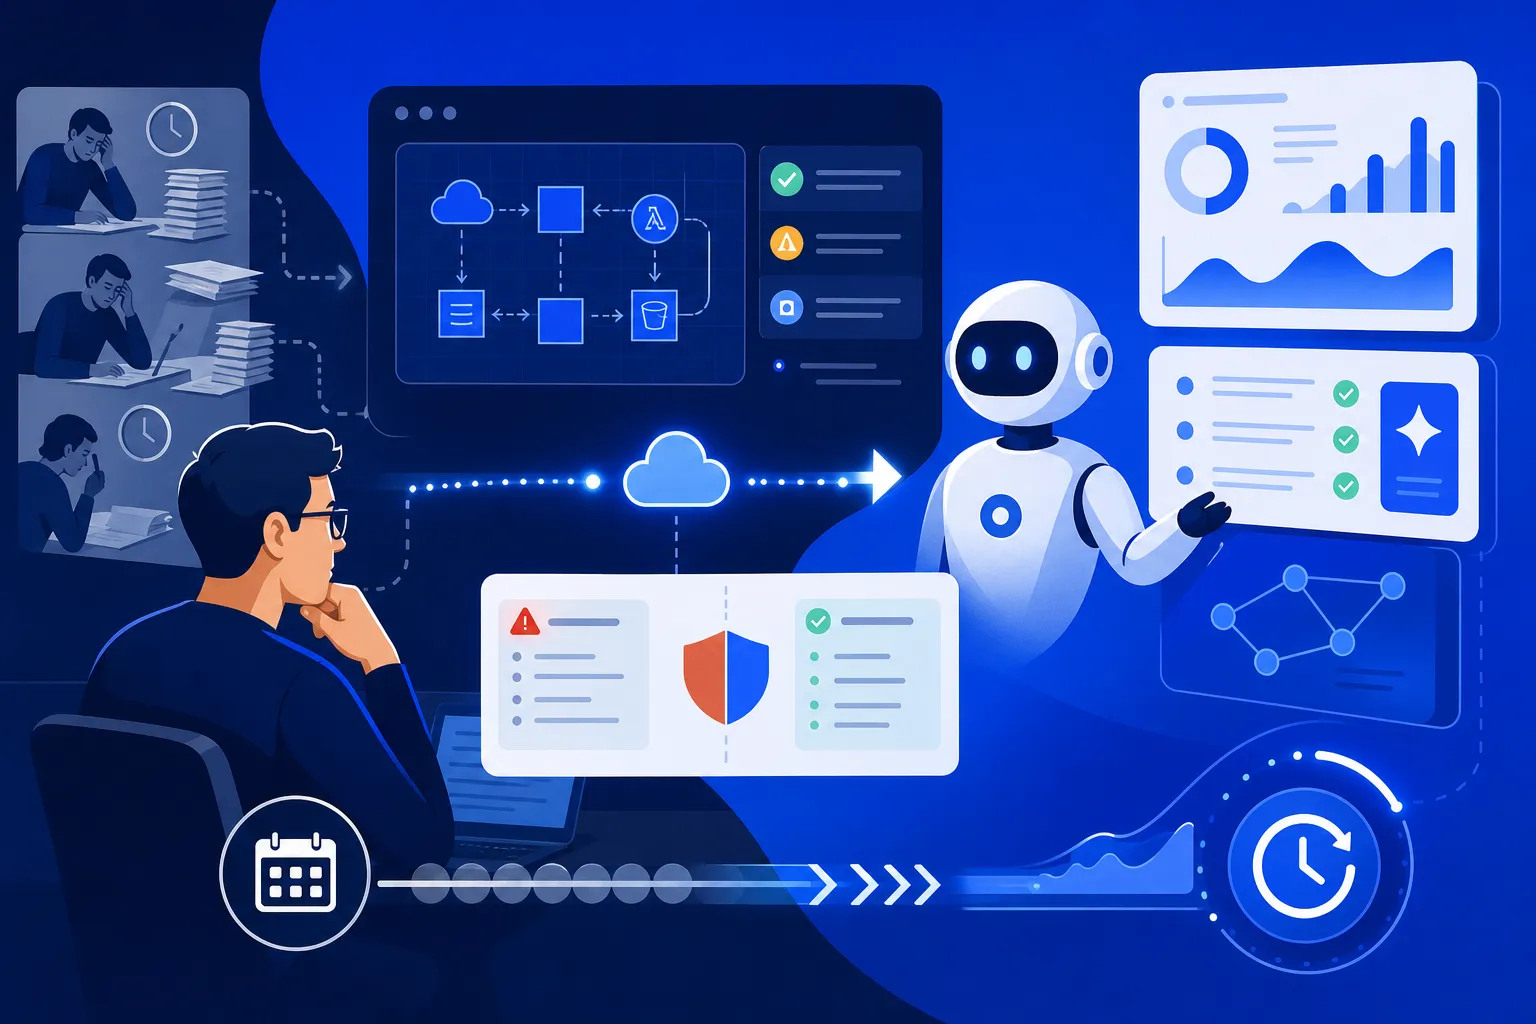
Cursor od 29 września rozumie komendę /visualize, po której agent odpowiada wykresem albo diagramem wstawionym prosto w czat, co jest lżejszą wersją kwietniowych paneli z wersji 3.1. Najlepiej sprawdza się przy tłumaczeniu własnych zmian: użytkowniczka @fredrikalindh pokazała agenta, który krok po kroku rozrysowuje, co przestawił w kodzie. Ładny diagram nie jest jednak dowodem, więc rozsądnie jest kazać agentowi oddzielić połączenia potwierdzone w kodzie od tych, które tylko zakłada.
 Premiera / Narzędzie
Agent AWS przejrzy twoją chmurę, ale nie zna powodów, dla których wygląda tak, a nie inaczej
4 min
Amazon Web Services udostępniło 1 października w wersji testowej AWS Well-Architected Agent, który przegląda konto w chmurze, ocenia ponad 65 usług i wycenia proponowane poprawki w dolarach, a przy większych problemach podsuwa gotową zmianę w plikach Terraform albo CloudFormation. Zalecenia mogą trafić przez serwer MCP prosto do edytora. Agent widzi każdy zasób, ale nie zna powodów, dla których system wygląda tak, a nie inaczej, i doradza w sprawie usług, które AWS sam sprzedaje, dlatego na początek dałbym mu wyłącznie prawo do czytania.
 Premiera / Narzędzie
Microsoft wpuszcza agenta na całą dobę do Teams i Outlooka, ale silnik ma cudzy i dziurawy
5 min
Autopilot, nowy agent Microsoftu pracujący całą dobę w Teams i Outlooku, to przemianowany Scout zbudowany na otwartym frameworku OpenClaw, w którego wdrożeniach zgłoszono już ponad 138 podatności, w tym CVE-2026-32922 z oceną 9,9 na 10. Microsoft daje każdemu agentowi osobną tożsamość w Entra i wymaga zgody administratora, ale nie mówi, czy najgroźniejsze dziury załatano. Kto pisze integracje z Microsoft 365, musi przyciąć agentom uprawnienia i przygotować się na to, że Microsoft Graph będzie odpytywany także w nocy i w weekendy.
 Premiera / Narzędzie
JetBrains Air: trafna diagnoza, cienka oferta
4 min
JetBrains 22 września ogłosił Air, zestaw produktów, który ma objąć pracę agentów AI w całej firmie, a nie tylko w IDE. Diagnoza jest trafna: kod tanieje, a drożeje jego sprawdzanie, za które wciąż odpowiadają ludzie, więc lepszy model nie ustali zasad ani nie policzy kosztów. Oferta jest jednak cienka, bo Air Governance to marcowy Central pod nową nazwą, wpis nie mówi, co działa już dziś, a obietnica tańszych i dokładniejszych agentów dzięki analizie kodu w IDE nie ma za sobą ani jednej liczby.
 Premiera / Narzędzie
Eleven v4 od ElevenLabs: głos, który słucha poleceń zapisanych w nawiasach
4 min
ElevenLabs wypuściło pod koniec września Eleven v4, model mowy z emocjami, oraz jego szybszą odmianę Turbo dla agentów głosowych rozmawiających na żywo. Sposób mówienia wpisuje się wprost w tekst poleceniami w nawiasach, takimi jak [laughs] czy [light rain], więc reżyserię może pisać ten sam model językowy, który układa odpowiedź agenta. Turbo potrzebuje około 150 ms do pierwszego słyszalnego dźwięku, ale to pomiar samego producenta bez łącza użytkownika, a wśród próbek w ogłoszeniu nie ma ani jednej po polsku.
 Premiera / Narzędzie
Google Cloud API Gateway wystawia istniejące API agentom bez osobnego serwera MCP
4 min
Google ogłosiło 24 września, że Cloud API Gateway w wersji testowej sama udaje serwer MCP, więc istniejące API trafia do agentów jako narzędzia po dopisaniu kilku adnotacji w pliku OpenAPI 3.0 lub 3.1. Wywołania agenta przechodzą przez te same tokeny, limity i dzienniki co ruch z aplikacji, dzięki czemu odpada osobny serwer, ale agent w pętli zjada też limit klientów. Prawdziwa praca to opisy operacji, z których model wnioskuje, kiedy sięgnąć po narzędzie, a listę narzędzi, domyślnie otwartą dla każdego, trzeba zamknąć tokenem JWT.
 Premiera / Narzędzie
Agent w Android Studio na twój abonament, a nie na abonament Google
4 min
W testowej wersji Rabbit 2 Android Studio wpuszcza do środka cudzych agentów, więc obok Antigravity od Google można wybrać Claude Agent od Anthropica albo Codex od OpenAI i zalogować się własnym planem lub kluczem API, o ile pozwala na to dostawca. Działa to dzięki otwartemu Agent Client Protocol, przez co każdy zgodny agent podłączy się bez osobnej wtyczki. Google jednocześnie zaleca przejście z wbudowanego Gemini na Antigravity z płatnym planem AI Pro lub Ultra, a obietnice szybszej i tańszej pracy nie mają za sobą żadnych liczb.
 Premiera / Narzędzie
Mody w Claude Code: własny kod w środku pętli agenta
5 min
Anthropic opisał mody do Claude Code, czyli małe pliki w JavaScripcie lub TypeScripcie, które ładują się do sesji i mogą każde zdarzenie przepuścić, przepisać albo zatrzymać. Moim zdaniem najwięcej dają te, które pokazują pracę agenta, jak Token Weather z prognozą zapełnienia okna kontekstowego czy Replay Theater z powtórką edycji po kolei. Blast Radius zatrzymuje komendy w rodzaju rm -rf, ale czyta tylko ich tekst, więc łatwo go obejść, co Anthropic sam przyznaje. Mody działają z twoimi uprawnieniami, dlatego cudzy kod trzeba przeczytać przed instalacją.
 Premiera / Narzędzie
Dwie warstwy pilnowania agentów AI i tylko jedna na twoim laptopie
5 min
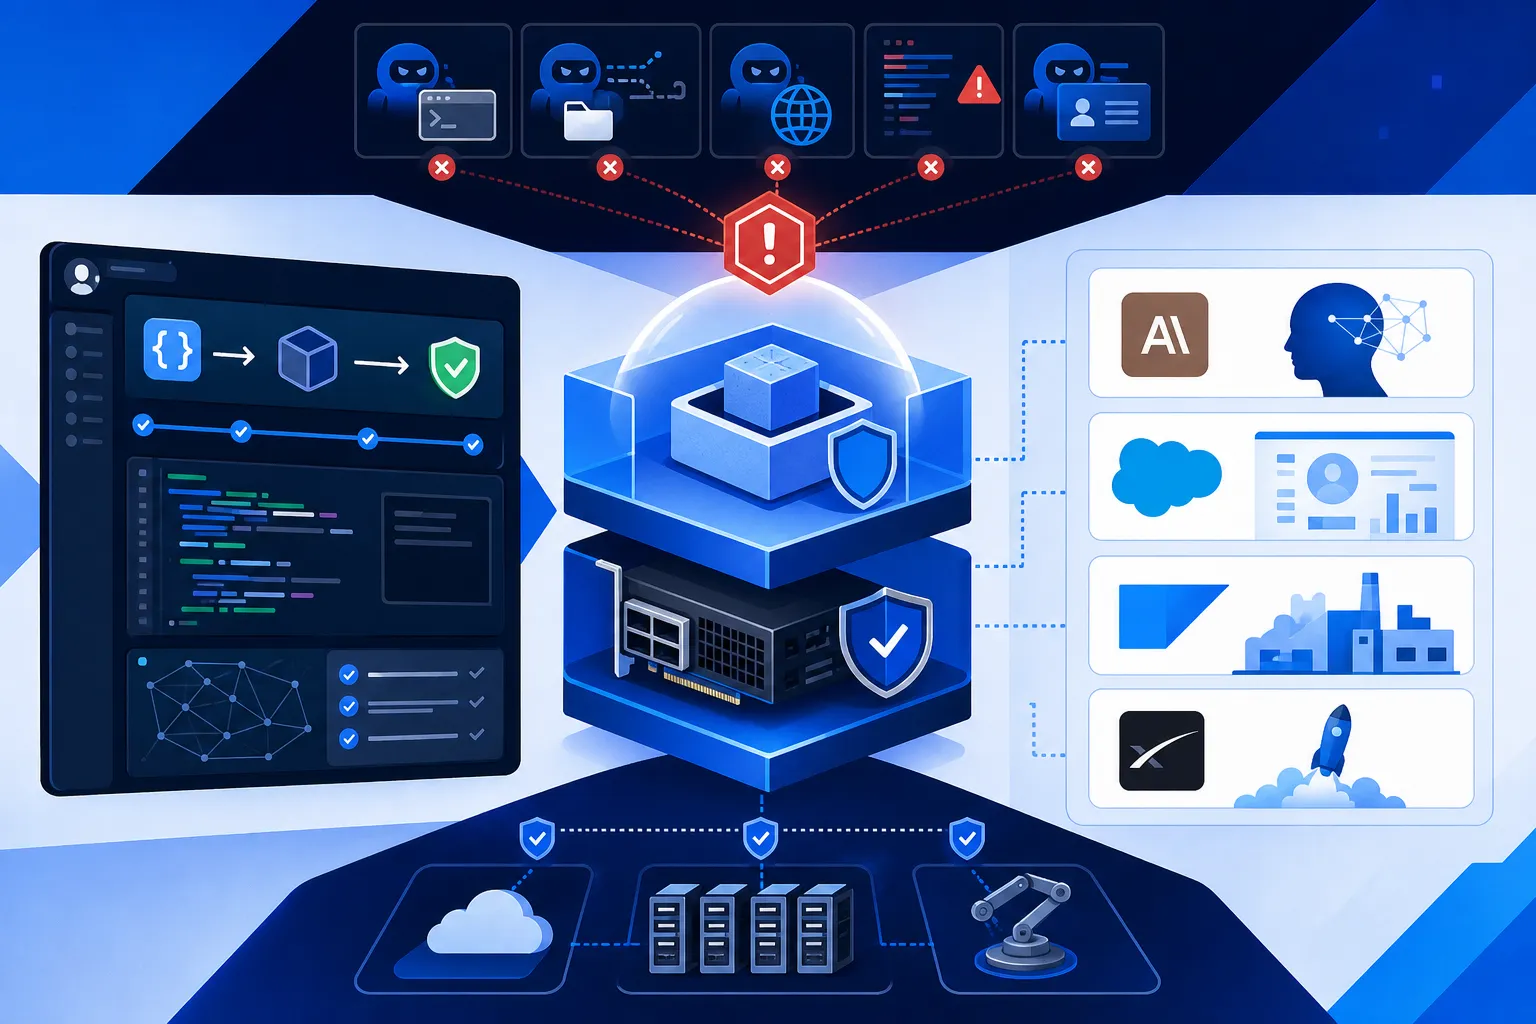
NVIDIA odpowiada na serię wpadek agentów AI, od bazy danych skasowanej w dziewięć sekund po włamanie do Hugging Face, platformą Open Agent Safety Platform, która przenosi pilnowanie agenta poza jego zasięg. Pierwsza warstwa, otwarty OpenShell na licencji Apache 2.0, zamyka każdego agenta w piaskownicy na poziomie jądra systemu i działa też na zwykłej stacji roboczej. Druga, Sentry, wymaga kart BlueField-4 w serwerach Vera Rubin, więc deweloper bez własnej serwerowni dostaje tylko połowę ochrony, a lista ponad 100 partnerów to w dużej mierze same logotypy.
 Premiera / Narzędzie
Kiedy poprawka promptu naprawdę coś daje? Claude Code dostał narzędzie, które to mierzy
4 min
Claude Code dostał w skillu claude-api dwie komendy: build-eval buduje zestaw testów z prawdziwych rozmów i zgłoszeń, a hillclimb poprawia aplikację krok po kroku i cofa każdą zmianę, która nie pomaga na odłożonej, niewidzianej puli przypadków. Na 44 zgłoszeniach do obsługi klienta wynik na zakrytej puli wzrósł z około 11 do prawie 13 na 14 przy jednej piątej kosztu, choć oszczędność przyniosła głównie przesiadka na Sonnet 5. Najcenniejsze jest jednak to, że narzędzie umie przyznać, że poprawka nic nie dała, i wskazać zepsuty test.
 Premiera / Narzędzie
Stainless zniknął, a Cloudflare oddaje za darmo własny generator bibliotek do API
4 min
Od 1 września nie działa Stainless, usługa generująca biblioteki do API dla OpenAI, Google DeepMind czy Cloudflare, którą w maju za ponad 300 milionów dolarów kupił Anthropic. Cloudflare udostępnił 21 września na licencji Apache 2.0 Forge, własny generator SDK, CLI i dokumentacji, który działa w CI i przy każdym pull requeście pokazuje, co zmiana w API zrobi z bibliotekami. Pierwszym produkcyjnym wynikiem jest nowe CLI cf z ponad 3000 operacji, a obietnicę generowania serwerów MCP radzę najpierw sprawdzić w repozytorium.
 Premiera / Narzędzie
Agenty wpisują już prawie połowę poleceń w narzędziu Cloudflare
4 min
Wrangler, narzędzie wiersza poleceń Cloudflare, obsługiwał w marcu 2026 agentów w co czwartym przypadku, a tuż przed premierą następcy już w 48%, więc firma zbudowała nowe narzędzie z myślą o nich. Następca o nazwie cf, wydany jako otwarta wersja testowa, zamiast około 280 ręcznie pisanych poleceń ma ponad 3000, generowanych z jednego opisu API, i domyślnie odpowiada w formacie JSON. Słabym punktem jest to, że żaden model jeszcze go nie zna, a przeprowadzka jest tania tylko dla projektów budowanych przez Vite, przez co aplikacje w Ruście i Pythonie na razie zostają przy Wranglerze.
 Premiera / Narzędzie
MongoDB wpuszcza agentów AI do własnej bazy danych
4 min
MongoDB ogłosiło 29 września Atlas Agent Engine, usługę w publicznym podglądzie, w której agent AI czyta i zmienia dane, pamięta poprzednie rozmowy dzięki modelom Voyage AI i zostawia dziennik każdej akcji przypisany do konkretnej tożsamości. Firma obiecuje swobodę wyboru modelu i chmury, ale zależność nie znika, tylko przenosi się na samą platformę MongoDB. Razem z nim wyszło MongoDB 9.0, według wewnętrznych testów nawet dwa razy szybsze, oraz Atlas Infinite, na razie dostępny tylko na AWS.
 Premiera / Narzędzie
Company Brain za darmo: bot do Slacka, który wie tylko tyle, co pytający
5 min
Supermemory wygasiło płatnego bota do Slacka Company Brain i wypuściło jego kod na licencji Apache 2.0, tak że da się go postawić na własnym koncie Cloudflare z kluczem do Supermemory i do jednego z pięciu dostawców modeli. Bot zapamiętuje rozmowy zespołu, sam zabiera głos i przez MCP zakłada zgłoszenia w Linearze, ale najważniejsze jest to, że czyta wyłącznie z uprawnieniami osoby, która go pyta. Darmowy plan Cloudflare urywa odpowiedź po 50 wywołaniach, pamięć zostaje u dostawcy, a README milczy o ukrytych poleceniach w wiadomościach, więc zacząłbym od jednego kanału.
Model / Badania · 7
 Model / Badania
Ta sama cena za token, mocniejszy model: co naprawdę tanieje w GPT-6.1 Sol
4 min
GPT-6.1 Sol, który OpenAI pokazało 30 września, kosztuje w API tyle co poprzednik, czyli 2 dolary za milion tokenów wejścia i 10 dolarów za milion wyjścia, a w teście DeepSWE dorównuje Astrze przy niższym ustawieniu rozumowania. Naprawdę tanieje tylko wejście z pamięci podręcznej, które spadło o połowę, do 0,10 dolara za milion, co przy agencie wielokrotnie wysyłającym kontekst repozytorium waży więcej niż benchmarki. Trzeba uważać na dwukrotnie droższe wejście powyżej 272 tysięcy tokenów i na to, że narzędzia działają tylko przez Responses API.
 Model / Badania
Gemini 4 Argon prowadzi w jednym teście kodu z trzech
4 min
Gemini 4 Argon od Google'a zdobył 77,9% w DeepSWE v1.1 i wyprzedził GPT-6 Astrę oraz Claude Opusa 5.5, ale w tym samym zestawieniu przegrywa z Astrą o ponad 10 punktów we FrontierSWE v2, a z Opusem o dziewięć w Terminal-Bench 4.0. Według Bloomberga część pracowników Google'a podejrzewa, że model szlifowano pod testy bardziej niż pod prawdziwą pracę. Na razie Argona dostały tylko zespoły bezpieczeństwa z programu Fairwind, a stawki 2 i 10 dolarów za milion tokenów podwoją się po promocji, więc przed przesiadką lepiej sprawdzić go na własnym repozytorium.
 Model / Badania
Sonnet 5.5 kosztuje połowę Opusa, dopóki nie każesz mu długo myśleć
5 min
Claude Sonnet 5.5 z 28 września kosztuje za token połowę tego, co Opus 5.5, a w CursorBench traci do niego nieco ponad dwa punkty. Ta przewaga trzyma się jednak tylko na niskim i średnim wysiłku, bo na wyższych poziomach sam Anthropic przyznaje, że Sonnet dogania Opusa przy podobnym koszcie zadania. Najlepiej wypada w prostszych pracach, na przykład w przeglądach kodu, gdzie CodeRabbit zszedł z 1,16 dolara do 47 centów za recenzję. Przy przesiadce trzeba też usunąć parametry temperature i top_p, bo inaczej API zwróci błąd 400.
 Model / Badania
73% trafnych fragmentów zamiast 46%: Jev jako filtr w agencie badawczym
4 min
GPT Researcher domyślnie przepuszcza pobrane fragmenty przez Jev od TypeSafe, model, który zamiast pisać tekst zwraca prawdopodobieństwa z góry ustalonych odpowiedzi, i trafnych okazało się 73% zachowanych fragmentów wobec 46% przy embeddingach, przy tym samym koszcie raportu. Całą różnicę robi próg, bo zmuszony do wypełnienia wszystkich dziesięciu miejsc Jev spadł do 50%. Model kosztuje 0,042 dolara za milion tokenów wejściowych, a reklamowe mnożniki 193,6 i 444,6 pochodzą z testów samej firmy, więc traktuję je jako obietnicę, nie pomiar.
 Model / Badania
Opus 5.5 tańszy o 40%? Cennik obiecuje połowę tej sumy
4 min
Anthropic wypuścił 22 września Opusa 5.5 z obietnicą, że kosztuje o 40% mniej niż Opus 5, choć sam cennik daje tylko 20%: milion tokenów wejściowych kosztuje 4 dolary zamiast 5. Resztę oszczędności wyznacza ustawienie wysiłku, którego domyślny poziom spadł z high na medium, więc rachunek zależy od konfiguracji, a nie od samego modelu. Przy migracji wymuszone wywołanie narzędzia kończy się błędem 400, a przy dobrze opisanych zadaniach programistycznych zacząłbym od dwa razy tańszego Sonneta 5.5.
 Model / Badania
Ile programowania zostaje w modelu po wycięciu połowy ekspertów?
4 min
Zespół DASLab z ISTA wyciął z modelu Qwen3.8-Flash-Next od Alibaby 256 z 512 ekspertów w każdej warstwie, a resztę wag zapisał z dokładnością 3,5 bita, dzięki czemu wersja do programowania mieści się na jednej karcie z 32 GB zamiast 354 GB. Metoda RCO zachowuje tylko to, co było w próbce kalibracyjnej, przez co pierwsza wersja straciła widzenie, a testy kodu tego nie zauważyły. Na LiveCodeBench zostaje 98,7% wyniku, ale na SWE-bench Verified spadek z 82,8% do 75,6% pokazuje, że w pracy agenta cięcie kosztuje więcej.
 Model / Badania
CLM-8B nie pisze ani słowa, tylko wybiera najlepszy ruch agenta
4 min
CLM-8B od związanego ze Stanfordem zespołu Contrastive-LM nie generuje tekstu, tylko przypisuje prawdopodobieństwo każdemu możliwemu ruchowi agenta, dzięki czemu jest szybszy od zamkniętego Jev, w grze T-Rex nawet dziewięciokrotnie. Jako sędzia łatek podniósł wynik na DeepSWE z 73,7 do 81,6%, podczas gdy Jev wybierał gorzej niż branie pierwszego rozwiązania z brzegu. Rekord liczono jednak na 38 i 30 zadaniach, więc szybkość broni się lepiej niż jakość, a nakładkę o wadze 75 MB na licencji Apache 2.0 można sprawdzić na własnych zadaniach.