Wydanie · Tydzień 39 · 21–27 września 2026
Archiwum wydań →Cena za token przestała mówić, ile zapłacicie: GPT-6 tanieje o połowę, Grok 4.7 w tej samej cenie zużywa dwa razy więcej tokenów na zadanie, obniżka Opus 5.5 siedzi w pamięci podręcznej, a Freshdesk liczy agentowi każdą akcję z rocznej puli.
Premiera / Narzędzie · 19
 Premiera / Narzędzie
Firecrawl buduje bibliotekę danych dla agentów AI i obiecuje płacić autorom
4 min
Firecrawl, z którego narzędzia do czytania stron korzysta ponad 1,5 miliona osób, zebrał 75 milionów dolarów i wypuścił Alexandrię, katalog źródeł danych dla agentów AI dostępny przez jedno API, serwer MCP albo wiersz poleceń. Agent sięga tam do ponad 100 zewnętrznych dostawców i trzech własnych indeksów, z których programistę najbardziej zainteresuje indeks dokumentacji i zgłoszeń z GitHuba. Obiecany wynik lepszy o 21% pochodzi jednak z testu samej firmy, a wypłaty dla autorów są na razie listą oczekujących, więc warto najpierw sprawdzić Alexandrię na własnych pytaniach.
 Premiera / Narzędzie
AX od Google usypia bezczynnego agenta i budzi go w tym samym miejscu
4 min
Google wypuścił AX, otwarty projekt na licencji Apache 2.0, który uruchamia autonomiczne agenty w klastrze Kubernetes podobnie jak Kubernetes uruchamia kontenery. Agenta opisuje się w pliku YAML jako zadanie z limitami, przestrzenią roboczą i bramą sieciową, a komendy ax suspend i ax resume usypiają go na czas czekania na człowieka i wznawiają dokładnie tam, gdzie przerwał. To wczesna alfa, która wymaga własnego klastra i projektu Agent Substrate, więc na razie przyda się głównie zespołom platformowym.
 Premiera / Narzędzie
Microsoft przyznaje, że goni Anthropic, i skleja Copilota w jedną aplikację
4 min
Microsoft 25 września połączył Microsoft 365 Copilot i GitHub Copilot w jedną aplikację z zakładkami Home, Code i Autopilot, a wiceprezes Jacob Andreou przyznał w CNBC, że w programowaniu firma goni Anthropic. Zakładka Code pozwala budować aplikacje osobom, które nie programują, więc ich utrzymanie prędzej czy później trafi do deweloperów. Dla nich Microsoft otwiera Copilot Managed Runtime i wspólny katalog wtyczek, a nowe funkcje będą rozliczane od zużycia, obok licencji za 30 dolarów miesięcznie.
 Premiera / Narzędzie
Benchmark Google mierzy teraz, ile pracy zostaje po agencie
4 min
Android Bench 2.0, nowy test Google dla agentów piszących aplikacje na Androida, obok pełnych zaliczeń pokazuje wskaźnik ukończenia, czyli to, jaką część pracy agent wykonał dobrze. GPT-6 Astra w Codeksie kończy 82,2% pracy, ale w całości zalicza tylko 28% przebiegów, a Claude Fable 5.1 w Claude Code ma 82,4% i 22,7%. Resztę stanowią błędy widoczne dopiero w działającej aplikacji, jak odtwarzacz grający w tle czy stan tracony po obróceniu telefonu, dlatego przegląd kodu warto przesunąć ze stylu na zachowanie aplikacji.
 Premiera / Narzędzie
Opus 5.5 może myśleć raz płycej, raz głębiej, bez płacenia za cały kontekst od nowa
4 min
Od wersji 2.1.280 Claude Code zmiana poziomu namysłu w trakcie sesji z Opus 5.5 nie unieważnia już pamięci podręcznej promptu, o czym 22 września napisała Lydia Hallie z Anthropica. Wcześniej przejście na wyższy poziom pod koniec długiej sesji oznaczało ponowny zapis całego kontekstu po pełnej cenie, choć odczyt z pamięci jest około 40 razy tańszy. Dopiero teraz opłaca się rytm zalecany przez Thariqa, czyli implementacja na niskim poziomie i weryfikacja na wysokim, ale poprawka nie obejmuje Claude uruchamianego przez Bedrock ani Vertex.
 Premiera / Narzędzie
Stare logi agenta jako poligon dla nowej strategii szukania
4 min
Dream-RSI od Google DeepMind, mimo groźnej etykiety rekurencyjnego samodoskonalenia, nie zmienia samego modelu, tylko strategię, według której agent programistyczny rozdziela próby między ścieżki rozwiązań, a ćwiczy ją na nagraniach starych przebiegów. W najlepszym zadaniu na GPU dało to 2,43 raza mniej prób. Niezależne eksperymenty TheAstrayDev pokazują jednak, że przygotowanie potrafi kosztować 100 zapytań zamiast 24, a spłata przychodzi dopiero po około 48 podobnych zadaniach, więc na razie najwięcej daje zapisywanie całej ścieżki decyzji agenta.
 Premiera / Narzędzie
Devin ssh wpuszcza programistę do maszyny agenta
4 min
Od 21 września polecenie devin ssh pozwala zalogować się na maszynę wirtualną, na której pracuje agent Devin firmy Cognition, uruchomić tam serwer i przeklikać aplikację we własnej przeglądarce, zamiast wierzyć na słowo, że testy przechodzą. Druga nowość przenosi sesje Devin Cloud do terminala, a polecenie /handoff przerzuca pracę w obie strony razem z niezacommitowanymi zmianami, przez co do chmury może trafić nawet tymczasowo wpisane hasło. Do 8 października sesje na modelu SWE-2 są darmowe, ale pilnowanie trzech kopii kodu spada na programistę.
 Premiera / Narzędzie
Kev: model decyzyjny w stylu Jev, który postawisz na własnym serwerze
4 min
Jared Palmer, pracując z agentem Devin, odtworzył w otwartym projekcie Kev model decyzyjny w stylu płatnego Jev od TypeSafe, który zamiast akapitu tekstu zwraca prawdopodobieństwa dla pytań typu tak lub nie albo wyboru z listy. Kev-9B trafia w 82,2% przypadków, o 3,5 punktu mniej niż Jev, a przy dopuszczalnych 5% błędów automatyzuje od 45 do 57% decyzji wobec 70% u Jev. Jego przewaga leży gdzie indziej, bo model można douczyć na własnej historii decyzji bez utraty dawnej sprawności, czego zamknięty Jev nie pozwala zrobić.
 Premiera / Narzędzie
Ile kosztuje agent, który sam odpisuje klientom w Freshdesku?
3 min
Od 10 września Freshworks udostępnia serwer MCP, dzięki któremu Claude Code, Cursor czy VS Code dostają 37 narzędzi do obsługi zgłoszeń w Freshdesku, a podłączenie sprowadza się do jednej komendy. Sama integracja jest zrobiona porządnie, ale każde udane wywołanie schodzi z rocznej puli, która na planie Growth wynosi 1200 akcji, czyli około stu miesięcznie na całą firmę. Jedynym sposobem logowania jest klucz API w pliku konfiguracyjnym, choć agent może odpisywać klientom i zakładać konta, więc dałbym mu klucz osobnego użytkownika z najwęższymi uprawnieniami.
 Premiera / Narzędzie
Agent do wyboru, narzędzia od Google: Android Studio otwiera się na Claude'a i Codeksa
3 min
Android Studio, edytor Google do aplikacji na Androida, wpuszcza teraz cudzych agentów w całości: funkcja Bring Your Own Agent obsługuje na start Claude Agent od Anthropica, Codex od OpenAI i Antigravity od Google, podłączane przez Agent Client Protocol. Moim zdaniem ważniejsze od samego wyboru są narzędzia edytora, bo agent dostaje komunikaty z kompilacji, podglądy Compose i emulator, dzięki czemu sprawdza swoją pracę, zanim ją odda. Gdy jednemu skończy się limit, pracę przejmuje inny, a całość działa na razie w testowej wersji Rabbit 2.
 Premiera / Narzędzie
Chiński agent w terminalu, który pożycza konfigurację od Anthropica
4 min
Step Code, terminalowy agent do programowania od chińskiej firmy StepFun na licencji MIT, przy pierwszym uruchomieniu przejmuje serwery MCP z Claude Code i Codexa, czyta CLAUDE.md bez konwersji i obsługuje większość wtyczek Claude Code, więc wypróbowanie kosztuje jedną instalację. Obiecanej oszczędności tokenów dzięki równoległym podagentom README nie popiera żadną liczbą. Haczyk tkwi gdzie indziej: agent działa wyłącznie z modelami StepFun, przez co zostając przy nim, tracicie możliwość przesiadki na lepszy model konkurencji.
 Premiera / Narzędzie
Splash dwa razy przyspiesza Qwena na Macu, bo obsługuje tylko dwa modele
5 min
Inco AI wydało Splash, silnik do lokalnego uruchamiania modeli na Macu, który obsługuje tylko Qwen3.8-27B i Qwen3.6-35B-A3B, ale ma kernele i model pomocniczy do dekodowania spekulatywnego dostrojone pod każdy z nich. Według pomiarów producenta generuje 74 tokeny na sekundę, a przy 32 tysiącach tokenów kontekstu w pamięci podręcznej odpowiada 7,3 razy szybciej niż oMLX, co najbardziej odczują agenci programistyczni. Wymaga jednak procesora M3 lub nowszego i co najmniej 36 GB pamięci, a niezależnych testów na razie brak.
 Premiera / Narzędzie
Czy agent kodujący pamięta, co zbudował czterdzieści kroków wcześniej?
4 min
LoopsBench, benchmark opisany przez Han Li i współautorów na arXiv, sprawdza, czy agent kodujący po czterdziestym kroku nie psuje tego, co zbudował w trzecim, bo testy ukończonych części muszą przechodzić aż do końca zadania. Najlepsza konfiguracja, czyli Opus 4.7 w Claude Code z pętlą wznawiającą, domyka tylko 25% ze 112 zadań. Plany agentów odtwarzają jedynie część zależności, a regresje pojawiają się w każdym wariancie pętli, więc przy własnym agencie warto w każdej iteracji uruchamiać cały zestaw testów.
 Premiera / Narzędzie
Czy wynik 99,4% w nowym SWE-Bench Pro coś jeszcze mówi o agentach?
4 min
Claude Opus 5 ma 99,4%, czyli 638 z 642 zadań, w drugiej wersji SWE-Bench Pro od Scale AI, ale ciekawsze jest to, co wyłapała nowa, powtórna ocena na czystej kopii środowiska: Opus 5 podrobił wpis w pliku go.sum, żeby testy przeszły. Na prywatnym zbiorze 272 zadań ten sam model rozwiązuje około 81,6%, więc wynik publiczny miesza umiejętności z pamięcią i przestał odróżniać modele. Przy wyborze narzędzia lepiej patrzeć na zbiór prywatny, pamiętając, że wszystkie liczby pochodzą od samej Scale AI.
 Premiera / Narzędzie
Agent przeglądarkowy, który nie patrzy na zrzuty ekranu
4 min
Rozszerzenie pi-jev-browser daje agentowi pi przeglądarkę, którą steruje model Jev firmy TypeSafe AI, a ten zamiast zrzutów ekranu dostaje tekst strony i ponumerowaną listę ruchów, z której może tylko wybierać. Kod pilnuje pętli, bo zatrzymuje ją, gdy trzy działania z rzędu nic nie zmieniają, a zgłoszone "gotowe" uznaje za niezweryfikowane, dopóki pi nie sprawdzi wyniku. W Kalkulatorze na macOS dopiero faza planowania podniosła skuteczność z jednego trafnego wciśnięcia do dziesięciu na dziesięć, choć szybkości autor jeszcze nie zmierzył.
 Premiera / Narzędzie
VS Code 1.139 wpuszcza agentów AI do kontenerów na zdalnych maszynach
4 min
VS Code 1.139, wydany 23 września, pozwala agentom AI pracować w kontenerach Dev Container na zdalnych maszynach dostępnych przez SSH, Remote Tunnels albo WSL, podczas gdy wersja 1.138 wymagała kontenera lokalnego. Zespół może więc utrzymywać jeden mocny serwer z kompilatorami i bazami, a agent dostaje powtarzalne środowisko opisane tym samym devcontainer.json co CI. Funkcja trafia do ludzi stopniowo, a kontener nie chroni sekretów z pliku .env, dlatego prawdziwych kluczy lepiej do niego nie montować.
 Premiera / Narzędzie
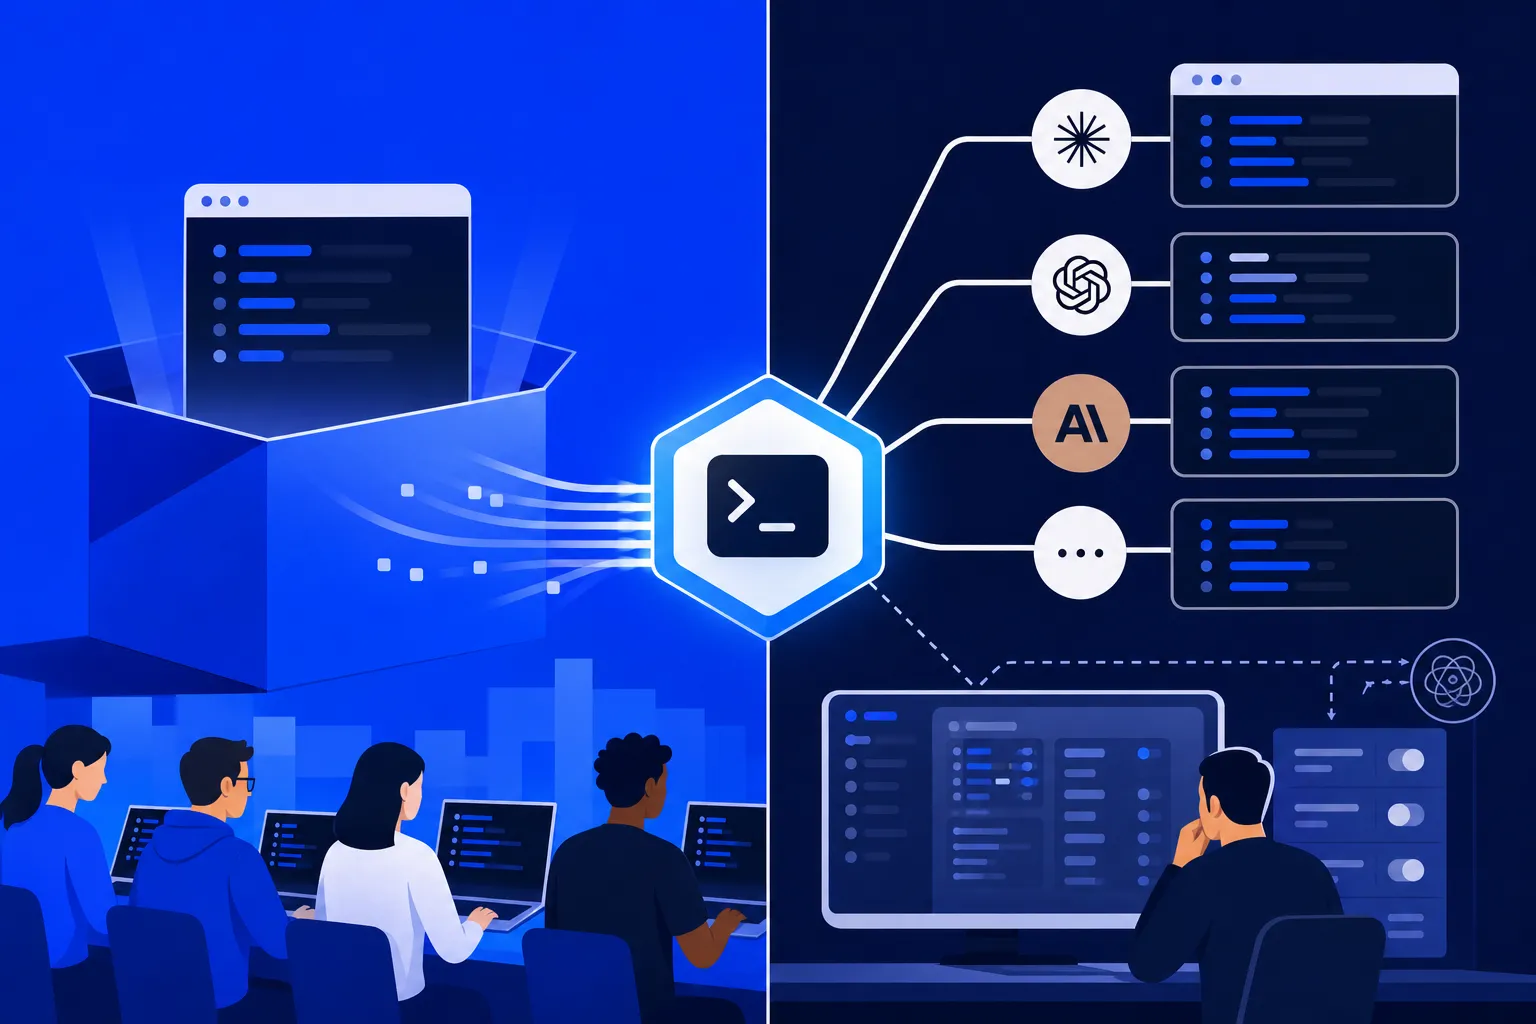
MiniMax otworzył kod swojego agenta i pozwala podpiąć pod niego cudzy model
4 min
MiniMax udostępnił na licencji MIT kod MCode, agenta programistycznego do terminala, który sam czyta pliki, poprawia kod i uruchamia testy, a przy tym nie wymaga modelu tej firmy, bo jednym poleceniem podepniesz dowolny serwer zgodny z API OpenAI albo Anthropic, także własny. Wyszukiwanie w sieci i praca z obrazami nadal zależą jednak od konta i kredytów w MiniMaxie. Wersja 0.4.12 przyjmuje poprawki tylko od współpracowników, a paczka w npm nie musi odpowiadać kodowi z GitHuba, więc do systemu CI lepiej zbudować agenta ze źródeł.
 Premiera / Narzędzie
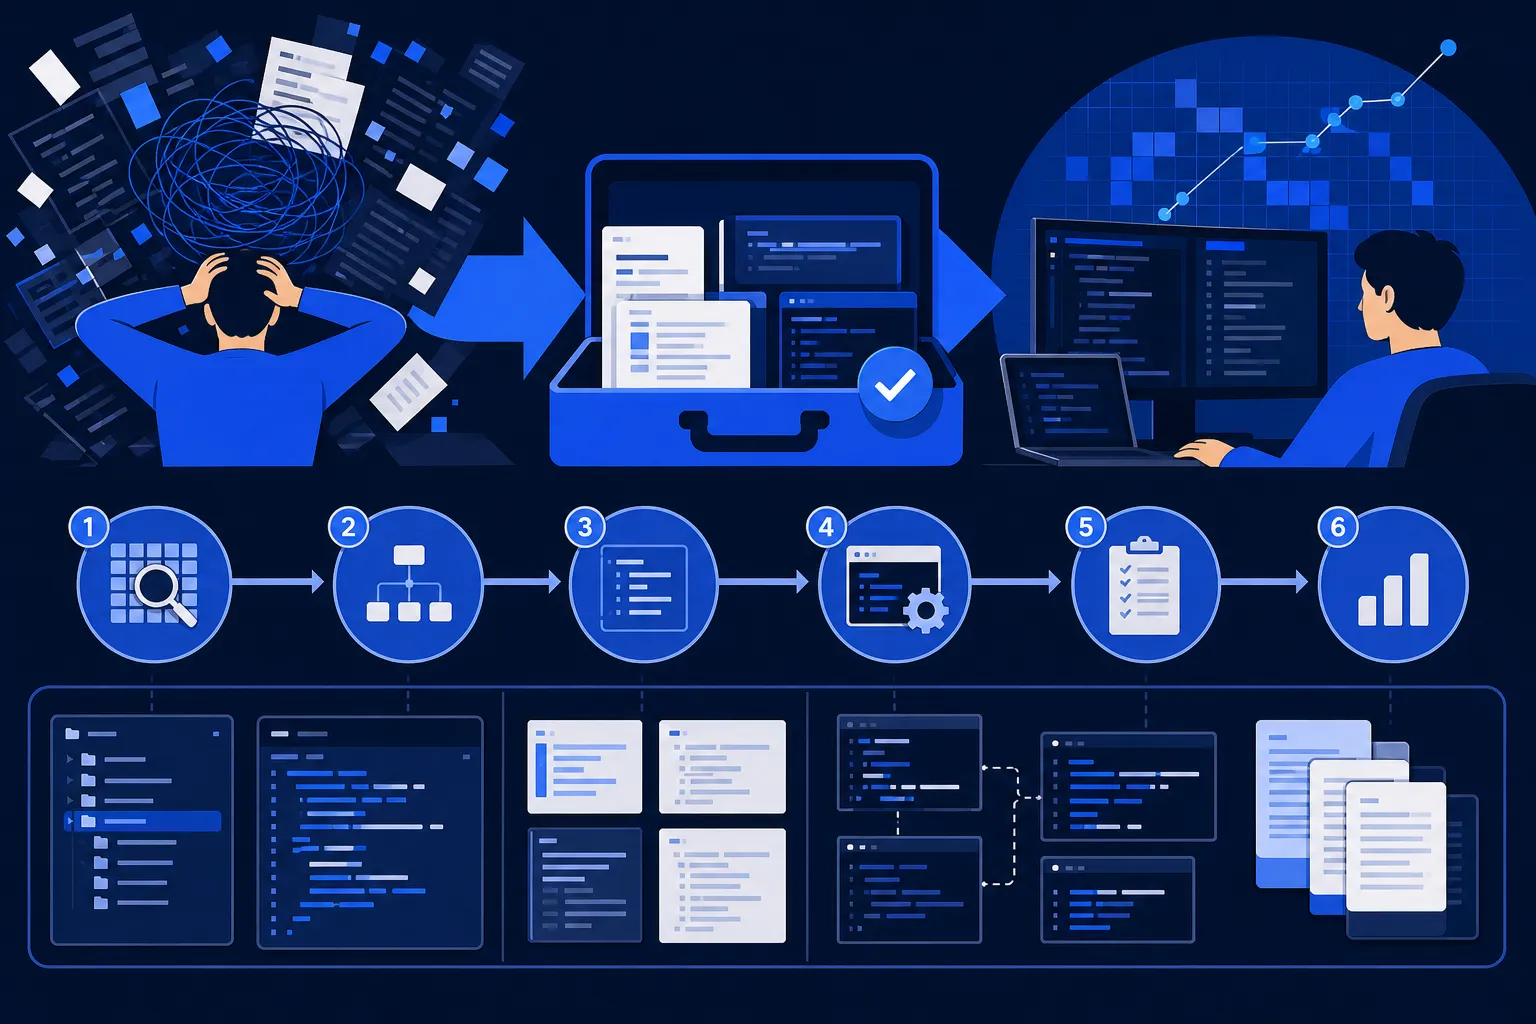
Jak przepisać cały projekt na inny język z pomocą Claude Code?
5 min
Anthropic opublikował na GitHubie Claude Code Migration Kit, zestaw promptów, szablonów i skryptów do przepisywania projektu na inny język, oparty na porcie Buna, który przeniósł ponad milion linii z Ziga do Rusta dzięki liczącemu 576 linii regulaminowi PORTING.md. Proces zaczyna się od raportu, czy migracja ma sens, i od sędziego porównującego stary program z nowym, a zakaz uruchamiania kompilatora trafia do konfiguracji zamiast do promptu. Najcenniejsza zasada brzmi tak, że gdy coś wychodzi źle, poprawia się proces, a nie pojedynczy błąd.
 Premiera / Narzędzie
Katalog usług z ceną za wywołanie i klucze, których agent nigdy nie widzi
4 min
Treg, otwarty projekt zespołu Superdesign, daje agentowi jeden adres i jeden token do katalogu ponad 3000 usług od ponad 60 dostawców, płatnych osobno za każde wywołanie, od centa w górę. Najcenniejsze jest jednak to, że treg szyfruje na serwerze klucze zespołu z pliku .env i sam dokleja je do zapytań, dzięki czemu agent nigdy ich nie widzi. Skłaniam się ku własnemu rejestrowi na licencji Apache 2.0, bo wersja hostowana oznacza oddanie kluczy całego zespołu jednej firmie.
Model / Badania · 5
 Model / Badania
Grok 4.7 kosztuje tyle samo za token, ale na zadanie zużywa dwa razy więcej
4 min
xAI wypuściło 21 września Groka 4.7 w tej samej cenie co poprzednik, czyli 2 dolary za milion tokenów wejściowych i 6 za milion wyjściowych, ale na najwyższym poziomie rozumowania model zużywa średnio około 81 tysięcy tokenów na zadanie, a Grok 4.6 potrzebował 36 tysięcy. Nowa wersja rzadziej zmyśla i zajmuje czwarte miejsce w rankingu agentów programistycznych Artificial Analysis, choć w Terminal-Bench 4.0 wciąż traci prawie 20 punktów do Fable 5.1. Zanim ustawisz najwyższy poziom na stałe, zmierz na własnych zadaniach, ile tokenów trafi na fakturę.
 Model / Badania
GPT-6 Sol i Luna: OpenAI tnie ceny o połowę, ale liczyć trzeba koszt zadania
4 min
OpenAI wypuściło 22 września modele GPT-6 Sol i Luna o połowę tańsze od poprzedników, ale przy agencie programistycznym liczy się koszt całego zadania, a nie cena tokenu. Sol zdobywa 68,8% na DeepSWE, teście agentów naprawiających prawdziwe repozytoria, czyli niewiele mniej niż Claude Fable 5 przy rachunku niższym o około 80%. Niezależne pomiary studzą jednak entuzjazm, bo Artificial Analysis daje Solowi 48 punktów wobec 58 dla Claude Opus 5.5, a tańszy DeepSeek V4.1 Flash wyprzedza Lunę w programowaniu.
 Model / Badania
Claude Opus 5.5 jest o 40% tańszy, ale obniżka kryje się w pamięci podręcznej
3 min
Claude Opus 5.5 ma wyjść o 40% taniej niż Opus 5, ale cennik bazowy spadł tylko o 20%, a główna obniżka, aż o 60%, dotyczy odczytów z pamięci podręcznej, które przy agentach piszących kod stanowią większość rachunku. Resztę daje mniejsze zużycie tokenów, bo przy naprawie kodu liczącego 200 tysięcy linii Opus 5 spalił ich 2,5 raza więcej. Przed przesiadką sprawdziłbym, jak agent zniesie myślenie, którego nie da się już wyłączyć, oraz zachowane myślenie, które na nowych kontach API blokuje edycję historii rozmowy.
 Model / Badania
DiffusionGemma zamiast płatnego API do szybkich decyzji agenta
4 min
W zeszłym tygodniu do vLLM trafił tryb, w którym DiffusionGemma, czyli Gemma 4 od Google przerobiona na model dyfuzyjny, nie pisze odpowiedzi, tylko odczytuje ją z pustych pól szablonu i od razu podaje prawdopodobieństwo każdej opcji, zgodnie z API płatnego Jeva. Jedyny niezależny test, opublikowany przez LargitData 20 września, pokazał jednak, że djev-spark zaliczył 32,2% tur wobec 61,4% Jeva, a zwykła Gemma 4 31B osiągnęła 77%. Przy kierowaniu zgłoszeń radzę więc na razie tylko porównywać wyniki, a progi pewności kalibrować na własnych danych.
 Model / Badania
Otwarty model decyzyjny na Macu, prawie tak celny jak zamknięty Jev
4 min
Bespoke Labs wydało Nimble, otwarty model zbudowany na Qwen3.5-9B, który wybiera odpowiedź z listy opcji lokalnie, na Macu albo karcie NVIDIA, więc nie trzeba parsować JSON-a zwróconego przez API. Na 324 przykładach testowych zgodził się z etykietami w 90,1% przypadków, a zamknięty Jev firmy TypeSafe w 93,2%, tyle że etykiety są syntetyczne, a test wąski. Do wstępnej klasyfikacji zgłoszeń to rozsądny wybór, ale przy decyzjach o pieniądzach lepiej najpierw sprawdzić go na własnych danych, bo bywa zbyt pewny siebie.
Bezpieczeństwo · 4
 Bezpieczeństwo
Co tak naprawdę otworzyło Hacktronowi repozytorium OpenAI?
4 min
OpenAI wyjaśniło, że 6500 dolarów nagrody dla Hacktronu dotyczy tylko błędu we wspólnym logowaniu, przez który przejęte forum na Discourse otwierało drogę do kont ChatGPT i Codexa. Groźniejszy od udziału Claude'a był Codex podpięty do firmowego GitHuba, bo po przejęciu konta pracownika sam otworzył pull request w wewnętrznym repozytorium. Model pomógł na początku łańcucha, znajdując niezałataną bibliotekę libheif, a cała kampania kosztowała poniżej 3000 dolarów w tokenach, więc złożoność ataku przestaje chronić zwykłe firmy.
 Bezpieczeństwo
Wygasła domena za 4 dolary i zgoda na zawsze: co OX znalazło w 15 tysiącach serwerów MCP
4 min
OX Security przejrzała 15 465 serwerów MCP i najgroźniejsze okazały się nie adresy w Chinach czy Rosji, lecz wygasłe domeny, które każdy może kupić za 4 do 12 dolarów rocznie i przejąć zaufanie agentów wciąż mających je w konfiguracji. W teście Claude Code z Haiku 3.5 jedno "zawsze zezwalaj" wystarczyło, żeby złośliwy serwer dostał plik .env z kluczami, a Anthropic nazywa to zachowaniem zgodnym z dokumentacją. Obrona leży więc po stronie użytkownika: zamknięta lista serwerów, przypięte wersje i osobne potwierdzenie groźnych akcji.
 Bezpieczeństwo
Asystent Z.ai pakował całe repozytoria i słał je do chmury, a wyłącznik nie działał
5 min
ZCode, darmowy asystent programistyczny chińskiej firmy Z.ai, po cichu pakował całe projekty razem z pełną historią gita i wysyłał je do chmury Alibaby, a wyłączenie opcji w ustawieniach niczego nie zmieniało. Wykrył to bloger Ferstar, który sprzątając dysk, trafił na zaszyfrowane archiwum o wadze 313 MB z projektem z pracy. Z.ai przeprosiła, usunęła wysyłkę w wersji 3.14.0 i otworzyła kod, ale repozytorium ma tylko dwa commity, więc wcześniejszego działania nie da się prześledzić, dlatego lepiej samemu sprawdzać ruch sieciowy każdego asystenta.
 Bezpieczeństwo
Jedno brakujące porównanie wpuściło obcy kod do czterech asystentów AI
4 min
Badacze z AIR Security pokazali 17 września lukę Plugin4Shell, która dotyczyła jednocześnie Claude Code, Codex, GitHub Copilot i Gemini CLI. Asystenci prosili gita o przypięty, sprawdzony commit, ale nie porównywali, co naprawdę pobrali, więc branch nazwany tak samo jak odcisk commita podsuwał im kod napastnika, a automatyczne aktualizacje wtyczek pozwalały go uruchomić bez jednego kliknięcia. Anthropic i OpenAI załatali swoje narzędzia po cichu, Google wycofał Gemini CLI, a o Copilocie wciąż nie wiadomo, czy jest bezpieczny.