Programowanie AI
Pięć linijek, które piszesz, zanim odpalisz drugiego agenta
4 min
Poradnik Warpa o pracy z kilkoma agentami naraz sprowadza się do pięciu linijek wklejanych każdej sesji na start: kto odpowiada za które katalogi, na jakiej gałęzi pracuje i co ma zameldować na koniec. Warp rozpisuje to na osiem kroków, sadza każdego agenta we własnym worktree i wprost zabrania automatycznego scalania, bo cudzy błąd łapiesz tylko przy przeglądzie. Chmurowe polecenie /orchestrate zostawiłbym na migracje monorepo, bo poradnik nie podaje ani kosztu, ani oszczędności, a cztery agenty skracają czas pisania kodu i wydłużają czas jego czytania.
Test przeszedł, bo agent sam wygenerował dane z tym samym błędem
5 min
W benchmarku NVIDII Claude Code napisał 45 skryptów do symulacji materiałów w pięciu wariantach promptu, a dłuższy prompt kupował głównie strukturę kodu, bo właściwy wzór agent dobierał już przy jednym zdaniu. Realną różnicę robiły dwie inne rzeczy: środowisko, w którym agent może odpalić własny kod, oraz jedno zdanie o fizyce, bez którego skrypty sięgały po termostat Langevina i zaniżały wynik od trzech do pięciu razy. Żadna konfiguracja ani razu nie zakwestionowała zadania bez fizycznego sensu, a 38 z 45 skryptów wybrało algorytm FIRE, bo tylko on stał w przykładach.
Dwie linijki, jedna zatwierdzona komenda i klucz SSH wychodzi z komputera
6 min
Pillar Security opisało w Cursorze lukę CVE-2026-22708, w której dwie linijki wystarczą, żeby z komputera wyszedł prywatny klucz SSH: export PAGER przechodzi bez pytania, bo jest wbudowany w powłokę, a ręcznie zatwierdzone git branch posłusznie odpala podłożony ładunek. Atak działał nawet przy pustej liście dozwolonych komend, więc taka lista jest wygodą, a nie granicą bezpieczeństwa, i dopiero wersja 2.3 Cursora ją domknęła. Docker Sandboxes przycina zasięg szkód, ale katalog z kodem wciąż jest podpięty żywcem z hosta, więc pułapkę w skryptach gita można zostawić na potem.
DeepSeek oddaje za darmo przyrząd, na którym mierzył własnego flagowca
4 min
DeepSeek podaje, że model V4-Pro-0813 kończy 87,9 procent zadań w Terminal Bench 2.1, tyle że przy części testów agentowych pracował na własnym Harnessie, czyli warstwie, którą w połowie sierpnia oddał wszystkim na licencji MIT. Taki wynik ocenia parę, model i warstwę wokół niego, więc podpinając te same wagi pod swojego agenta, dostaniesz swoją własną liczbę. Za to razem z tabelką dostajesz stanowisko, na którym ona powstała, a model jest w nim wymienną wtyczką, więc sprawdzisz tam też Claude'a czy GPT. Ceną jest wczesna wersja, przy której DeepSeek zapowiada zmiany łamiące zgodność.
Jedna zgoda OAuth otwiera agentowi także ustawienia projektu w Sanity
4 min
Serwer MCP Sanity daje agentowi 37 narzędzi, a jedna zgoda OAuth obejmuje je wszystkie naraz: obok edycji treści siedzą tam add_cors_origin, create_project i deploy_studio, więc model, który pogubił się w schemacie, ma czym dopisać obcą domenę do listy zaufanych. Po stronie treści przemyślano to lepiej, bo poprawki lądują w szkicu i wchodzą jedną transakcją, ale publikacja i kasowanie wersji roboczych to już pojedyncze wywołanie. Sam wpisałbym w konfiguracji osobny token API z węższą rolą niż własne konto i sprawdził, czy agent czyta ten schemat, na którym faktycznie pracuje.
Modele znajdują luki, których nie znalazł nikt, i same je zostawiają w kodzie
4 min
Modele wyłapują luki zero-day, których nikt wcześniej nie widział, a przy łataniu i pisaniu kodu potykają się o podstawy: 44% wygenerowanego kodu ma podatność z listy OWASP Top 10, a przez cztery pomiary rozłożone na rok średnia w ogóle nie drgnęła. W ponad 6000 przebiegów Off-By-1 Labs z 1Password tylko 26% łatek zamykało dziurę, nie psując przy tym działania aplikacji. Różnicę robi dopiero warstwa wokół modelu, bo w SIG przebiegi z obowiązkową bramką Sigrid Guardrails dały około 97% mniej poważnych znalezisk skanera.
Harness decyduje o rachunku za agenta bardziej niż sam model
5 min
TrueFoundry wypuściło 19 sierpnia TrueForge, otwarty harness agentowy na licencji MIT, obiecując o połowę niższe koszty, choć takiej liczby nie ma w benchmarku opublikowanym razem z kodem. Na 14 zadaniach z Enterprise-Bench przy tym samym Opusie 4.8 TrueForge dorównał skutecznością Claude Managed Agents za 8,5 dolara na uruchomienie zamiast 11,8, bo przycina kontekst i zużył 4 miliony tokenów zamiast 10. Drugą oszczędność, do 2,9 dolara, zrobiła podmiana modelu na otwarty GLM-5.2, a nie sam harness, a obiecana kontrola kosztów i uprawnień działa dopiero przez komercyjny AI Gateway.
OpenAI szuka nadużyć w waszych sesjach, nie zaglądając do treści
4 min
OpenAI ogłosiło 19 sierpnia Private Safety Processing: automat zestawia ze sobą powiązane sesje w API i wysyła do firmy samą etykietę ryzyka, bez ani jednego zdania z treści, więc zerowa retencja zaczyna znaczyć nie tyle "nic nie zostaje", co "nic nie zostaje dla ludzi". Anthropic poszedł w lipcu dokładnie odwrotnie i przy najmocniejszych modelach trzyma sesje przez 30 dni. Brak zapisu zamienia jednak problem dowodowy w problem zaufania, bo po fałszywym alarmie nie macie czym się wytłumaczyć, o ile sami nie prowadzicie własnego rejestru.
Z 6% na 75% bez dotykania modelu: co AMD zmieniło w swoich agentach
4 min
AMD puściło agenty na zgłoszenia błędów z panelu sterowników Radeona w październiku 2025, domykały wtedy 6% z nich, a w czerwcu 2026 już ponad 75%, choć nikt po drodze nie tknął modelu. Zamiast dotrenowywać, zespół przestał tłumaczyć agentom, jak naprawić usterkę, i zaczął stawiać warunek końcowy, do którego drogę wybierają same, z prawem do kilku podejść i z pętlą wracających wniosków z nieudanych prób. Zgłoszenia z RSX są wąskie i powtarzalne, więc te 75% nic nie mówi o twoim repozytorium, ale sam mechanizm działa wszędzie tam, gdzie da się jasno zdefiniować kryterium sukcesu.
Co naprawdę wychodzi z twojego katalogu, kiedy pracuje agent
4 min
Niezależny badacz publikujący jako cereblab podpiął Grok Build pod własne proxy i zobaczył, że terminalowe narzędzie xAI samo z siebie pakuje całe repozytorium razem z historią gita i wysyła je do chmury, a podłożone w pliku .env fałszywe hasło idzie tą samą drogą. Na repozytorium o rozmiarze 12 GB rozmową z modelem poszły 192 KB, a osobnym połączeniem 5,1 GB, czyli także pliki, których agent nigdy nie otworzył. Przełącznik "Improve the model" nic nie zmieniał, bo serwer xAI przy starcie sesji i tak odsyłał zgodę na wysyłkę, przez co poprawka przyszła od xAI, a nie z twojego dysku.
Zestaw testów agenta potrafi wysłać prawdziwy przelew
4 min
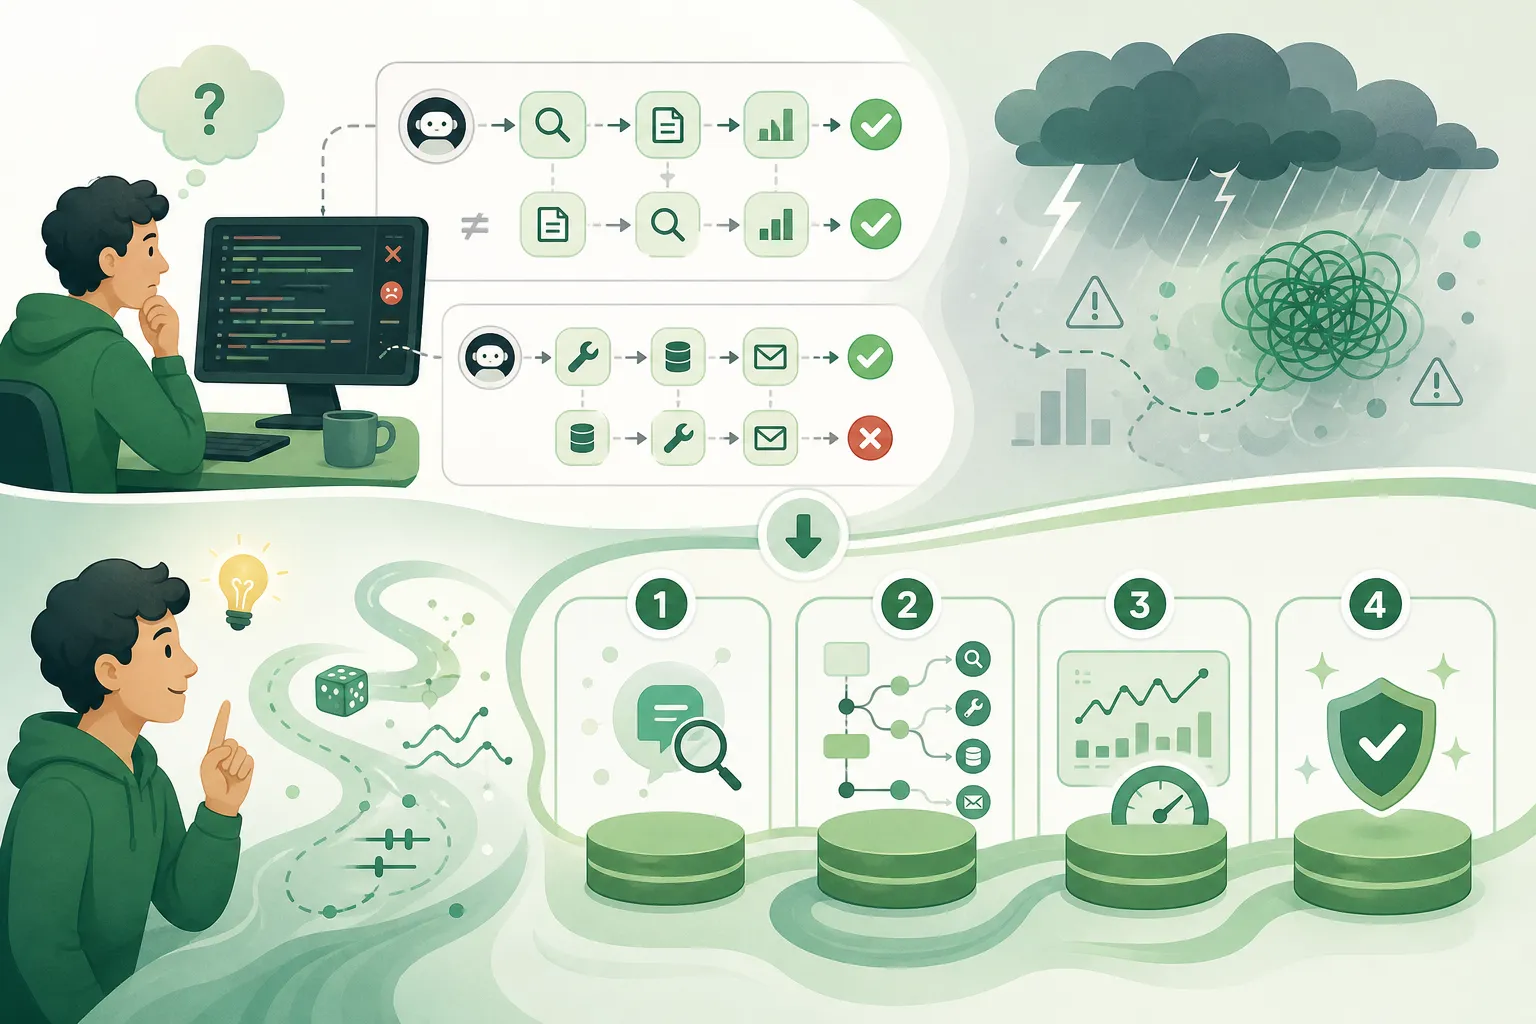
Braintrust tłumaczy, dlaczego test jednostkowy odrzuca poprawny przebieg agenta tylko za to, że sprawdził regulamin przed zamówieniem, i w miejsce asercji wstawia funkcję oceniającą cały zapis pracy w skali od 0 do 1, puszczaną kilka razy na to samo zgłoszenie. Zestaw wpięty w prawdziwe API płatnicze wysyłałby przy tym prawdziwe przelewy, więc usługi trzeba podstawić jako atrapy. Zapamiętałbym stąd liczbę kroków jako sygnał regresji, bo zapala się, zanim wynik zdąży się popsuć. Gorzej, że bramka w CI blokuje merge na ocenie modelu w roli sędziego, którego zgodności z ludźmi nikt nie podaje.
BrowserCode wpuszcza agenta do twojej zalogowanej karty w Chrome
4 min
BrowserCode zespołu browser-use, wydany na licencji MIT, daje agentowi jeden prymityw browser_execute(code): pisze on własny JavaScript prosto w twojej zalogowanej karcie Chrome przez DevTools Protocol, zamiast uczyć się poleceń typu "kliknij element numer siedem". Pomysł jest trafiony, bo model widział miliony linii JavaScriptu i ani jednej funkcji click(index), ale zdjęta warstwa abstrakcji była jedynym miejscem, gdzie dało się postawić granicę. Zapewnienie z README o przewadze nad konkurencją stoi bez jednej liczby, a 15 405 commitów to w większości dorobek OpenCode, którego to fork.
Claude robi teraz kilka ruchów na jedno wywołanie, zamiast pytać po każdym kliknięciu
4 min
Anthropic wypuścił 21 sierpnia produkcyjne wersje obsługi komputera i narzędzia do przeglądarki, a nowy zestaw narzędzi pozwala modelowi wykonać kilka działań w jednej turze, zamiast prosić o zrzut ekranu po każdym kliknięciu. Klienci z wczesnego dostępu notują 20-40% mniej wywołań modelu, a David Mlcoch z Asteroid zbił koszt zadania o 25 do 32%. Ważniejsza wydaje mi się przeglądarka, która podaje modelowi strukturę strony, dzięki czemu automatyzacja nie sypie się po przebudowie układu. Każde wywołanie mniej to jednak jeden punkt kontrolny mniej tam, gdzie agent zatwierdza przelew.
Plik SKILL.md nie uczy agenta faktów, tylko pilnuje kolejności kroków
4 min
Zhiyuan Jiang i jego zespół zebrali 8135 kontrolowanych prób i ręcznie opisali 240 przebiegów, żeby sprawdzić, dlaczego pliki SKILL.md podnoszą skuteczność agentów: w 65,7% przypadków umiejętność działa jako kotwica proceduralna, a podanie faktu, którego model nie znał, tłumaczy raptem 4,5%. Trafność sięgnięcia po właściwy plik leci z 29,6% przy pięciu umiejętnościach do 3,3% przy stu, choć skuteczność w zadaniach zostaje stabilna, bo agentowi wystarcza sąsiedni plan. Wniosek jest taki, że robotę robi ponumerowana lista kroków, a nie opis kontekstu projektu.
Najnowszy Grok wchodzi tam, gdzie firmy już mają fakturę
4 min
Grok 4.6 trafił 21 sierpnia do Model Garden na Vertex AI, więc zespoły na Google Cloud dopisują go do rachunku, który i tak płacą, zamiast przepychać umowę z nowym dostawcą. Reklamowana stawka 2 dolarów za milion tokenów wejściowych obowiązuje jednak tylko do 200 tysięcy tokenów w zapytaniu, a powyżej progu podwaja się dla całego zapytania. Artificial Analysis wycenia jedno domknięte zadanie na 0,84 dolara przy średnio 53 turach, o połowę krócej niż Claude Opus 5 Max. W tle toczą się trzy postępowania wobec X i SpaceXAI: Ofcomu, brytyjskiego urzędu ochrony danych i Komisji Europejskiej.
Slack wpuszcza agentów kodujących do wspólnego kanału, żeby zespół patrzył im na ręce
5 min
Slack Code, ogłoszony przez Salesforce 20 sierpnia, wpuszcza agentów kodujących pięciu dostawców, w tym Claude Code i Devina, do wspólnych kanałów, w których cały zespół widzi każdy krok i może agenta zawrócić, a on działa wyłącznie na uprawnieniach osoby, która go wezwała. Jawność ma być lekarstwem na słaby kod, tylko że dotyczy pisania, a nie sprawdzania. Cognition podaje dziesięciokrotny wzrost liczby zmergeowanych pull requestów przy wzroście zatrudnienia o 40%, a kontrola została w GitHubie i jest jej dokładnie tyle samo, co wcześniej.
Kod przestał być drogi, utrzymanie nie
4 min
Avery Pennarun z Tailscale twierdzi, że narzędzia AI przesuwają drobne programy z kategorii "nie warto się za to brać" do "zrobię po obiedzie", i proponuje test trzech pytań: czy ktoś poza tobą już na tym polega, czy program rusza wrażliwe dane i czy jego awaria zatrzymałaby czyjąś pracę. Test jest dobry, tylko zadany o pół roku za wcześnie, bo narzędzie robi się ważne dopiero wtedy, gdy ktoś wpisze je do procedury. Pisanie kodu potaniało, ale drugi rachunek, czyli zmienione API, przegląd uprawnień i niezgodne liczby w panelu, wraca co miesiąc.
Agent do terminala, który ostrzega przed własnymi wtyczkami
4 min
OpenCode to agent open source odpalany jedną komendą w terminalu, który nie ma w środku własnego modelu, więc podłączasz dowolnego dostawcę i płacisz mu bezpośrednio za tokeny. Zamiast chwalić się długą listą integracji, dokumentacja otwiera stronę o MCP ostrzeżeniem: opisy narzędzi z każdego serwera jadą do modelu przy każdym zapytaniu, a ten od GitHuba potrafi rozsadzić okno kontekstowe. Tryb planu pod klawiszem Tab i komenda /undo trzymają agenta z dala od plików, dopóki plan się nie zgadza, choć w dokumentacji nie ma ani jednego wyniku benchmarku.
Meta oddaje 30-miliardowego agenta za darmo, jeśli masz na czym go uruchomić
5 min
Meta wypuściła 10 sierpnia Muse Glimmer, agentowy model o 30 miliardach parametrów, i oddała jego wagi za darmo na licencji Apache 2.0, dzięki czemu autonomiczny agent może planować zadania, wywoływać narzędzia i pisać kod lokalnie, bez opłat za API. Darmowy jest jednak tylko model, bo po kwantyzacji do 4 bitów potrzebuje maszyny z 24 do 32 GB pamięci, na przykład RTX 4090 albo MacBooka Pro z M4 Max. Na testach agentowych prowadzi, 51,2 na SWE-Bench Pro wobec 36,9 Gemmy i 50,2 Qwena, ale w terminalu przegrywa z Qwenem, a wszystkie liczby pochodzą od samej Mety.
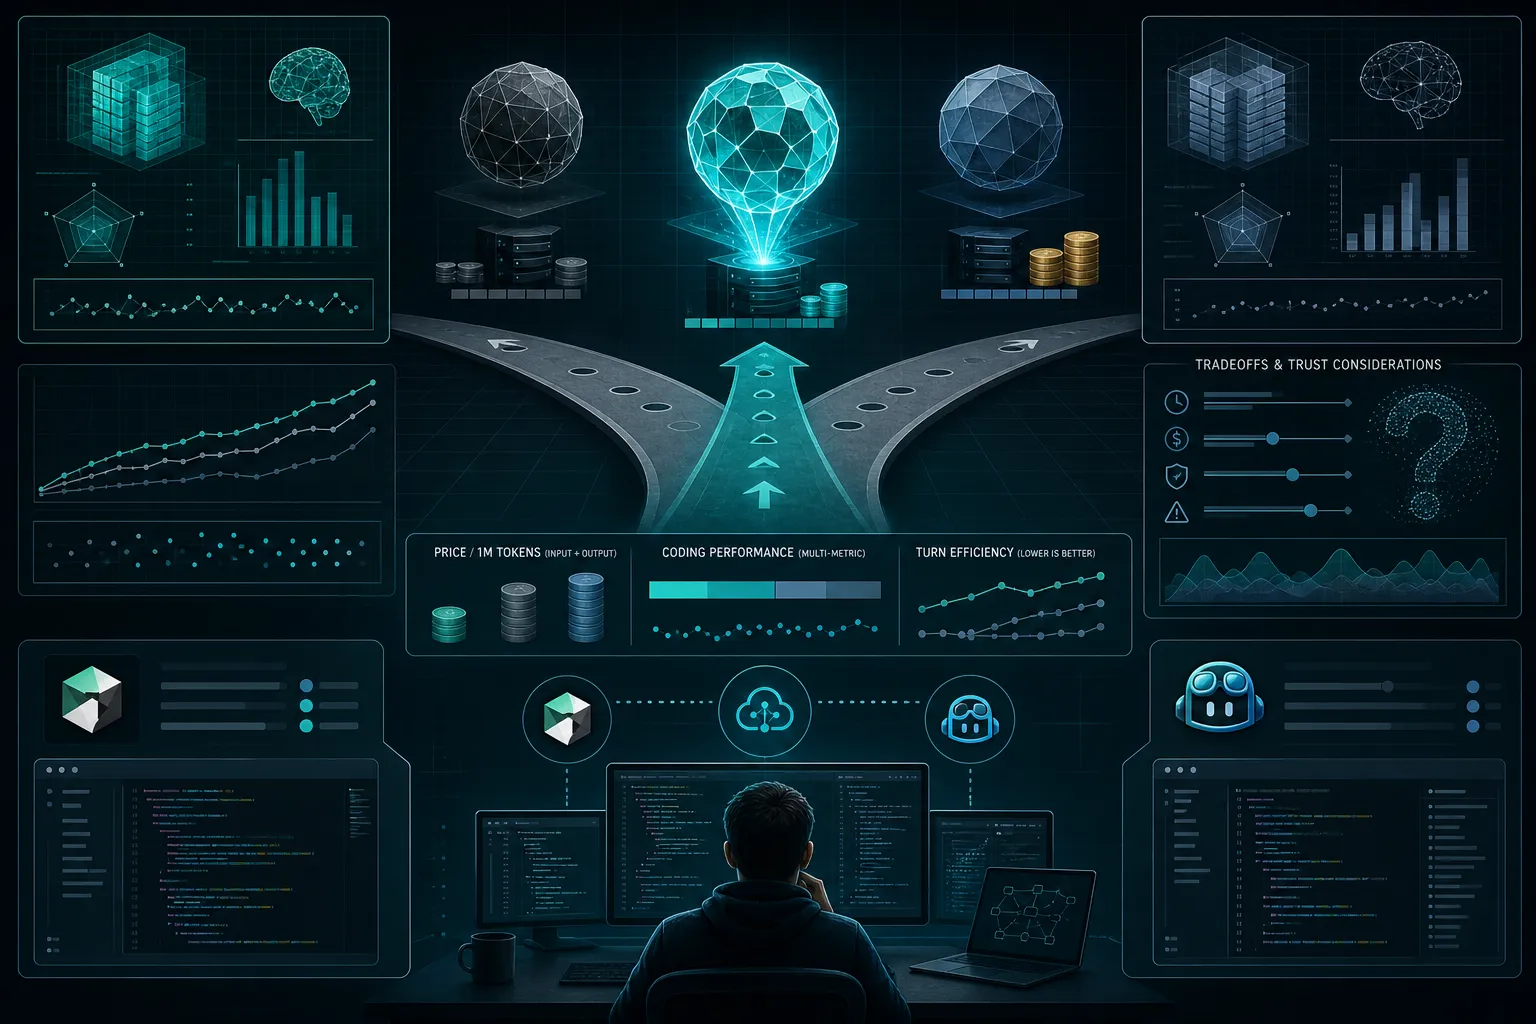
Grok 4.6 wchodzi do pierwszej ligi modeli, ale bez korony
4 min
Grok 4.6 od xAI zdobył 61 punktów w Artificial Analysis Intelligence Index, trzeci wynik na świecie tuż za Fable 5 i Claude Opus 5, ale to nie nowy model, tylko lepiej douczony Grok 4.5. Na benchmarkach kodowania, które liczą się w prawdziwej robocie, wciąż goni rywali: 65,9% na DeepSWE wobec 73% u GPT-5.6 Sol. Prawdziwym argumentem jest cena, ponad 60% niższa niż u konkurencji, choć powyżej 200 tysięcy tokenów stawki się podwajają. Mimo deklaracji Muska o numerze jeden to świetny model do przetestowania, nie powód, żeby rzucać dotychczasowe narzędzia.
NVIDIA wypuściła model, który sam przyznaje, że nie poprowadzi twojego agenta
4 min
NVIDIA wypuściła 11 sierpnia Nemotron 3.5 Lightning, otwarty model MoE o 30 miliardach parametrów, z których przy każdym tokenie pracują tylko 3 miliardy, co daje do czterech razy szybsze generowanie tokenów. Świetnie radzi sobie z wąskimi zadaniami (85 punktów na PinchBench), ale w pracy agenta się rozsypuje: na Terminal-Bench 2.1 dostaje 24,58, podczas gdy Meta Muse Glimmer robi 51,7. Dlatego NVIDIA sprzedaje go nie jako agenta, lecz taniego wykonawcę, a z biblioteką NeMo Switchyard, kierującą kroki agenta do najlepszego modelu, LangChain zbił koszt o 74%.
DeepSeek otwiera harness i tego samego dnia podnosi ceny API
4 min
W zeszły czwartek DeepSeek wypuścił DeepSeek Harness (dsh): darmową, otwartą na licencji MIT warstwę, która stoi między programistą a modelem i konkuruje z Claude Code oraz Codexem. Motto brzmi "wszystko jest wtyczką", więc pod harness podłączysz dowolny model, nie tylko DeepSeeka. Tego samego dnia firma podniosła ceny swojego API, według Reutersa miejscami o ponad 1000%. Moim zdaniem to wyrachowany ruch: DeepSeek rozdaje najtrudniejszą do wymiany warstwę za darmo, żeby podważyć przewagę rywali, a pieniądze zamierza brać na droższym API.
Klucze i dane logowania wyciekają z zaszyfrowanych bloków rozumowania
4 min
Zaszyfrowane bloki rozumowania, które modele Anthropic, OpenAI i Google odsyłają przez API, chronią własność dostawcy przed tobą, a nie twoje dane przed kimkolwiek innym. Praca z 10 sierpnia na arXiv pokazuje, że są w pełni wymienne między sesjami i modelami jednego dostawcy, więc słabszy model tej samej firmy odczyta podsunięty blok czystym tekstem, bez łamania szyfru. Z publicznych repozytoriów badacze wydobyli tą metodą 367 fragmentów danych osobowych i 182 komplety danych logowania. Wniosek: zaszyfrowany zapis sesji trzeba traktować jak zwykły tekst jawny i nie wrzucać go na GitHuba.
Na krótkim teście modele wyglądają świetnie, na długim kontekście padają o 47%
4 min
Praca "Cracks in the Foundation" (COLM 2026, arXiv 10 sierpnia) zespołu Amandy Bertsch pokazuje, że cztery pozornie błahe decyzje architektoniczne, każda z osobna niegroźna, kumulują się i obniżają jakość modelu na długim kontekście nawet o 47%. Spadku nie widać ani po stracie treningowej, ani na krótkich benchmarkach, więc model wyglądający zdrowo na standardowych testach zawodzi dopiero na długim wejściu. Zespół udostępnił OlmPool, 26 porównywalnych modeli po 7 mld parametrów, i twierdzi, że kiepską kombinację da się wyłapać już wcześnie w treningu.