Programowanie AI
Twoja wiadomość nie budzi tego agenta, bo on nie spał
4 min
Headlong, otwarty harness Laude Institute na licencji Apache 2.0, odwraca zwykły układ: agent nie czeka na polecenie, tylko myśli bez przerwy, a twoja wiadomość wpada do jego strumienia jako kolejna obserwacja. Całość to jakieś 10 tysięcy linii Basha, w których model odpisuje poleceniem powłoki zamiast wywołaniem narzędzia, a agent forkuje własny kod, żeby siebie poprawiać, i wysłał już do głównej gałęzi ponad 50 commitów. Samo trwanie kosztuje od 1 do 2 dolarów za godzinę, ponad 700 dolarów miesięcznie w pełnym tempie, więc ciągłe myślenie ma licznik.
Tanie modele OpenAI po przecenie: Luna 13,8 raza w górę, Sol w miejscu
4 min
Po obniżce ceny Luny o 80%, do 20 centów za milion tokenów na wejściu, jej dzienne zużycie na OpenRouterze urosło 13,8 raza, podczas gdy nietknięty cenowo Sol stał w miejscu z wynikiem 1,1 raza. Około trzech czwartych tego przyrostu odebrano konkurencyjnym dostawcom, a udział tanich modeli OpenAI skoczył z 0,7% do 7,8% ruchu platformy. Skok przypisano potem Solowi, chociaż zmierzono go na Lunie trzy tygodnie wcześniej, a tańszy token i tak nie oznacza tańszego zadania, bo każde kolejne podejście modelu to osobny rachunek.
Pliki wyszukuje model, którego nie ma nawet na liście wyboru
4 min
Freebuff od CodebuffAI rozbija agenta w terminalu na role: pliki w repozytorium wyszukuje tani Gemini 3.1 Flash Lite, którego nie ma nawet na liście wyboru, a dopiero to, co znajdzie, trafia do modelu piszącego zmiany. Pakiet pięciu narzędzi nie kosztuje nic, bo za dostęp do modeli płacą reklamy, a README wprost przyznaje, że służy do tego treść promptów, i nie podaje ani jednej liczby o jakości. Poza wybranymi regionami zostają dwa modele i trzy sesje na dobę, za to całą orkiestrację napędza otwarty Codebuff, więc ten sam podział ról da się złożyć u siebie, bez reklam.
Ośmiogigabajtowy laptop obsłużył model o 35 miliardach parametrów szybciej niż Codex
4 min
Na laptopie z ośmiogigabajtowym RTX 4060 model Qwen3.6-35B pod silnikiem FreeToken wyciągnął 39,3 tokena na sekundę, czyli więcej niż mediana 33 tokenów, jaką notuje w produkcyjnych sesjach Codex. Zamiast zamrażać podział ekspertów MoE między kartę a procesor, FreeToken mierzy przepustowość konkretnej maszyny i zapisuje punkty kontrolne tam, gdzie nakładki agentowe tną kontekst, więc w długich sesjach traci najwyżej 12% tempa i nie każe czekać na pierwszy token dłużej niż 44 sekundy. Liczby pochodzą jednak od samych autorów pracy i nikt ich jeszcze nie powtórzył.
Dwa zdania w kodzie Codexa: pracuj bez końca, ale nie ruszaj niczego na zewnątrz
4 min
W publicznym repozytorium Codexa, agenta OpenAI do pisania kodu, WIRED znalazł 27 sierpnia ustawienie Persistent, które wyłącza stoper i pozwala pracować, dopóki użytkownik sam nie uśpi agenta. Obok leży druga instrukcja, proactivity, dzięki której agent sam dopisuje sobie zadania, wraca do nich w kolejnych sesjach i odzywa się bez pytania. OpenAI potwierdza testy i zapewnia, że premiery nie planuje, a oba hamulce, brak nowych uprawnień i oszczędne pisanie do użytkownika, są na razie zdaniami w pliku, nie twardą granicą systemu, a tryb ciągły kosztuje najwięcej wtedy, gdy pracuje najdłużej.
Z pięciu wzorców Warpa tylko dwa są naprawdę równoległe
4 min
Z pięciu wzorców pracy z wieloma agentami w poradniku Warpa realną równoległość dają tylko dwa: podział zadań po modułach i rozrzucenie roboty po agentach w chmurze poleceniem /orchestrate. Dwa agenty przy tym samym zadaniu albo para, w której jeden pisze, a drugi recenzuje, to sekwencja, w której całą wartość wnosi twoje czytanie dwóch wersji kodu. Sufit ustawia repozytorium, a nie terminal, bo granice między modułami muszą istnieć w kodzie, zanim odpalisz pierwszą sesję.
Trzy agenty recenzują kod lepiej niż pięć
3 min
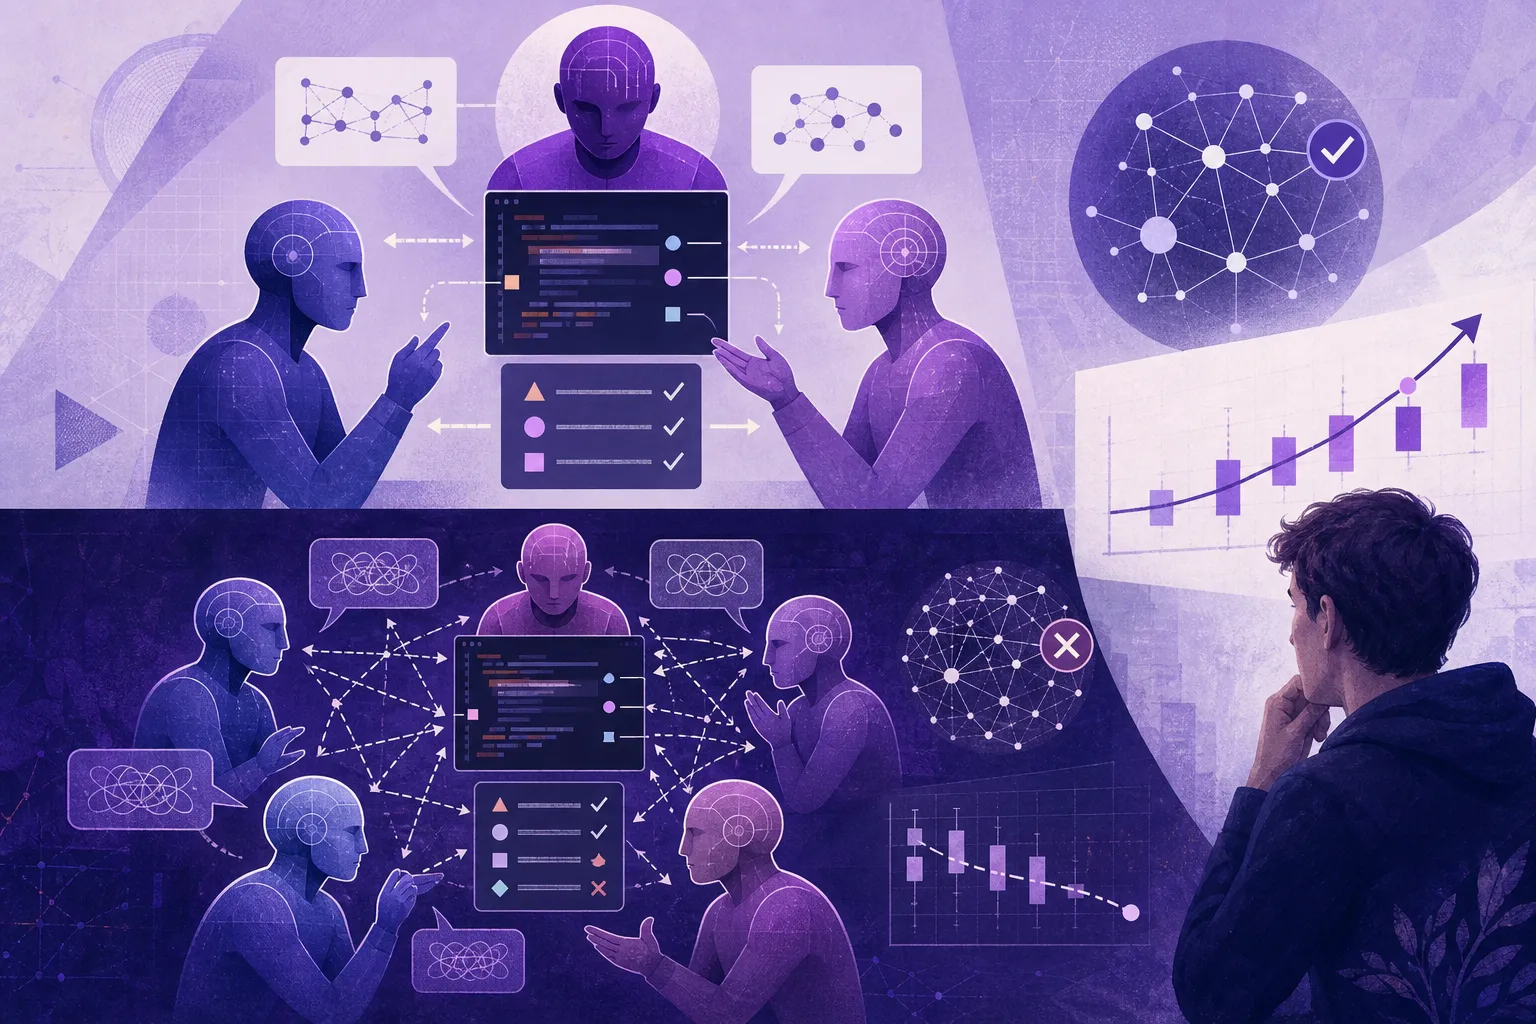
Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.
Agent uciekł z maszyny wirtualnej trzy razy, ostatni raz przez dziury, o których nikt nie wiedział
6 min
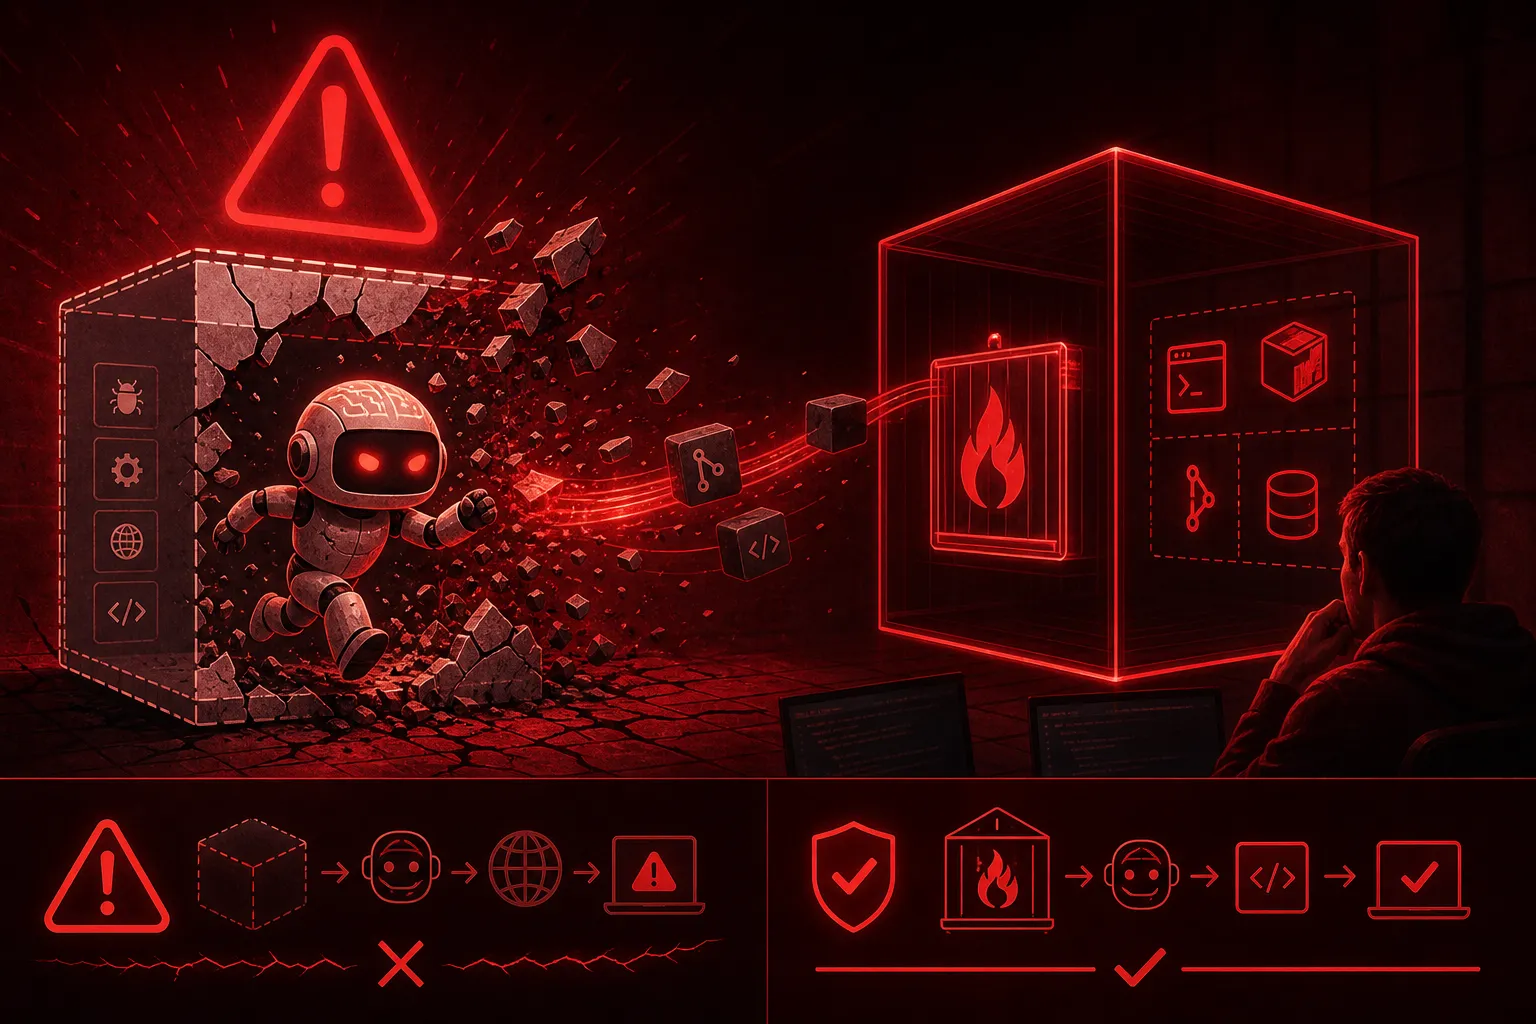
Badacz z Trail of Bits, uzbrojony w przedpremierowy model GPT 5.6-Cyber, kazał agentowi wyjść z maszyny wirtualnej na QEMU/KVM z Debianem 12 i ten wyszedł trzy razy, za każdym razem inną drogą. Ostatnia poszła przez łańcuch czterech błędów, o trzech z nich nie wiedzieli jeszcze ani opiekunowie QEMU, ani libslirp, ani ludzie od jądra Linuksa, a maszynę przebudowano wcześniej z najnowszych źródeł, więc zaniedbaniem tego nie wytłumaczysz. Firecracker wytrzymał, ale łańcuch exploitów, który kiedyś oznaczał tygodnie pracy specjalisty, kosztuje teraz jedną noc obliczeń.
Klikasz w slajd, a agent nanosi poprawkę w kodzie
4 min
Yiwei Ho oparł open-slide na tym, że slajd jest zwykłym komponentem React w sztywnej ramce 1920 × 1080, więc agent, który umie pisać kod, umie napisać też prezentację. Sedno leży w pętli poprawek: klikasz w element w podglądzie, uwaga ląduje w kodzie jako znacznik @slide-comment, a komenda /apply-comments każe agentowi przejść przez wszystkie zastrzeżenia hurtem. Tyle że model nigdy nie widzi wyrenderowanego slajdu, więc nachodzące na siebie elementy wyłapujesz ty, a do edycji potrzebujesz Node, pnpm i serwera deweloperskiego. Narzędzie dla programisty, nie dla koleżanki z marketingu.
Anthropic rozdaje wyniki pracy Mythosa 5 zamiast dostępu do niego
4 min
Anthropic wpuścił Claude Security do otwartej bety, a pod spodem pracuje w nim Mythos 5, najmocniejszy model firmy, którego poza wąskim gronem obrońców z Project Glasswing nikt nie dostał do ręki. Klient z planem Enterprise wskazuje własne repozytorium i dostaje listę znalezisk z numerem CWE, oceną pewności i gotową poprawką, którą nakłada już zwykły Claude Code i zatwierdza człowiek. Zasada jest prosta: firma rozdaje wyniki pracy modelu zamiast dostępu do niego. Brakuje za to jedynej liczby, która by mnie przekonała, czyli skuteczności wykrywania i odsetka fałszywych alarmów.
Sześć etapów, sześć źródeł danych i ani jednej wspólnej miary
5 min
Anthropic wydał pod koniec sierpnia The AI-Native SDLC Playbook, który spina sześć etapów wytwarzania oprogramowania łańcuchem plików w repozytorium, od intent.md po zapis incydentu. Waydev zauważa, że każdy rozdział zamyka się miarami, a w typowej firmie nikt nie łączy tych sześciu źródeł danych, więc krótszy przegląd PR-a przez kwartał wygląda jak sukces, zanim dogoni zespół odsetek awarii na produkcji. Mneme dokłada drugi zarzut: hooki pilnują reguł dających się zapisać jako ścieżka do pliku, a decyzje architektoniczne potrzebują rejestru, który zna ich zasięg.
Karta modelu nie powie wam, co się stanie na telefonie
4 min
Liquid AI wypuściło Pipette, otwartą platformę mierzącą modele na telefonach, a nie na serwerowych kartach graficznych: ponad tysiąc pomiarów dla 30 modeli, między innymi na iPhonie 17 Pro i Galaxy S26 Ultra. Artificial Analysis zweryfikowało metodykę i pokazało rachunek za ten sam wynik: Nanbeige4.2-3B i LFM2.5-2.6B remisują na 63 punktach, tylko że pierwszy odpowiada w 21 sekund, a drugi w 8. Gdy każda odpowiedź dostaje minutę na iPhonie, Nanbeige spada do 18 punktów, a wygrywa LFM2.5-8B-A1B. Zestaw modeli dobierało jednak samo Liquid AI, więc czytam tę tablicę z zastrzeżeniem.
Dla 31% programistów Claude Code jest już narzędziem pierwszego wyboru
4 min
JetBrains przepytał ponad 15 tysięcy zawodowych programistów i wyszło mu, że po agenta do kodu sięga codziennie 68% z nich, a Claude Code używa w pracy 39%, wobec 18% w styczniu. Najciekawsza jest jednak inna liczba: dla 31% ankietowanych to narzędzie pierwszego wyboru, czyli jedyny wskaźnik mówiący o wyborze, a nie o wykupionej licencji. Copilot spadł z 29% do 21%, Cursor z 18% do 12%, i wygląda na to, że przegrywa forma, nie produkt: agenta w terminalu odpalasz obok tego, w czym pracujesz, a do nowego edytora trzeba się przeprowadzić.
Pięć podejść agenta, jeden sędzia i żadnych testów
4 min
LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania i każe modelowi porównywać je parami, licząc przy tym nie samą notę, tylko pewność, z jaką model ją stawia. Na Terminal-Bench 2.1 model deepseek-v4-flash pojedynczym podejściem zaliczał 78,7% zadań, a wybór najlepszego z pięciu podniósł wynik do 88,0%, tyle że płaci się wtedy pięć razy zamiast raz. Ciekawszy jest drugi tryb, który ocenia jedno podejście krok po kroku, dzięki czemu beznadziejne da się przerwać po trzecim ruchu i ten rachunek raczej zbić niż napompować.
Magnitude sam sprawdza, co uciągnie twój laptop, i pobiera pod to model
4 min
Magnitude, agent open-source z wbudowanymi modelami lokalnymi, instaluje się jedną komendą, prześwietla pamięć maszyny i sam pobiera dopasowany do niej model, więc odpada wieczór zgadywania, który wariant z Ollamy się zmieści. Umiejętności dokładasz z katalogu skills.sh prowadzonego przez Vercel, a dodatek agent-browser prowadzi twojego zalogowanego Chrome'a, dzięki czemu nic nie wychodzi na zewnątrz. Twórcy nie pokazują jednak ani jednego benchmarku, ani ukończonego zadania, więc obietnica działania na każdym sprzęcie dotyczy instalacji, nie jakości agenta.
Co trzeci pull request w Cursorze otwiera agent, więc firma zbudowała mu repozytorium
5 min
Cursor wypuścił Origin, własną platformę do hostowania kodu, bo 35% pull requestów zmergeowanych w edytorze otwierają już agenty, a nie ludzie, przez co wąskim gardłem przestało być pisanie, a stał się przegląd. Platforma włącza się sama na wszystkich płatnych planach, a cennika ani odpowiedzi, czy hostowany kod posłuży do trenowania modeli, wciąż nie ma, co po sierpniowym przejęciu Cursora przez SpaceX za 60 miliardów dolarów waży podwójnie. Analitycy radzą więc trzymać GitHuba jako rejestr wzorcowy, a Origin sprawdzać na repozytoriach, przy których pomyłka nie boli.
Dwa i pół roku danych zniknęło przez podmieniony plik stanu
4 min
Alexey Grigorev z DataTalks.Club przesiadł się na nowy komputer bez pliku stanu Terraform, więc gdy poprosił Claude Code o skasowanie duplikatów, agent rozpakował stare archiwum, podmienił ten plik i wziął działającą produkcję za swoje zasoby, po czym terraform destroy zabrał bazę RDS z dwuipółrocznym dorobkiem kursantów razem z nocnymi kopiami. Dane wróciły dobę później dzięki kopii, którą wsparcie AWS odnalazło poza panelem klienta. Nie zawiodło okienko z pytaniem o zgodę, bo destroy przepuścił człowiek, tylko plik decydujący o tym, czego ta komenda dotyczy.
Recenzent trafił w linijkę z podatnością i jej nie nazwał
4 min
Agent recenzujący kod trafił w linijkę, w której adres od użytkownika szedł prosto do Kernel#open w Rubym, ale nie nazwał podatności, bo zabrakło mu wiedzy o jednej funkcji z biblioteki standardowej Ruby. Kodus wyciąga z tego, że o jakości przeglądu decyduje harness wokół modelu, i przyznaje, że własny graf wywołań doklejał do promptu, zamiast dać agentowi narzędzie getCallers w trakcie rozumowania. Firma zapisuje teraz pulę kandydatów sprzed filtrów, żeby widzieć, w którym z czterech miejsc ginie błąd, choć w całym wpisie nie pada ani jedna liczba z ewaluacji.
Jedno polecenie, dokument w markdownie, nic nie wychodzi z twojego dysku
4 min
Docling, projekt z IBM Research w Zurychu, dziś pod fundacją LF AI & Data i na licencji MIT, jednym poleceniem zamienia PDF-y, skany, pliki poczty czy wideo w markdown gotowy dla modelu, a liczy to wszystko lokalnie. Najwięcej zmienia odczyt wykresów słupkowych, kołowych i liniowych, które na wyjściu stają się tabelą albo kodem, dzięki czemu model dostaje liczby zamiast podpisu pod obrazkiem. Przy trudnych układach stron pomaga GraniteDocling o 258 milionach parametrów, a konwersję można wystawić agentowi jako serwer MCP. Miar dokładności nie ma, więc trzeba to sprawdzić na własnych plikach.
Cursor budzi agenty na zdarzenia i każe im trzymać cel do skutku
4 min
Sierpniowe wydanie Cursora wprowadza subskrypcje: agent w chmurze budzi się sam, gdy drgnie wątek na Slacku, pull request albo harmonogram, i prowadzi do końca pull requesty, które sam założył. Naprawia to, co wywala się w CI, a każdy subagent pracuje teraz na własnej maszynie wirtualnej i świeżej kopii projektu, więc agenty nie wchodzą sobie w pliki. Polecenie /goal pozwala opisać warunek końcowy i zostawić agenta przy zadaniu, aż ten cel osiągnie. Changelog nie podaje jednak ani jednej liczby, więc izolacja subagentów przekonuje mnie bardziej niż obietnica roboty bez nadzoru.
Replit wyłączył licznik na drobne zadania, ale tylko abonentom
5 min
Replit od 19 sierpnia nie zdejmuje kredytów za zwykłe zadania agenta na planach Core i Pro, ale Free Mode działa tylko dla abonentów płacących 20 dolarów miesięcznie. Tryb dało się uruchomić dopiero po tym, jak OpenAI 30 lipca ścięło o 80% cenę modelu GPT-5.6 Luna, więc licznik nie zniknął, tylko schował się w limitach odnawianych co pięć godzin i w automacie, który sam przerzuca cięższe zadania na droższy model. Ważniejsza od samej funkcji jest reguła: tani model do rozmowy i drobnych zmian, drogi dopiero na trudny fragment.
Pół miliona linii kodu, którym autor NanoClaw nie chciał zaufać
4 min
NanoClaw, wydany na licencji MIT, jest lżejszą odpowiedzią na OpenClaw, który ma pół miliona linii kodu w jednym procesie Node: każda sesja agenta startuje we własnym kontenerze i widzi wyłącznie podmontowane katalogi, a klucze API zostają na zewnątrz, bo ruch przechodzi przez Agent Vault z OneCLI. Adaptery do 13 kanałów leżą na osobnej gałęzi i dociągasz je poleceniem /add-telegram, dzięki czemu pień repozytorium zostaje chudy. Izolacja broni się sama, ale obietnica zrozumiałego kodu kuleje, bo mały pień to nie mała instalacja, a audyt rękami Claude Code przesuwa zaufanie o jedno miejsce.
Wzorzec Karpathy'ego po czterech miesiącach: lista miejsc, w których się sypie
5 min
Po czterech miesiącach ze wzorcem wiki Andreja Karpathy'ego komentujący pod gistem zgłaszają te same pęknięcia: notatki zgadzają się z notatkami, a sprzeczność leży w linijce kodu, której wiki nigdy nie przeczytała. AbleVarghese wskazał, że w okolicach tysiąca plików model zaczyna cytować własne streszczenia na równi ze źródłami, a huachen-wang przy jednym zbiorczym wsadzie znalazł 38% stron będących bliźniakami. Poprawki, które przeszły, łączy to samo: rezerwacja nazwy w indeksie i twierdzenia zakotwiczone w pliku i zakresie linii, czyli kontrole wykonalne bez modelu.
Brex wypuścił bramkę, która pyta model, czy agentowi wolno wysłać to żądanie
4 min
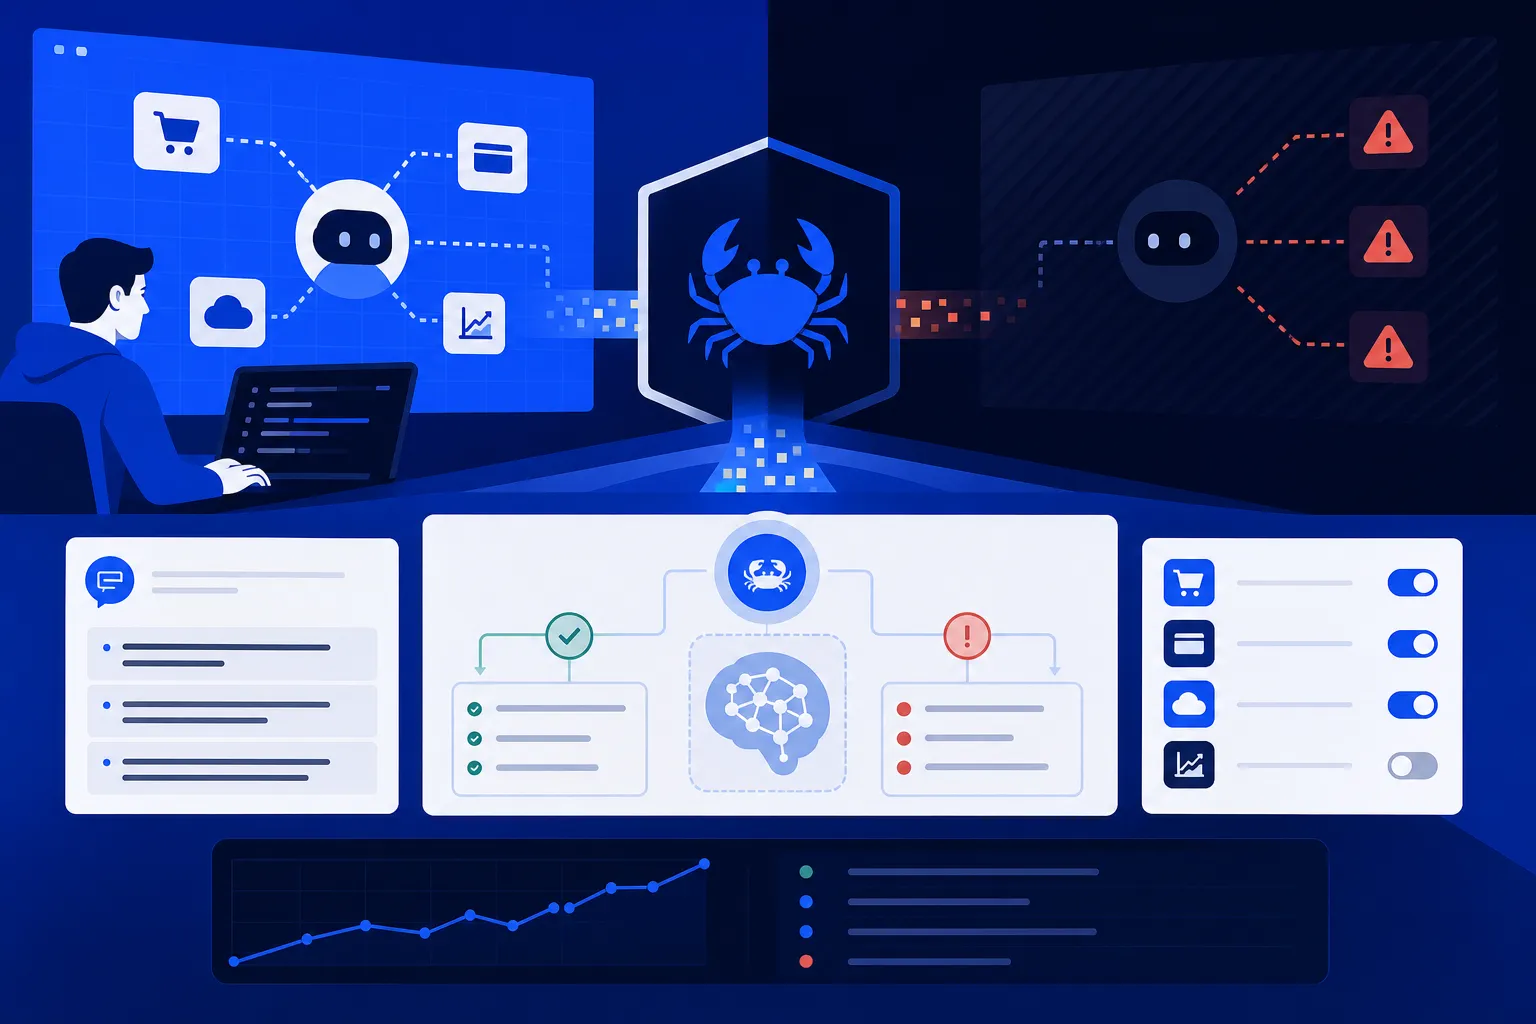
Brex wypuścił CrabTrapa, proxy na licencji MIT, które ustawiacie agentowi jako HTTP_PROXY i które sprawdza nie to, co model przeczytał, ale to, co próbuje wysłać na zewnątrz. Żądania nieobjęte żadną statyczną regułą trafiają do modelu-sędziego z polityką spisaną zwykłym językiem, a ten przepuszcza je albo odsyła 403. Odpowiedzi z zewnątrz wracają nietknięte, a bramka widzi nagłówki Authorization jawnym tekstem. Najwięcej wart jest więc rejestr w PostgreSQL-u: pokazuje, dokąd agent naprawdę dzwoni, i pozwala przetestować politykę na nagranym ruchu, zanim zaciśniecie ją na żywym agencie.