Programowanie AI
Claude Code w pudełku za 40 dolarów, czyli Siri, które naprawdę działa
6 min
Leon Furze przez kilka wieczorów zamienił kieszonkowy komputerek M5Stack Cardputer za czterdzieści dolarów w głosowego asystenta: przytrzymujesz klawisz, mówisz, a stojący w domu Mac mini rozpoznaje mowę, przepuszcza ją przez agenta Claude Code i odpowiada na głos, działając nawet przez hotspot z drugiego końca kraju dzięki tunelowi Tailscale Funnel. To Siri, które naprawdę wykonuje zadania na komputerze, ale całość trzyma agent z celowo rozluźnionymi zabezpieczeniami i miękka, głosowa bramka potwierdzeń, więc sam autor traktuje to jako działający dowód koncepcji, nie wzorzec do powielania.
Stare praktyki, wyższa stawka: czego LY Corporation nauczyło się, puszczając agenty na kod
5 min
Inżynierowie z LY Corporation, twórcy Flava API Gateway, opisali, że agenty kodujące nie psują starych zasad dobrego programowania, tylko je obnażają: to, co człowiek nadrabiał uwagą, agentowi trzeba podać wprost, jako automatyczne kontrole. Ich trzy filary to spisanie specyfikacji przed kodem, szybka weryfikacja przez testy i lintery (2754 testów w jakieś 15 sekund dzięki izolacji schematów) oraz powtarzalne środowisko na Devenv i Nix. Dyscyplina, którą dawniej można było po cichu wyciąć pod presją terminu, przy agencie przestaje być opcją.
Tani model rozmawia, drogi model pisze: wzorzec STORM ze Stanfordu
4 min
STORM ze Stanfordu bierze dowolny temat, sam przeszukuje sieć i składa z tego raport z przypisami w stylu Wikipedii, ale najciekawsza jest tu inżynieria, nie efekt. Research rozbito na symulowaną rozmowę autora z ekspertem, dzięki czemu rodzą się pytania głębsze niż te, które model wymyśli na zawołanie. Najpraktyczniejsza lekcja siedzi w konfiguracji: tańszy model prowadzi rozmowę i rozbija zapytania, a mocniejszy pisze finalny tekst z cytatami, gdzie liczy się wierność źródłom. To wzorzec do przeniesienia do własnego projektu, nawet jeśli STORM nie produkuje tekstów gotowych do publikacji.
Bezpieczna piaskownica jako główny argument nowego agenta WordPressa
4 min
WordPress.com przeniósł agenta Studio Code z terminala do okienkowej aplikacji na macOS, Windows i Linux, zastępując dotychczasowego asystenta AI i udostępniając go za darmo na czas testów. Mówisz mu po ludzku, czego chcesz, a on sam rozkłada to na kroki: stawia stronę, instaluje wtyczki, robi audyt wydajności. Najważniejsze nie jest jednak na liście funkcji, tylko w tym, że agent pracuje na lokalnej kopii, a produkcja nie zmienia się o znak, dopóki sam świadomie nie zsynchronizujesz zmian, dzięki czemu pomyłka agenta jest tania, a nie groźna.
GLM-5.2 dorównuje Opusowi w kodowaniu za szóstą część ceny. Tylko jak go uruchomić?
6 min
GLM-5.2, model z otwartymi wagami chińskiej firmy Z.ai, dogonił czołówkę w kodowaniu: w Code Arena jest drugi, a odtworzenie pracy badawczej kosztowało go 6,21 dolara wobec 46,35 u Opusa 4.8. Parytet kończy się przy najtrudniejszym rozumowaniu, gdzie chińskie modele wciąż zostają w tyle. Haczyk jest praktyczny: lokalne uruchomienie wymaga około 1,5 terabajta pamięci GPU, a tanie API Z.ai oznacza, że kod wędruje przez serwery pod chińskim prawem wywiadowczym. Geopolityka staje się więc kosztem ukrytym w narzędziu, nie ciekawostką obok niego.
Envoy AI Gateway 1.0: jeden adres dla wszystkich modeli i pierwsza brama dla MCP
4 min
Tetrate wydał wersję 1.0 Envoy AI Gateway, otwartej bramy stojącej na sprawdzonym serwerze Envoy z Lyfta, która chowa OpenAI, Anthropic, Gemini czy Mistral za jednym interfejsem zgodnym z formatem OpenAI, więc przerzucenie ruchu na tańszego dostawcę staje się zmianą wpisu w konfiguracji. Nowością jest wbudowana obsługa MCP, czyli wspólny punkt, w którym administrator filtruje, z jakich narzędzi może korzystać dany agent. Współzałożyciel Varun Talwar zapewnia, że publiczny kod chodzi na produkcji w Bloombergu, ale poza współtwórcami projektu wiarygodnych referencji wciąż brakuje.
Google wbudował sterowanie komputerem w model, który i tak już odpalasz
5 min
Google przeniósł sterowanie komputerem do Gemini 3.5 Flash, czyli szybkiego i taniego modelu, który deweloperzy i tak już mają podpięty pod aplikacje. Zamiast osobnego modelu jeden agent widzi ekran i klika jak człowiek, dzięki czemu wchodzi tam, gdzie nie ma API, choćby w stary firmowy system. Google podaje wynik 78,4% na OSWorld-Verified, ale to deklaracja producenta, nie dowód. Kluczowe zabezpieczenia, czyli potwierdzanie wrażliwych działań i blokada wstrzykniętych instrukcji, są opcjonalne, więc ryzyko spada na deweloperów.
Bitbucket chce być centralą dla agentów w CI/CD. Codex to dopiero druga wtyczka
3 min
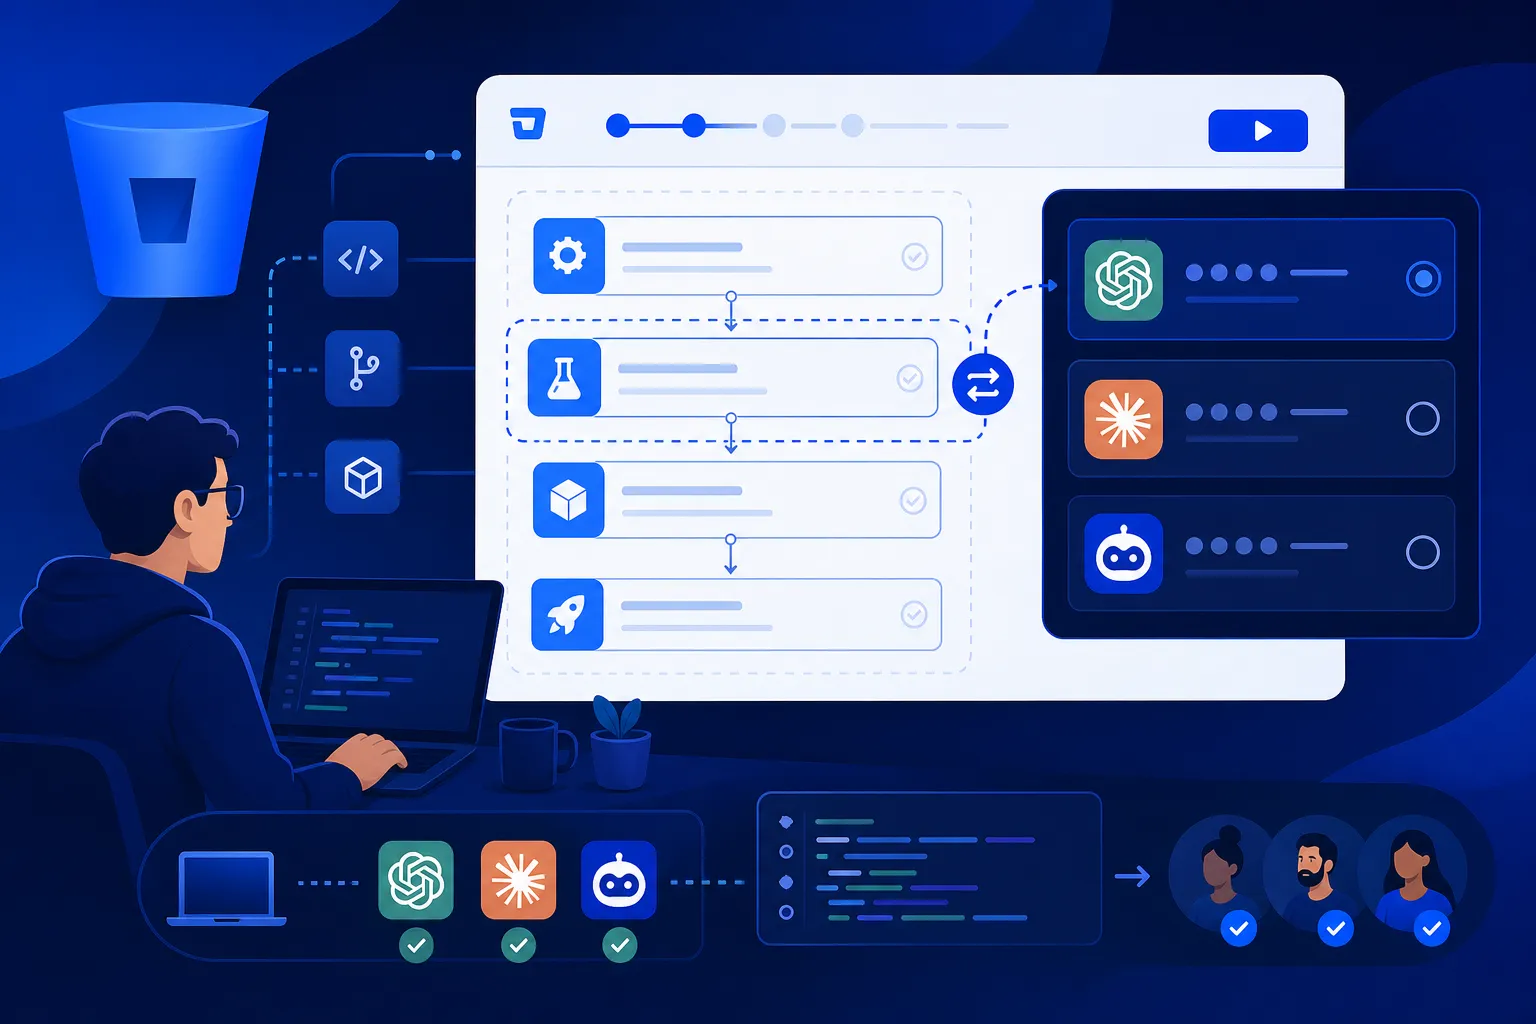
Atlassian dodał do Bitbucket Pipelines obsługę agenta Codex od OpenAI, który dochodzi jako trzeci wybieralny agent po własnym Rovo Dev i po Claude od Anthropica. Wystarczy jedna linijka w pliku konfiguracyjnym (provider: codex), żeby podmienić agenta bez przebudowywania procesu, bo reszta pipeline'u, dostęp do kodu, sekretów i serwerów MCP, zostaje na miejscu. Atlassian sprzedaje to jako neutralną centralę dyrygującą agentami w CI/CD. Haczyk: to open beta z wyborem z zaledwie trzech agentów, a korzystanie z Codeksa oznacza, że kod, prompty i logi trafiają do OpenAI.
Ornith-1.0 chwali się, że bije Opus 4.7. Tabela pokazuje co innego
5 min
DeepReinforce wypuściło 25 czerwca rodzinę modeli Ornith-1.0 na licencji MIT i ogłosiło, że największy wariant 397B bije Claude Opus 4.7 na SWE-Bench Verified (82,4) i Terminal-Bench 2.1 (77,5). Ta sama tabela pokazuje jednak Opus 4.8 z wynikiem 87,6, czyli wyżej, więc marketing wybrał sobie starszy model do pokonania, a komentatorzy tacy jak Teortaxes uznali wyniki za podejrzane do czasu niezależnego testu. Realna stawka leży niżej: model z otwartymi wagami, którego wariant 9B chodzi na domowym pececie, trzyma dane u siebie i nie generuje rachunku za tokeny.
Testy pisze już AI. TypeMock chce sprawdzać, które z nich mają sens
4 min
Skoro asystenci AI generują testy jednostkowe szybciej, niż ktokolwiek zdąży je przejrzeć, TypeMock ogłosił 22 czerwca narzędzie Test Review, które ma wskazywać, które z nich warto trzymać. Zamiast czytać sam kod, obserwuje testy w trakcie wykonania: ile kodu realnie dotykają i czy nie ukrywają zależności od plików czy sieci, które stoją za migającymi testami. Założyciel Eli Lopian ujmuje to wprost: przechodzący test nie jest automatycznie przydatny. Diagnoza jest trafna, ale to wciąż zapowiedź producenta, którą trzeba sprawdzić na własnym kodzie.
Co naprawdę dostaje deweloper od NVIDIA Agent Toolkit, gdy odłożyć marketing zaufania na bok
4 min
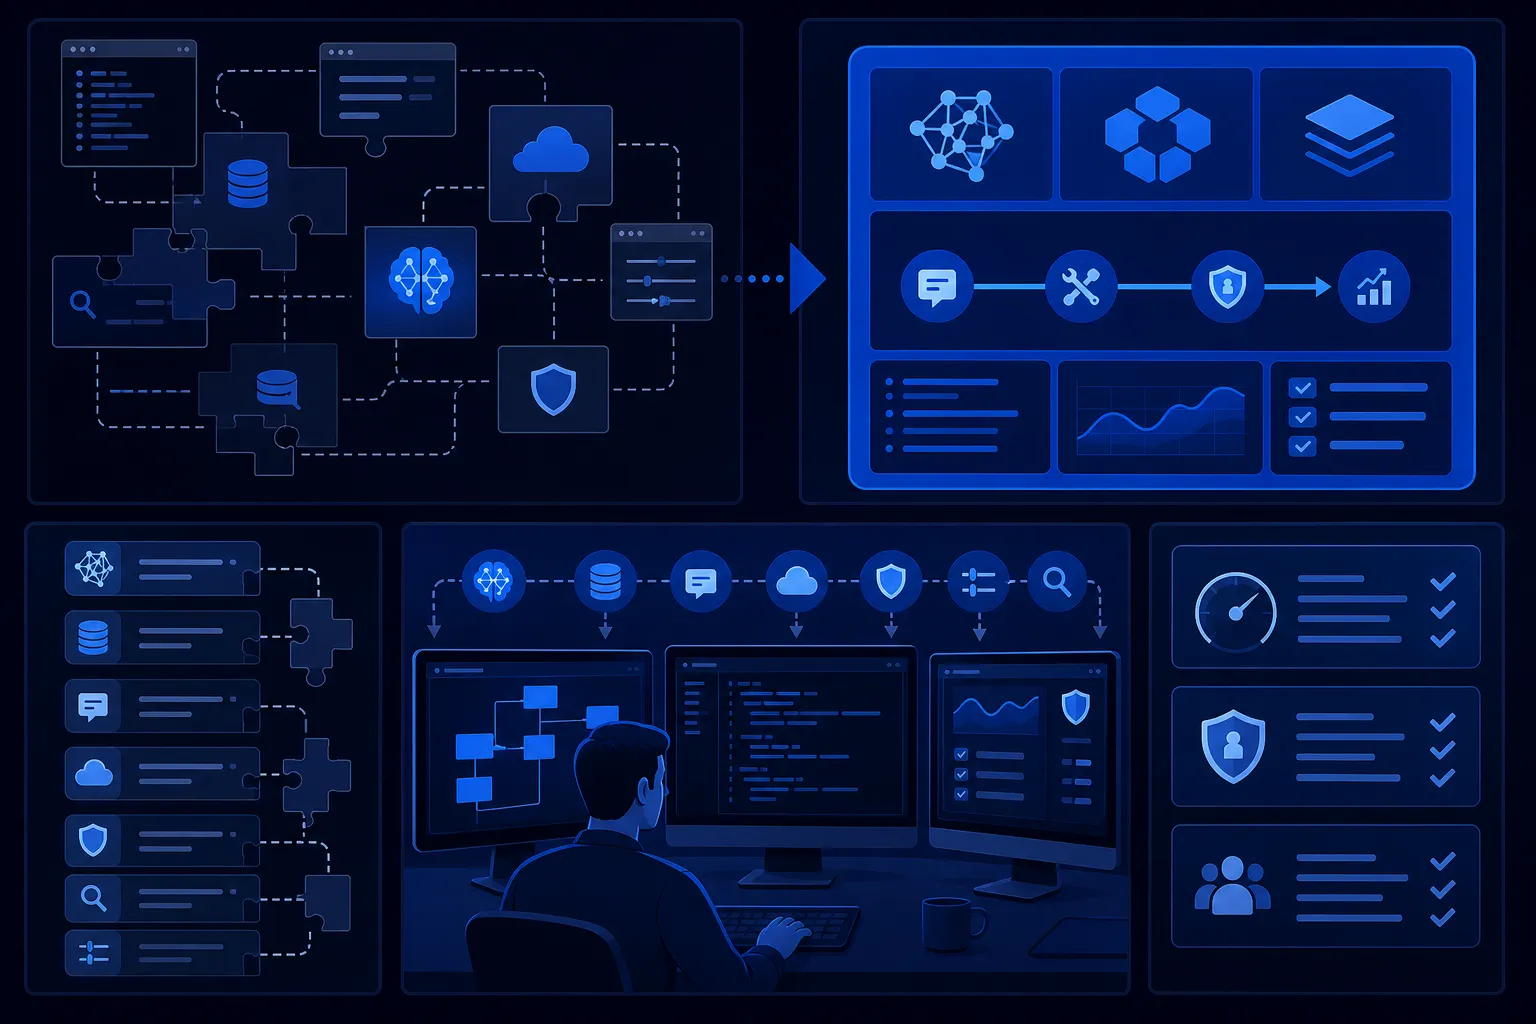
NVIDIA ogłosiła 23 czerwca Agent Toolkit, ale jedyną rzeczą, którą deweloper może dziś naprawdę dotknąć, jest instrukcja postawienia agenta badawczego AI-Q 2.0 na Oracle Cloud Infrastructure. Dostajesz trzy warstwy w jednym pudełku: modele Nemotron jako rozumowanie, gotowe reguły bezpieczeństwa i piaskownicę odcinającą kod agenta od reszty. Terraform stawia infrastrukturę, Helm wgrywa backend, interfejs i bazę, a całość rusza w jakieś pół godziny. Cena za wygodę to przywiązanie do chmury, modeli i klucza NVIDIA, a reszta komunikatów to na razie deklaracje producenta, nie zweryfikowane wyniki.
Jeden model, który dzwoni po inne. I nie mówi, do których
4 min
Tokijska Sakana AI wypuściła 22 czerwca 2026 Fugu, system wielu agentów udający jeden model: wysyłasz zapytanie pod jeden adres zgodny z API OpenAI, a orkiestrator sam rozdziela pracę między wyspecjalizowane modele i skleja odpowiedź. Sakana sprzedaje go jako poduszkę na ryzyko kontroli eksportu i chwali się wynikiem 73,7 na SWE-Bench Pro, o ponad cztery punkty wyżej niż Opus 4.8. Skłaniam się ku temu, że to zamiana jednej zależności na inną, gorzej widoczną: routing jest zamknięty, nie wiesz, który model odpowiedział ani ile to kosztuje.
Git wymyślono, żeby nikt nie kontrolował repozytorium. Origin to odwraca
5 min
Na konferencji Compile Cursor pokazał plan przejęcia całego stosu: nowy model trenowany od zera (1,5 biliona parametrów, ponad 100 tysięcy GPU), karmiony prawdziwymi sesjami pracy programistów, oraz Origin, własny hosting git zaprojektowany pod tysiące agentów piszących naraz, z automatycznym rozwiązywaniem konfliktów scalania. Po przejęciu przez SpaceX cały strumień danych z Cursora trafi do firmy, która sama trenuje modele, co odwraca rozproszoną kontrolę, dla której wymyślono git. Domknięcie planowane na trzeci kwartał 2026 to moment, by sprawdzić warunki użycia kodu do trenowania.
Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu
4 min
openloops, otwartoźródłowa wtyczka do Chrome'a z poradnika FreeCodeCampu autorstwa Shola Jegede, skanuje historię przeglądania i grupuje ją w wątki intencji, licząc podobieństwo domen i słów miarą Jaccarda. Cały rdzeń działa lokalnie w IndexedDB, bez jednego wywołania sieci, a Claude (model Haiku) tylko opcjonalnie dokłada tytuły i następne kroki. Pouczający jest moment, w którym pierwsza wersja po cichu się wywaliła: przy 30 wątkach odpowiedź uderzyła w limit max_tokens i urwała JSON. Lekcja brzmi tak, że model wpina się jako wycinalny dodatek, nie jako centrum produktu.
Apple daje wybór asystenta w Xcode. Pytanie, czy ktoś go realnie używa
3 min
Xcode 26.6, wydany 25 czerwca, dorzuca Google Gemini jako trzeciego asystenta kodowania obok Claude'a i Codeksa, choć w becie Xcode 27 opcja ta była już od 10 czerwca, więc premiera tylko przenosi ją do wersji stabilnej. Naprawdę istotny jest jednak Agent Client Protocol, czyli wspólny format, dzięki któremu do edytora można wpiąć dowolnego zgodnego agenta bez zgody Apple. Sam wybór trzech modeli bywa też kosztem, bo każdy myli się inaczej i trzeba poznać trzy maszyny zamiast jednej. To sygnał kierunku i nietypowy gest otwartości, a nie jeszcze zmiana na biurku programisty.
Agent robi 2,4 razy więcej, kiedy wie, czego chcesz
5 min
Anthropic prześwietlił około 400 tysięcy sesji Claude Code i odkrył, że na ten sam prompt agent wykonuje ekspertowi 2,4 raza więcej działań niż nowicjuszowi. O wyniku decyduje nie znajomość składni, tylko wiedza o dziedzinie: prawnik czy księgowy, który wie, jak ma wyglądać poprawny wynik, wypada równie dobrze co programista. Przewaga otwiera się najszerzej wtedy, gdy sesja się sypie, bo doświadczony użytkownik wychodzi z błędów, zamiast porzucić terminal. Sama firma przyznaje, że nie wie, czy ten kod trafia do użytku, a dane pomijają konkurencyjne narzędzia.
AI doradza poprawnie, ale nikt nie każe sprawdzić, czy łatka jeszcze działa
5 min
Kiedy asystent AI podpowiada, jak załatać podatną zależność wpisem typu override w package.json, rada jest poprawna, ale nikt nie każe wrócić i sprawdzić, czy to przypięcie wciąż cokolwiek robi. Sonu Kapoor, twórca CVE Lite CLI, przeskanował cztery znane projekty i w trzech znalazł martwe zabezpieczenia: Cal.com miał 90 wpisów, z czego 11 nie chroniło przed niczym, a tylko Next.js wyszedł czysto. Override cicho umiera najczęściej przy migracji między menedżerami paczek, bo npm, pnpm i Yarn trzymają go w innym polu, więc weryfikacja należy do ciebie, najlepiej jako stały krok przed wydaniem.
Amazon Q wykonywał kod ze sklonowanego repo, a nowa wersja MCP zrzuca bezpieczeństwo na ciebie
5 min
Wystarczyło sklonować repozytorium i otworzyć je w edytorze, by ktoś obcy przejął aktywną sesję chmurową dewelopera. Tak działała dziura CVE-2026-12957 w Amazon Q Developer: wtyczka odpalała serwery MCP opisane w pliku z repo bez pytania o zgodę, a procesy dziedziczyły klucze AWS i tokeny ofiary. Amazon załatał problem w wersji 1.69.0, ale ten sam wzorzec wcześniej trafił Claude Code, Cursora i Windsurfa. Zaplanowana na 28 lipca 2026 przebudowa MCP kasuje starą klasę ryzyk, lecz przenosi obowiązek pilnowania granic zaufania na piszącego serwer.
Co naprawdę decyduje o sukcesie z agentem kodującym, według danych Anthropic
6 min
Anthropic przejrzał około 400 tysięcy sesji Claude Code od mniej więcej 235 tysięcy osób i uznał, że o sukcesie decyduje nie znajomość składni, tylko rozumienie dziedziny: człowiek podejmuje około 70% decyzji, co zrobić, a agent około 80%, jak to napisać. Potwierdzony sukces skacze z 15% u nowicjuszy do 28–33% u reszty, ale prawie cały przyrost bierze się z przejścia na poziom średniozaawansowany. Warto czytać to ostrożnie, bo to badanie firmy o własnym produkcie, a "sukces" mierzy zapis rozmowy, nie to, czy kod trafił na produkcję.
Boris Cherny już nie pisze promptów. Pisze pętle
5 min
Boris Cherny, twórca Claude Code, mówi CNBC, że nie pisze już promptów, tylko rozmawia z agentem koordynującym całość, a Addy Osmani z Google Cloud nazwał to podejście loop engineering. Zamiast sterować agentem prompt po prompcie, składasz raz pętlę z pięciu klocków, automatów z harmonogramu, worktree, skilli, konektorów na MCP i podziału na piszącego kod oraz osobnego weryfikatora, plus pamięć poza rozmową, bo model zapomina między uruchomieniami. Osmani ostrzega, że to nie mniej myślenia, lecz więcej: weryfikacja zostaje na tobie, a rozumienie własnego kodu słabnie, jeśli na to pozwolisz.
Anthropic wypuścił Fable 5, a najmocniejszą wersję znów zatrzymał dla ośmiu firm
5 min
9 czerwca Anthropic udostępnił Claude Fable 5, swój najmocniejszy publicznie dostępny model, który wskoczył na pierwsze miejsce SWE-bench Pro z wynikiem 80,3%, o 11,1 punktu wyżej niż Opus 4.8, choć liczby pochodzą wyłącznie od producenta. Model kosztuje dwa razy tyle i sam decyduje, ile czasu poświęcić na myślenie, bez możliwości wyłączenia. Tego samego dnia pojawił się Mythos 5, ten sam zestaw wag bez filtra bezpieczeństwa, dostępny tylko dla wąskiej grupy klientów w Project Glasswing, podczas gdy wersja publiczna po cichu przełącza pytania o cyberbezpieczeństwo na słabszy Opus 4.8.
AgentDeck: jeden terminal do całej floty agentów i osobny agent, który ich pilnuje
4 min
AgentDeck to otwartoźródłowe narzędzie w Go, które zbiera całą flotę agentów kodujących w jednym terminalu: każda sesja dostaje kolorową kropkę stanu, fork dziedziczący rozmowę i własny worktree gita, a klawisz "$" pokazuje koszty czternastu modeli. Najciekawszy jest jednak dyrygent, osobny agent stale pilnujący reszty, który sam odpowiada na rutynowe pytania, a ważniejsze przerzuca na Telegram albo Slack. To kuszący wzorzec, ale projekt jednej osoby, a wiedza pochodzi z README, nie z produkcji, więc kluczowe pytanie, co dzieje się, gdy dyrygent się myli, pozostaje bez odpowiedzi.
Trzy dziury w LiteLLM: od zwykłego konta do shella na serwerze
7 min
Badacze z Obsidian Security pokazali w połowie czerwca, że w LiteLLM, pośredniku zbierającym klucze do OpenAI, Anthropica czy Gemini pod jednym interfejsem, da się z konta zwykłego użytkownika dojść do roli admina i uruchomienia własnego kodu na serwerze. Łańcuch trzech podatności dostał ocenę CVSS 9,9, a komplet poprawek jest dopiero w wydaniu v1.83.14-stable. Najgroźniejsze nie jest to, że atakujący odczyta wszystkie klucze i prompty, ale że siedząc między agentem a modelem potrafi przerabiać jego odpowiedzi w locie.
Datalab otwiera Lift: model 9B, który wyciąga JSON z PDF-ów lokalnie
4 min
Datalab udostępnił na open source Lift, wizyjny model o dziewięciu miliardach parametrów, który z PDF-a i podanego schematu zwraca gotowy obiekt JSON, działając lokalnie na jednej karcie graficznej. Dzięki dekodowaniu ograniczonemu schematem wynik nie potrafi wyłamać się z formatu, a na zestawie 225 dokumentów model trafia w 90,2 procent pól w 9,5 sekundy, bijąc Azure Content Understanding (83,4 procent, 73,7 sekundy). Haczyk to inna liczba: bezbłędnie domyka tylko 20,9 procent całych dokumentów, więc świetnie nadaje się do pracy z człowiekiem w pętli, ale nie do pełnej automatyzacji.