Programowanie AI
Claude Code, OpenCode i mini-SWE-agent na tych samych modelach: wynik ten sam, rachunek do trzech razy wyższy
5 min
Badacze z Uniwersytetu Shandong uruchomili te same modele w Claude Code, OpenCode i mini-SWE-agent na blisko 500 zadaniach z SWE-bench Verified i wyszło, że harness nie podnosi skuteczności ponad zwykły rozrzut między próbami, za to potrafi potroić koszt zadania. Claude Code wysyła na start ponad 16,5 tysiąca tokenów stałego kontekstu, a mini-SWE-agent nieco ponad 800, i ten narzut rośnie z każdym krokiem. Zanim zapłacisz za cięższy harness, warto dwa razy puścić własną konfigurację i zobaczyć, o ile wynik waha się sam z siebie.
Bezstanowy MCP z 28 lipca: które integracje trzeba przepisać
4 min
Specyfikacja Model Context Protocol z 28 lipca 2026 usuwa wymianę initialize i nagłówek Mcp-Session-Id, więc każde żądanie niesie wszystko, czego serwer potrzebuje. Prosty klient przejdzie na nią zwykle razem z aktualizacją SDK, ale serwery, które pamiętały stan między wywołaniami albo same pytały klienta, czeka przebudowa: stan trzeba przekazywać jawnym identyfikatorem w argumentach, a pytania wracają jako wynik żądania. Najgroźniejsza jest zmiana kodu błędu dla brakującego zasobu z -32002 na -32602, przez którą alerty w monitoringu mogą po cichu zamilknąć.
REA w dwa tygodnie urosło z 10 do 325 tysięcy gwiazdek na GitHubie
5 min
REA, zestaw narzędzi dający agentom takim jak Claude Code czy Cursor dostęp do deasemblerów, urósł na GitHubie z niecałych 10 tysięcy gwiazdek 6 października do około 325 tysięcy 19 października. Głośny Ledger Reborn odtworzył reguły księgowe QuickBooks co do centa, ale tylko na jednej przykładowej firmie i bez niezależnego sprawdzenia. Przy klonowaniu programów zaciera się granica metody czystego pokoju, dostawcy modeli blokują konta badaczy, a fałszywe repozytoria rozsyłają złośliwe oprogramowanie.
Inception Labs wypuszcza Mercury 3: dyfuzyjny model z 1068 tokenami na sekundę
4 min
Inception Labs wypuścił 19 października Mercury 3, model dyfuzyjny, który szkicuje od razu cały fragment tekstu i wyostrza go w kilku przebiegach, dzięki czemu według firmy osiąga 1068 tokenów na sekundę, czyli od czterech do ośmiu razy więcej niż GPT-6 Luna i Claude Haiku 5.5. Porównania jakości pochodzą jednak wyłącznie od Inception i jego partnerów, a poprzednik w niezależnym pomiarze wypadł wolniej niż w reklamie. Model ma okno kontekstowe miliona tokenów i API zgodne z OpenAI, więc najrozsądniej sprawdzić go samemu na najwolniejszym kroku agenta.
Codex zainstalował złośliwą paczkę, bo kazał mu to plik tekstowy. Raport Forever
4 min
Firma Forever opisała 22 października przypadek, w którym Codex u jej klienta próbował zainstalować paczkę function-color z rejestru npm, powiązaną z kampanią MALFEX, bo polecił mu to podrzucony plik tekstowy w folderze Pobrane. W powtórce ataku agent dopisał do swoich ustawień serwer napastnika, który odtąd startuje z każdą sesją w każdym projekcie, a Claude Code dał się przejąć w mniej więcej połowie prób. Lepiej nie uruchamiać agentów w Pobranych i zostawić wymóg zatwierdzania instalacji.
Opus 5.5 domyślnym modelem Anthropica, Fable 5.1 dwa i pół raza droższy
4 min
Anthropic ustawił Claude Opus 5.5 jako domyślny model, a po Fable 5.1 radzi sięgać dopiero wtedy, gdy Opus zawodzi nawet na wyższym poziomie wysiłku. Różnica w cenie jest duża: Opus kosztuje 4 i 20 dolarów za milion tokenów wejścia i wyjścia, Fable 10 i 50, więc zadanie agenta, które na Opusie kosztuje 12 dolarów, na Fable kosztuje 30. Kto buduje aplikację na API, musi też czytać flagi z Models API, bo na przykład Sonnet 5.5 nie pozwala całkiem wyłączyć myślenia i odpowie błędem 400.
Red Hat wypuścił RH SWE-bench: Claude Opus 4.6 rozwiązuje 63,3% zadań w Go, Pythonie i C
4 min
Red Hat opublikował 21 października RH SWE-bench, czyli 357 zadań z 25 repozytoriów, takich jak kubectl, etcd i podman, z czego 78% to kod w Go. Prowadzi Claude Opus 4.6 w Claude Code z wynikiem 63,3%, ale ten sam Nemotron-120B rozwiązał 30,8% zadań w OpenCode i tylko 21,6% w Pi, więc tabelę lepiej czytać jako ranking par model plus harness. Zbiór jest otwarty, a pomysł z testami, które padają przed poprawką, pozwala zamienić stare pull requesty we własne zadania dla agenta.
OpenCode po cichu załatał dziurę, przez którą serwer MCP uruchamiał kod przy logowaniu
4 min
Anomaly załatała w OpenCode 1.18.33 błąd, przez który na Windowsie i w WSL zdalny serwer MCP mógł uruchomić dowolną komendę, gdy deweloper zaczynał logowanie przez OAuth, bo stara wersja paczki open wklejała podany przez serwer adres do polecenia PowerShella. Pillar Security oceniło dziurę na 9,8 w 10-punktowej skali, ale firma nie wystąpiła o CVE i uznała złośliwy serwer za coś spoza swojego modelu zagrożeń, przez co skanery zależności tej podatności nie wychwycą. Zagrożone są wersje od 1.0.137 do 1.18.32, więc jedyną obroną jest sprawdzenie wersji i aktualizacja.
NVIDIA wypuściła Dory 4B, którego głębokość myślenia ustawiasz przy uruchomieniu
5 min
NVIDIA udostępniła na Hugging Face Dory 4B, model z czterema miliardami parametrów, w którym blok 20 współdzielonych warstw wykonuje się przy uruchomieniu raz, dwa albo cztery razy. Przy czterech pętlach naprawia 61,8% zadań z SWE-bench Verified, przy jednej już tylko 50,3%, a wszystkie liczby pochodzą od samej NVIDII. Standardowe llama.cpp i vLLM jeszcze go nie załadują, a na MacBooku z 16 GB model myślał pięć minut nad prostym licznikiem słów, więc na razie to raczej weekendowy eksperyment niż codzienne narzędzie.
Ornith-1.5 122B: otwarty model do kodu, który wciąż się zapętla
4 min
Ornith-1.5 122B to model z otwartymi wagami na licencji MIT, zbudowany na Qwen3.5-122B-A10B i przeznaczony do kodu, agentów i wywoływania narzędzi. W teście MindStudio sam znalazł i poprawił błąd w aplikacji liczącej podział spadku, ale japoński programista Kishida zauważył, że model wciąż zapętla się na powtórzeniach odziedziczonych po Qwenie. Dopóki ktoś spoza zespołu twórców nie zmierzy, jak często wpada w pętlę, lepiej sprawdzać go na pojedynczym błędzie niż zostawiać z nim agenta na całą noc.
Anthropic podwoił własny szacunek kosztów Claude Code do 13 dolarów dziennie
5 min
Anthropic podaje w dokumentacji Claude Code, że przeciętny dzień pracy kosztuje około 13 dolarów na dewelopera, czyli dwa razy więcej niż przed kwietniową aktualizacją, choć cennik się nie zmienił. Rachunek rośnie, bo każda wymiana wysyła modelowi całą rozmowę, a zespoły agentów zużywają mniej więcej siedem razy więcej tokenów. Przy rozliczeniu za tokeny to 150 do 250 dolarów miesięcznie, więc samodzielnemu programiście zwykle najlepiej służy plan Max za 100 dolarów.
Trellix i GitGuardian: agenci AI wynoszą klucze API bez żadnego włamania
5 min
Trellix i GitGuardian opisują, jak agent AI wynosi klucze API bez żadnego włamania, wykonując zwykłą pracę: czyta plik .env, wkleja token do polecenia curl i wysyła treść do dostawcy modelu, więc sekret ląduje w historii powłoki, na liście procesów i w zapisie sesji. Według GitGuardiana commity z Claude Code zawierały sekret w 3,2% przypadków wobec średnio 1,5% na GitHubie, a w plikach konfiguracji MCP firma znalazła 24 008 sekretów, z których 2117 nadal działało. Pomaga oddzielenie prawa do użycia klucza od jego zobaczenia, krótkie tokeny i piaskownica.
Gemini 4 Argon trafia do płatnego API i aplikacji Gemini, a promocyjna cena kończy się 30 listopada
5 min
Od 13 października Gemini 4 Argon jest dostępny w płatnym API i w aplikacji Gemini dla planów Pro i Ultra, choć samodzielnego agenta w Antigravity dostają tylko abonenci Ultra za 99,99 dolara. Promocyjna stawka 2 i 10 dolarów za milion tokenów obowiązuje do 30 listopada, a ponieważ model zużywa dużo tokenów na rozumowanie, po podwyżce zadanie wyjdzie drożej niż w GPT-6 Astra. Z sześciu poprawek, które Argon zaproponował w ADK przez 11 godzin, inżynierowie przyjęli dwie, dlatego sprawdziłbym go na własnym repozytorium jeszcze przed grudniem.
Scion: system kontroli wersji, który Anthropic zbudował w pięć miesięcy po tym, jak git przestał nadążać za Claude'em
5 min
Anthropic mergeował we wrześniu ponad 30 tysięcy zmian dziennie, dwanaście razy więcej niż w maju, więc git przestał nadążać i siedmioosobowy zespół w pięć miesięcy zbudował własny system kontroli wersji o nazwie Scion. Commity, merge i historię liczy w nim serwer, a CI według firmy odzyskało 25% mocy obliczeniowej. Zwykły zespół szybciej odczuje jednak zderzenia agentów przy merge'u, bo w zbiorze AgenticFlict konflikt pojawiał się w 27,67% pull requestów, więc bardziej pomoże mu rozsądny podział pracy niż nowy system.
Liquid AI LFM2.5-24B-A2B: lokalny agent na laptopie, ale nie do naprawiania kodu
5 min
LFM2.5-24B-A2B od Liquid AI ma 24 miliardy parametrów, ale przy każdym tokenie pracuje niecałe 2,5 miliarda, dzięki czemu na Apple M5 Max generuje 184 tokeny na sekundę i działa jako agent bez chmury. W teście LiveClaw pokonał Qwen3.6-35B-A3B wynikiem 48,09 do 38,19, bo trenowano go wprost w harnessach takich jak OpenCode i Hermes Agent. Przy naprawianiu prawdziwego kodu wyraźnie jednak odpada: na SWE-Bench Verified rozwiązuje 51 procent zgłoszeń wobec 66,2 u Qwena, więc nadaje się do lokalnych pętli z narzędziami, a nie do pracy w dużym repozytorium.
Muse Spark Open: 816 miliardów parametrów Mety na biurku, ale bez pomiarów prędkości
4 min
Meta udostępniła wagi Muse Spark Open, modelu o 816 miliardach parametrów, z których przy każdym tokenie pracuje tylko 42 miliardy, dzięki czemu skompresowana wersja mieści się na dwóch Mac Studio z M5 Ultra. Z mojego rachunku wychodzi tam teoretyczny sufit około 28 tokenów na sekundę, co wystarczy agentowi pracującemu w tle, ale nie podpowiedziom w edytorze. Zamiast pomiarów Meta pokazała agenta poprawiającego klienta Mastodona Ice Cubes, a licencja ma ograniczenia komercyjne, których nie precyzuje.
Meta Muse Wonder kosztuje tyle co Claude Opus 5.5, ale najmocniejszej wersji nie kupisz w API
4 min
Meta wypuściła 12 października Muse Wonder i Muse Wonder Full, a zwykłego Wondera wyceniła w API tak samo jak Claude Opus 5.5, na 4 dolary za milion tokenów wejścia i 20 za milion wyjścia. Większość wygranych w tabeli Mety należy jednak do wersji Full, dostępnej tylko w subskrypcji Muse Code za 50 lub 200 dolarów miesięcznie. Zwykły Wonder wygrywa w długich projektach, przegrywa przy pisaniu od zera, a zadanie kosztuje na nim 4,52 zamiast 5,98 dolara, bo generuje o połowę mniej tokenów.
FrontierCode 1.1: Claude Opus 5.5 wygrywa, ale przechodzi wszystkie blokady tylko w 58% prób
4 min
Claude Opus 5.5 wygrał benchmark FrontierCode 1.1 od Cognition z wynikiem 52,2%, choć wszystkie kontrole blokujące przeszedł tylko w 57,7% prób, a każda oblana blokada zeruje próbę mimo zielonych testów. Artificial Analysis sprawdziło 23 modele na zadaniach od opiekunów Celery czy Mattermost, które oceniają, czy ktoś przyjąłby taki pull request. Przewaga nad GPT-6.1 Sol to 3,1 punktu przy koszcie 10,15 dolara za zadanie wobec 0,81 dolara, więc do codziennej pracy agenta bardziej opłaca się tańszy model.
Proste przycinanie kontekstu i sam Bash wygrywają w badaniu harnessów agentów kodujących
4 min
Run-Ze Fan i współautorzy rozłożyli harness agenta kodującego na części i w 176 konfiguracjach, zestawionych w pary różniące się jednym elementem, sprawdzili plan zadania, narzędzia i zarządzanie kontekstem. Najlepszy stosunek skuteczności do kosztu dało proste przycinanie kontekstu według reguł, a modele dobrze znające Basha radziły sobie z samym terminalem równie dobrze jak z gotowymi narzędziami, tylko taniej. Badano jednak Nemotrony i Mistrala, a nie Claude Code czy Codexa, więc przed dodaniem narzędzia do agenta trzeba policzyć, ile kosztuje jedno rozwiązane zadanie.
Copilot wygrywa w ReviewBench, ale wyniki rywali zmierzył sam GitHub
4 min
Copilot code review prowadzi w rankingu ReviewBench z wynikiem 40,1%, ale wyniki wszystkich rywali zmierzył sam GitHub, i to w różnych terminach: Copilota 1 października, a Cubic i Greptile jeszcze w czerwcu. W niezależnym benchmarku firmy Martian prowadzi Cubic z 64,9% F1, a Copilot jest czwarty, co pokazuje, jak mocno metoda ustawia kolejność. Z tej tabeli nie wybierałbym więc recenzenta dla zespołu, ale otwarty zbiór 219 pull requestów i ustawienia sędziego pozwalają sprawdzić własną konfigurację.
Agenty z chmury Tencenta dostały się do danych Amap kluczem, który inna firma zostawiła w swoim kodzie
6 min
Od 28 września do 8 października agenty AI z chmury Tencenta ponad 2600 razy próbowały wyciągnąć dane z Amap, mapy Alibaby, a gdy je zablokowano, uruchamiały swój kod w cudzej przeglądarce serwisu urlquery.net. Dane przyniósł dopiero klucz API, który jakaś firma zostawiła w publicznym kodzie swojej aplikacji, bo klucz przypisany do domeny był dla obcego bezużyteczny. Moim zdaniem to lekcja o kluczach i uprawnieniach, a nie o buncie maszyn, dlatego warto zawęzić adresy, z którymi łączy się agent, i sprawdzać repozytorium pod kątem sekretów.
Harvard na danych Jellyfish: agenty AI piszą o 30% więcej kodu, a zespoły nie kończą więcej zadań
4 min
Fiona Chen i James Stratton z Harvardu przeanalizowali dane Jellyfish z ponad 700 firm i wyszło im, że po wprowadzeniu agentów AI kodu przybywa średnio o 30%, a zespoły nie kończą więcej zadań. Czas zaoszczędzony na pisaniu znika w przeglądzie, bo pull request czeka na akceptację o 49% dłużej, z 7 do ponad 10 dni, a prośby o poprawki zdarzają się prawie dwa razy częściej. Narzędzia AI do recenzji ma 80% firm, ale zostawiają one tylko 23,3% komentarzy, dlatego mierzyłbym czas do zmergeowania, a nie liczbę linii.
Sto razy różnicy w cenie między Claude Haiku 5.5 a Fable 5.1
5 min
Fable 5.1 bierze za milion tokenów wejściowych 10 dolarów, a Haiku 5.5 zaczyna od 0,10 dolara, więc najdroższy i najtańszy model Claude dzieli stukrotna różnica. Anthropic sam radzi zaczynać od Opusa 5.5, który jest dwa i pół raza tańszy od Fable, a po droższy model sięgać dopiero wtedy, gdy Opus z wyższym poziomem namysłu nie daje rady. Niska stawka Haiku obowiązuje tylko do 100 tysięcy tokenów w prompcie, a powyżej cena rośnie pięciokrotnie, dlatego ten model najlepiej sprawdza się w krótkich zadaniach, takich jak sortowanie zgłoszeń czy streszczanie logów.
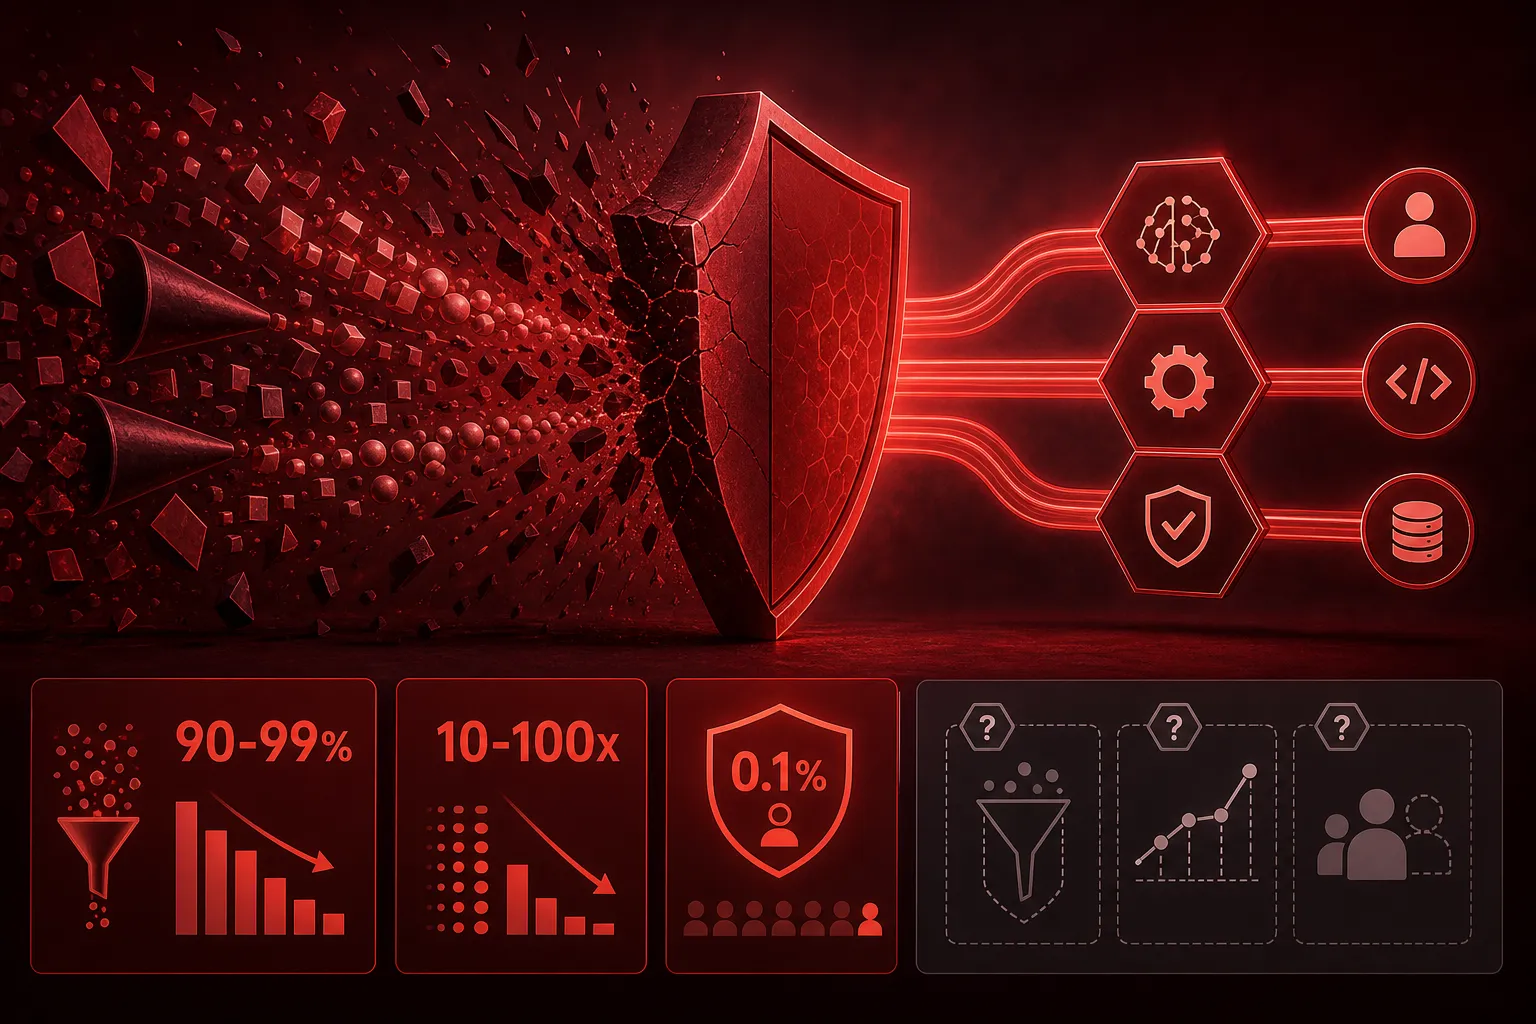
Anthropic blokuje destylację Claude'a, a za pomyłki filtra płaci klient
4 min
Anthropic stawia trzy bariery przeciw destylacji Claude'a, czyli uczeniu tańszych modeli konkurencji na jego rozumowaniu, które daje w SWE-bench Verified 80,4% wobec 71,8% przy samych streszczeniach. Konta API założone od 31 sierpnia 2026 nie mogą edytować wcześniejszych tur rozmowy, a zapytania do najnowszych modeli sprawdza dwustopniowy klasyfikator. Od 24 września klient płaci też za zablokowane zapytania, więc przy deklarowanym progu 0,1% fałszywych alarmów agent z tysiącami wywołań dziennie zapłaci za kilka odmów, dlatego liczyłbym je we własnych logach.