Poradnik / Praktyka
Tydzień 28 · 6–12 lipca 2026
 Poradnik / Praktyka
AWS pokazuje, ile naprawdę waży "produkcyjny" serwer MCP
4 min
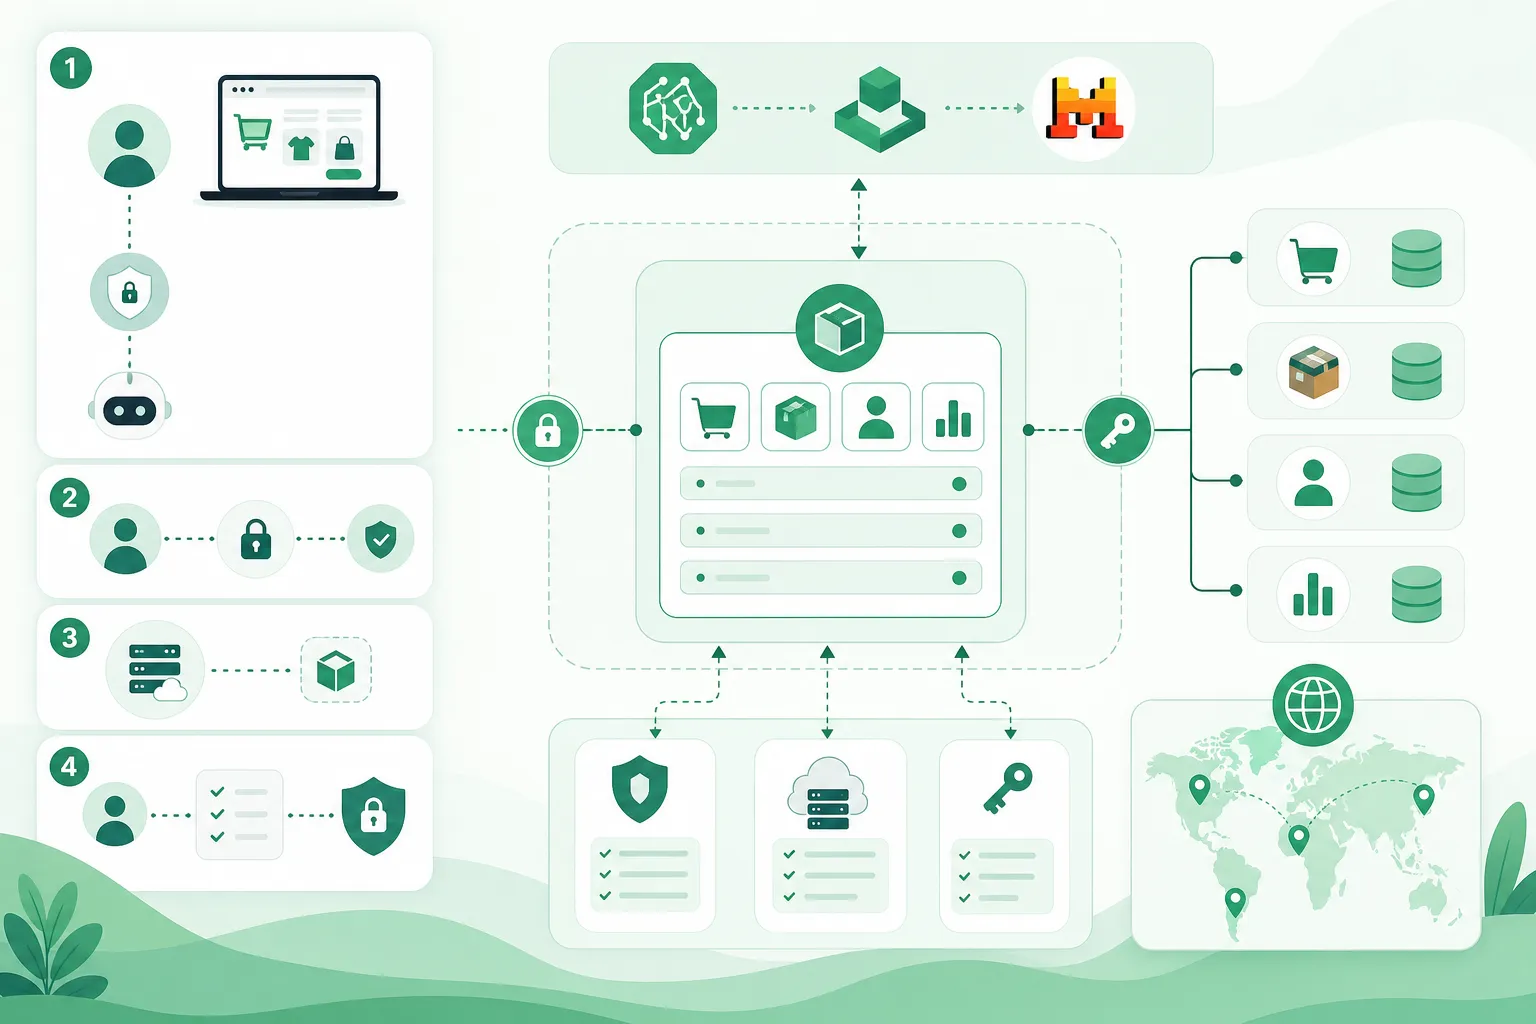
Opublikowany 30 czerwca przewodnik AWS buduje serwer MCP dla przykładowego sklepu i podłącza go do klienta Mistrala, ale prawdziwą treścią jest architektura bezpieczeństwa. Uwierzytelnianie rozkłada się na dwie warstwy: AgentCore Runtime sprawdza kryptograficznie token JWT z Cognito, zanim kod ruszy, a aplikacja zamienia go na tożsamość klienta i sięga w DynamoDB tylko po jego dane. Słowo "produkcyjny" waży tu tyle, że skrótu nie ma — dostajesz cztery pakiety infrastruktury w CDK, nie gotowy produkt, a najwięcej wynosi się z reguł: najmniejsze uprawnienia i limit ośmiu funkcji na serwer.
 Poradnik / Praktyka
Anthropic każe wyciąć z promptów to, co kiedyś wymuszało dokładność
4 min
Anthropic odświeżył firmowy przewodnik po promptowaniu i większość pracy przy przenoszeniu starych promptów polega teraz na wycinaniu, nie dopisywaniu. Kategoryczne "KRYTYCZNE: MUSISZ" i pisanie wielkimi literami w najnowszych modelach, od Fable 5 po Opus 4.8, zaczynają szkodzić, bo model bierze je zbyt dosłownie. Prefill na końcu rozmowy i parametr budget_tokens zwracają już twardy błąd 400 na Opus 4.7 i nowszych, więc głębokością namysłu steruje się teraz parametrem effort. Przy długich zadaniach rada jest prosta: stan trzymaj poza kontekstem, na dysku, w plikach i w gicie.
Tydzień 27 · 29 czerwca – 5 lipca 2026
 Poradnik / Praktyka
Darmowy przewodnik po budowie agentów, od modelu po wdrożenie na produkcji
3 min
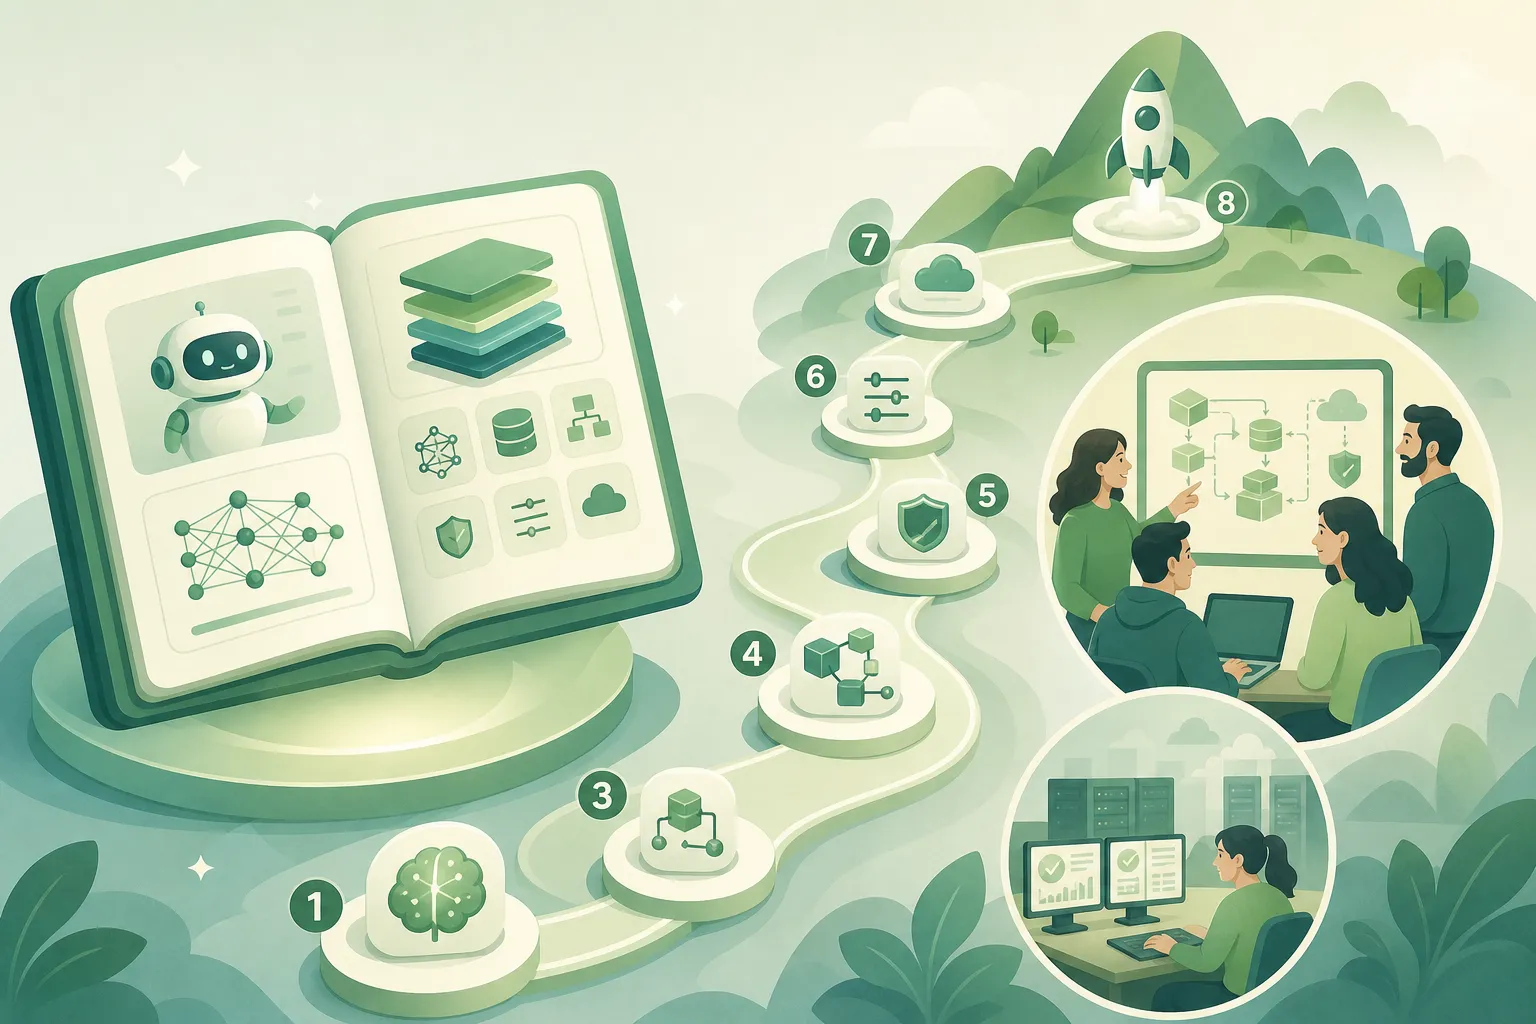
Haggai Roitman wrzucił 22 czerwca na arXiv „The Hitchhiker's Guide to Agentic AI", darmową książkę na licencji CC BY-SA 4.0, która opisuje budowę agentów AI w całości: od architektury transformera i RLHF, przez pamięć, harness, MCP i RAG, aż po wdrożenie na produkcji. Jeden autor bierze na klatę cały ten zakres, więc ryzyko jest jedno: że któryś rozdział okaże się płytkim przeglądem zamiast przewodnika, po którym da się coś zbudować. Na razie znam sam abstrakt, ale i tak bym zajrzał, bo nawet jeśli gdzieś zabraknie głębi, sama mapa układająca te kawałki w całość ma wartość.
 Poradnik / Praktyka
Testy przeszły, panel zielony, a system podaje stare ceny
3 min
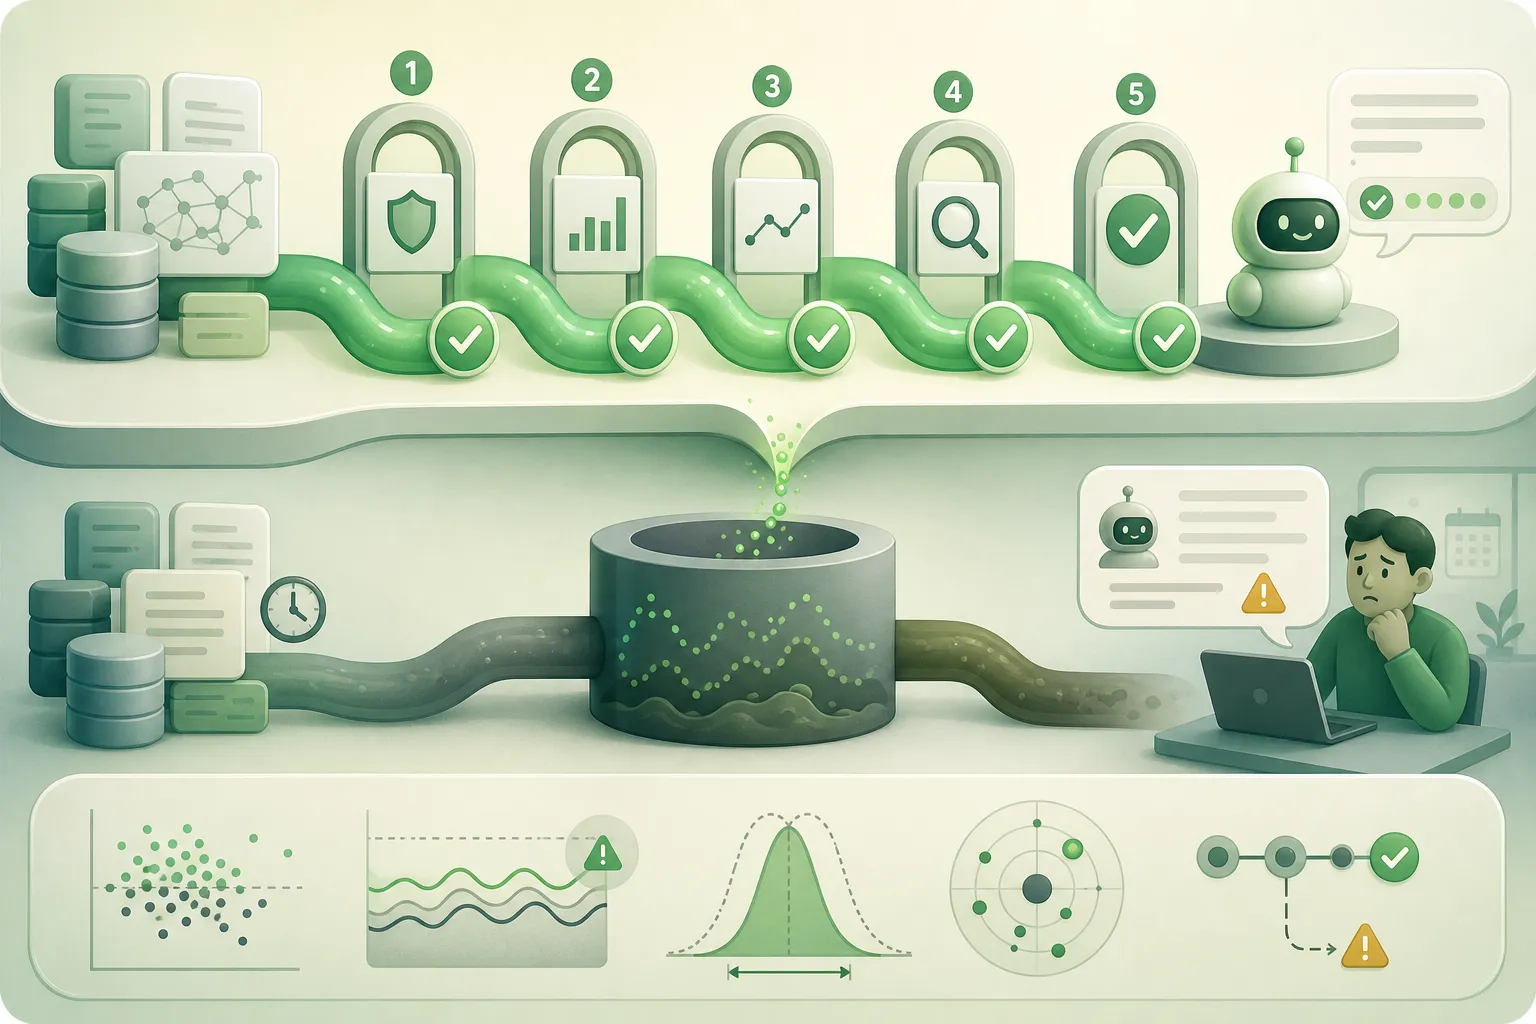
Freddy Daniel Alvarez Pinto opisał w The New Stack, dlaczego klasyczne CI/CD zawodzi przy systemach LLM: jego system RAG przeszedł wszystkie testy i świecił na zielono, a przez weekend model zamieniający teksty na wektory rozjechał się tak, że w poniedziałek podawał klientom stare ceny. Zamiast pytać tylko "czy test przeszedł", proponuje cztery bramki wydania, z których najważniejsza porównuje trafność z ruchomą średnią z ostatnich wydań i pewnego czwartku wychwyciła 6-procentowy spadek, zanim dotarłby do 200 użytkowników. To praktyka jednego inżyniera, nie branżowy standard.
 Poradnik / Praktyka
Duolingo wygenerowało 85 tysięcy linii testów w 17 tygodni. Recenzja stała się wąskim gardłem.
4 min
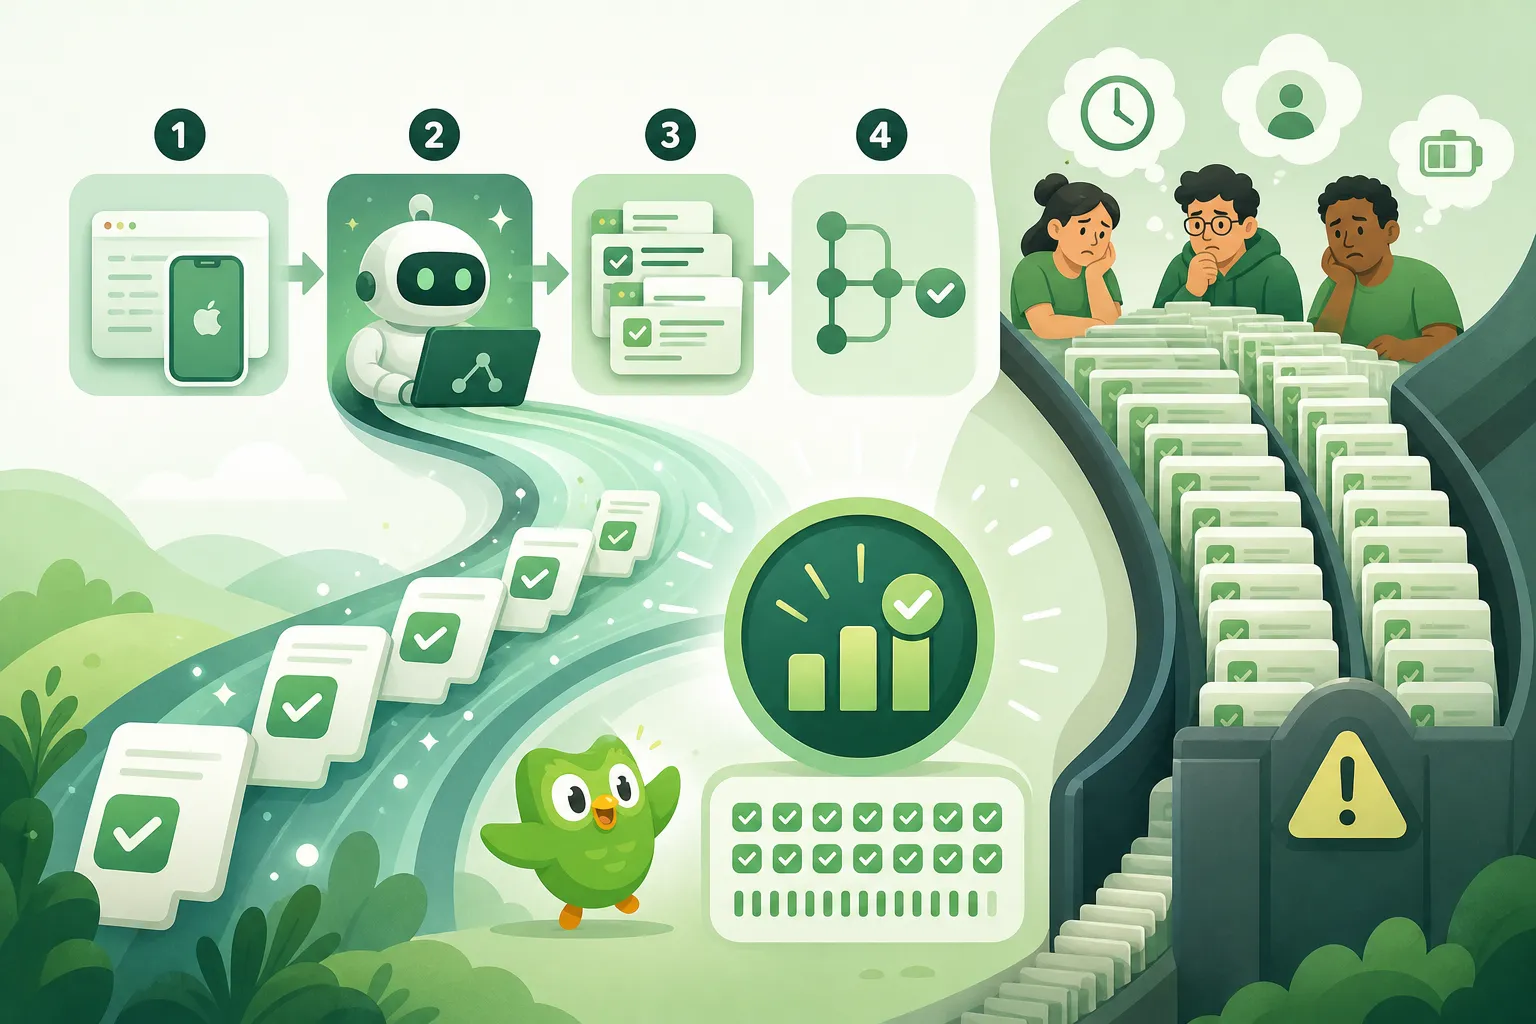
Duolingo zbudowało proces, w którym zdalne sesje Claude Code same piszą testy jednostkowe do aplikacji na iOS: w 17 tygodni zmergowały 250 PR-ów, dołożyły około 85 tysięcy linii kodu testowego i podniosły pokrycie głównych komponentów z 9 do 30 procent. Agent pisze jednak w ciemno, bo serwery chodzą pod Linuksem, a kod kompiluje się tylko na Macu, więc 13,6% zgłoszeń poległo na CI. Sami autorzy przyznają, że generowanie testów stało się łatwą częścią, a prawdziwym wąskim gardłem jest recenzja, którą wciąż musi wykonać żywy inżynier.
Tydzień 26 · 22–28 czerwca 2026
 Poradnik / Praktyka
Karpathy proponuje wiki, którą pisze i utrzymuje model, nie ty
5 min
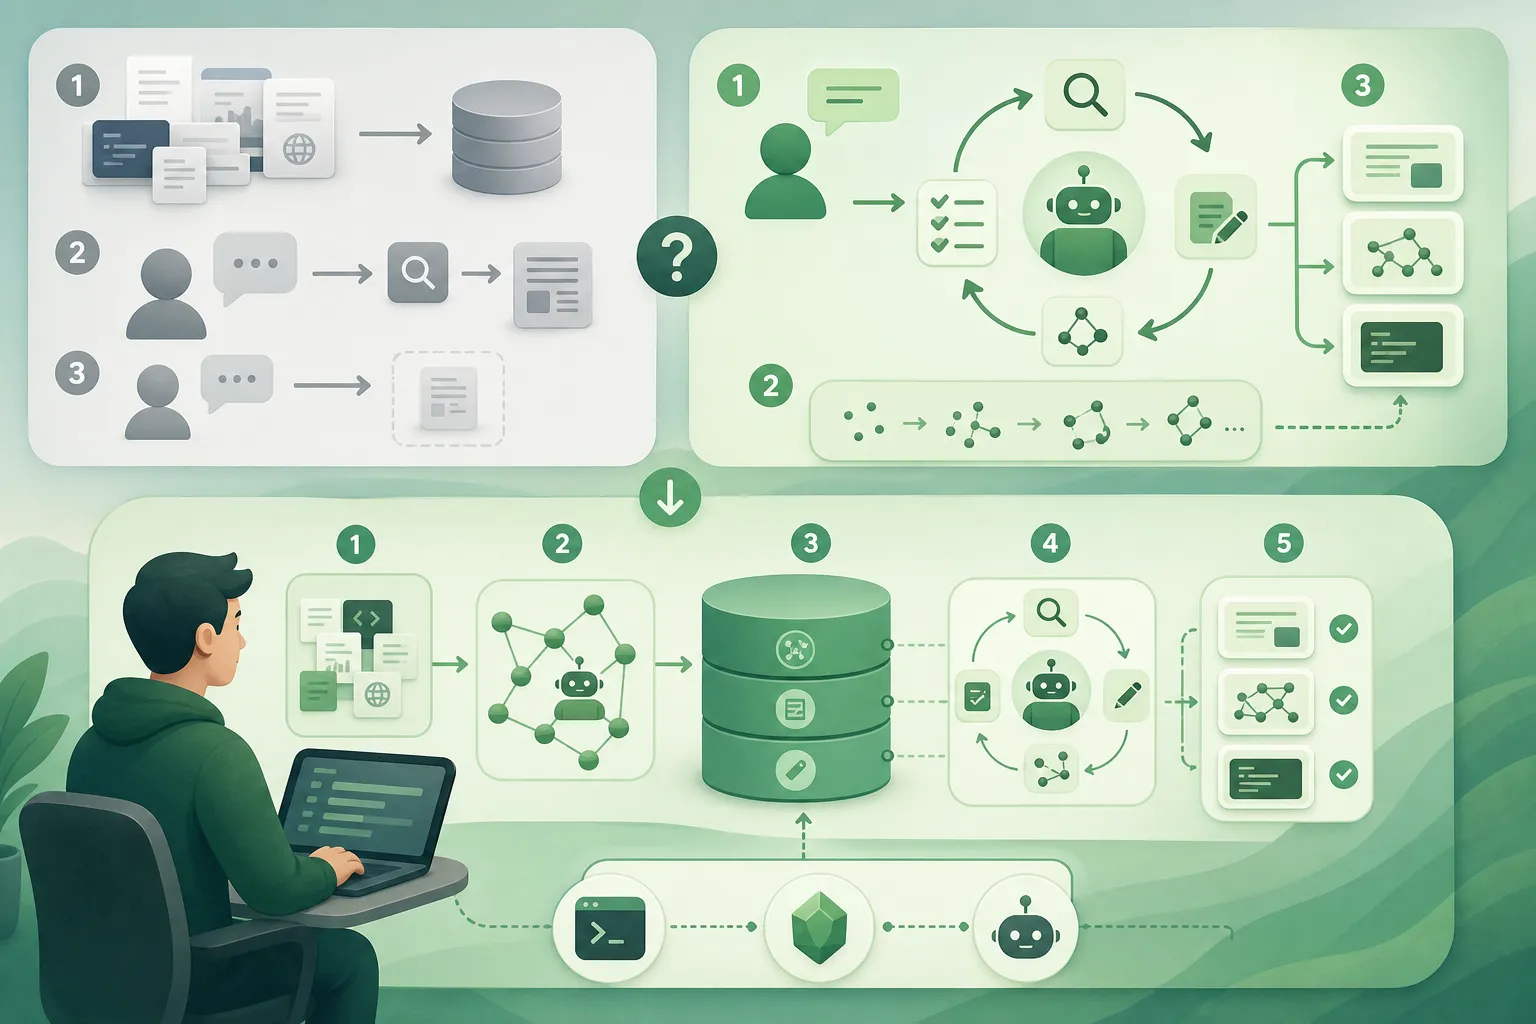
Andrej Karpathy opisał w zwykłym giście na GitHubie wzorzec "LLM Wiki" jako alternatywę dla RAG: zamiast przeszukiwać surowe dokumenty przy każdym pytaniu, model buduje i sam utrzymuje trwały katalog połączonych plików markdown, kompilując wiedzę raz i tylko aktualizując strony oraz odnotowując sprzeczności. Kluczowy jest schemat w stylu CLAUDE.md, który mówi modelowi, co robić z nowym źródłem. Gist zebrał ponad pięć tysięcy gwiazdek nie dzięki nowej technologii, lecz dlatego, że nazwał coś, co wielu po cichu sklejało, i odpowiada na stare pytanie: kto zniesie nudę utrzymania wiki.
 Poradnik / Praktyka
Prompty, które kiedyś wymuszały dokładność, dziś psują wynik
4 min
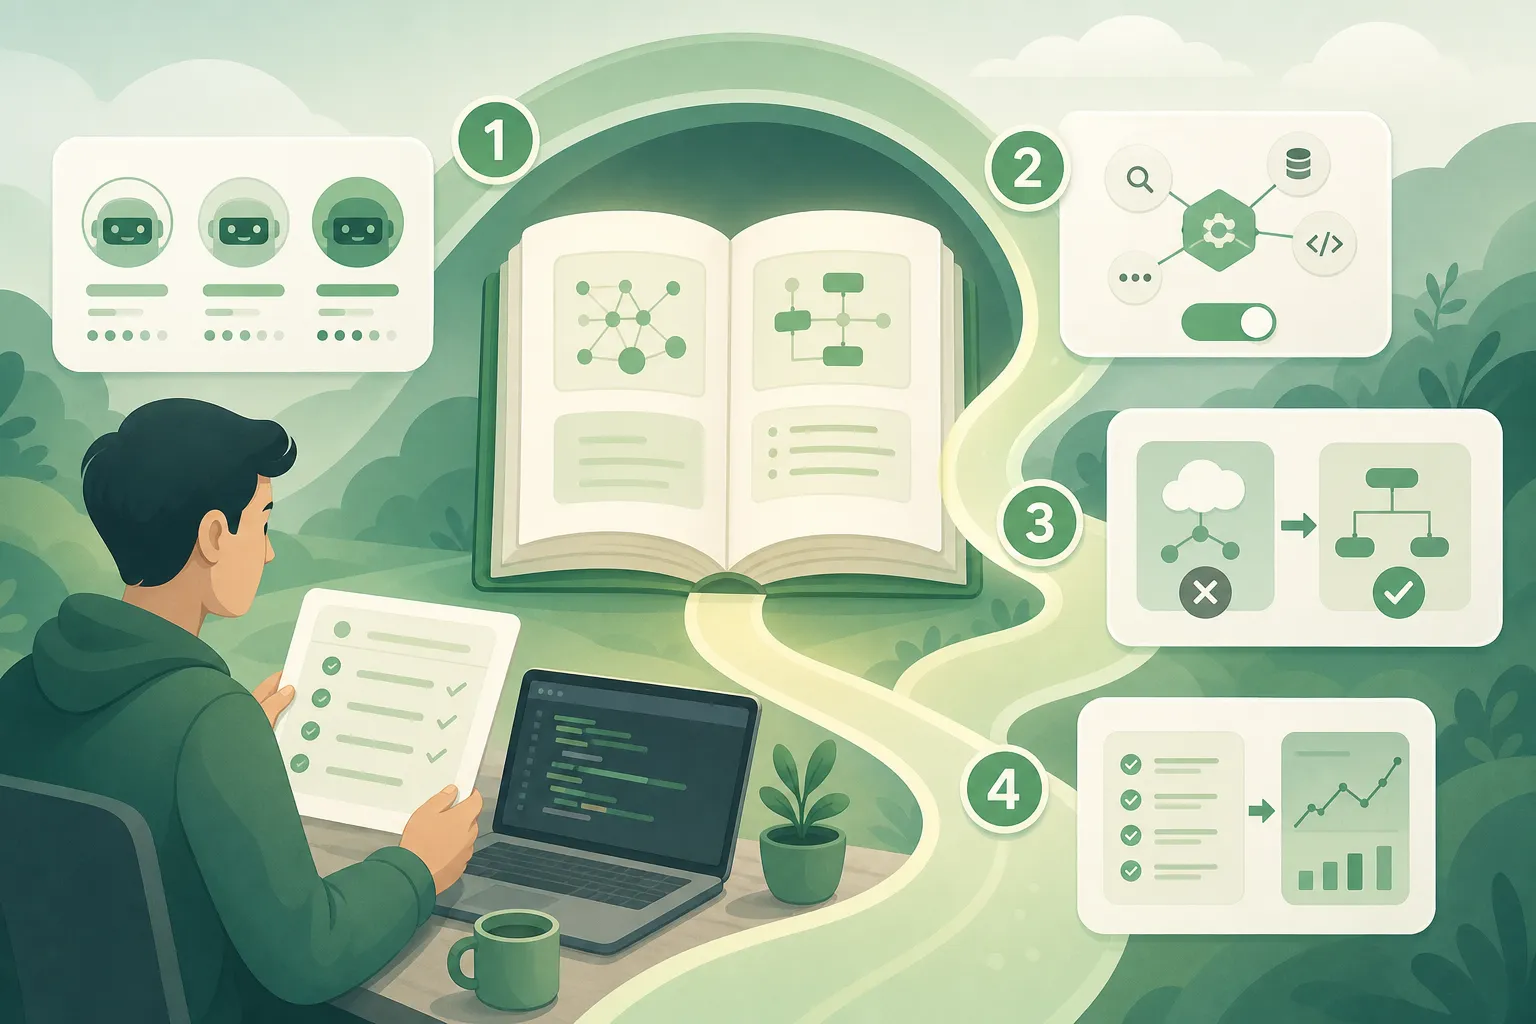
Anthropic zebrał wskazówki promptowania dla swojej rodziny modeli z 2026 roku w jednym przewodniku, a jego sednem jest lista rzeczy do odkręcenia w starych promptach po przejściu na nowszy model. Stanowcze instrukcje typu "KRYTYCZNE: MUSISZ użyć narzędzia" teraz przesadzają, więc trzeba zdjąć wykrzykniki i zamienić ogólne nakazy na celowane. Twardo znikają dwie rzeczy: prefill (od modeli 4.6 zwraca błąd 400) i budget_tokens, którego rolę przejmuje effort i adaptacyjne myślenie, gdzie model sam decyduje, jak głęboko się zastanowić.
 Poradnik / Praktyka
Model nigdy nie widział twojego kodu, więc zgaduje, do czego jest podobny
8 min
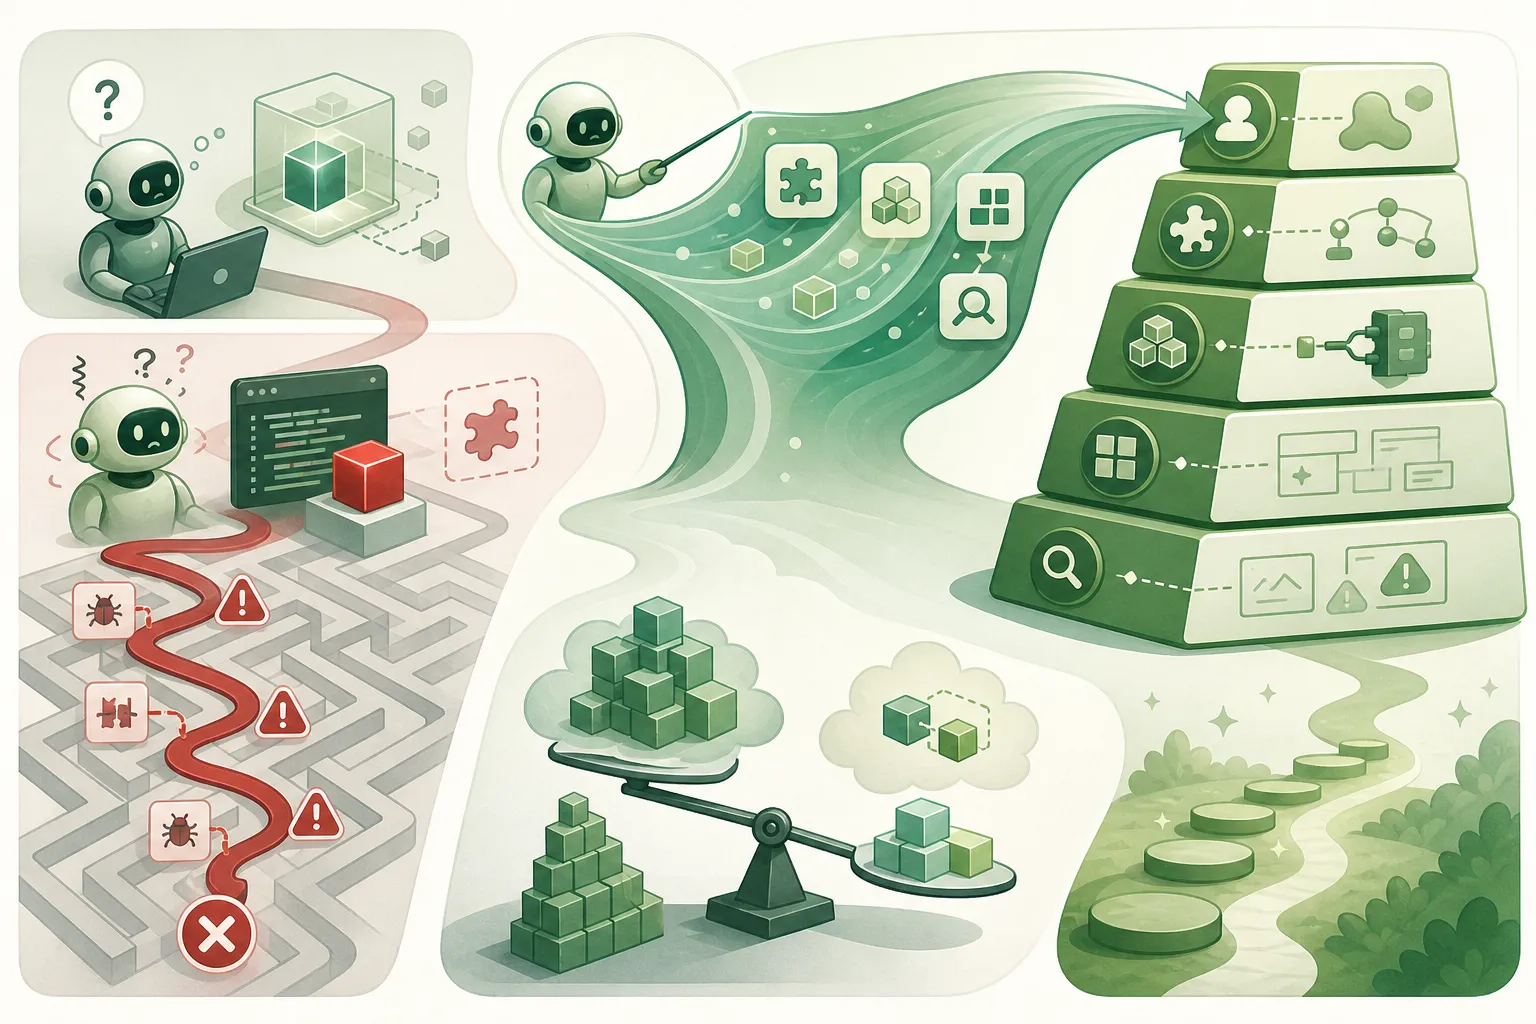
Gdy agent AI pracuje z twoim wewnętrznym SDK, którego model nigdy nie widział w treningu, nie przyzna się do niewiedzy, tylko przepisze twoją technologię na najbliższy znany wzorzec, jak AWS, OAuth czy REST, i wygeneruje kod, który wygląda wiarygodnie, a jest błędny. Waldek Mastykarz z Microsoftu nazywa to pułapką najbliższego dopasowania i radzi uczyć model od podstaw w pięciu warstwach, pokazując tylko różnicę wobec standardów, które już zna. Koszt jest realny: zamiast około 500 tokenów na znany framework potrzeba nawet 3000.
 Poradnik / Praktyka
Jak zbudować narzędzie linii poleceń, którego konsumentem jest AI
4 min
Justin Poehnelt, autor otwartego CLI do Google Workspace, twierdzi, że jeśli głównym użytkownikiem narzędzia linii poleceń ma być agent AI, to projektowanie pod wygodę człowieka gra przeciwko tobie. Zamiast kilkunastu płaskich flag agent dostaje cały ładunek żądania przez `--json`, a dokumentację zastępuje komenda zwracająca aktualny schemat metody. Kluczowa obserwacja: agent nie halucynuje literówek, lecz sklejone identyfikatory i podwójnie zakodowane ścieżki, więc CLI musi walidować wejście tak jak publiczne API. To jeden głos i jedno wdrożenie, ale poparte działającym kodem.
 Poradnik / Praktyka
Stare praktyki, wyższa stawka: czego LY Corporation nauczyło się, puszczając agenty na kod
5 min
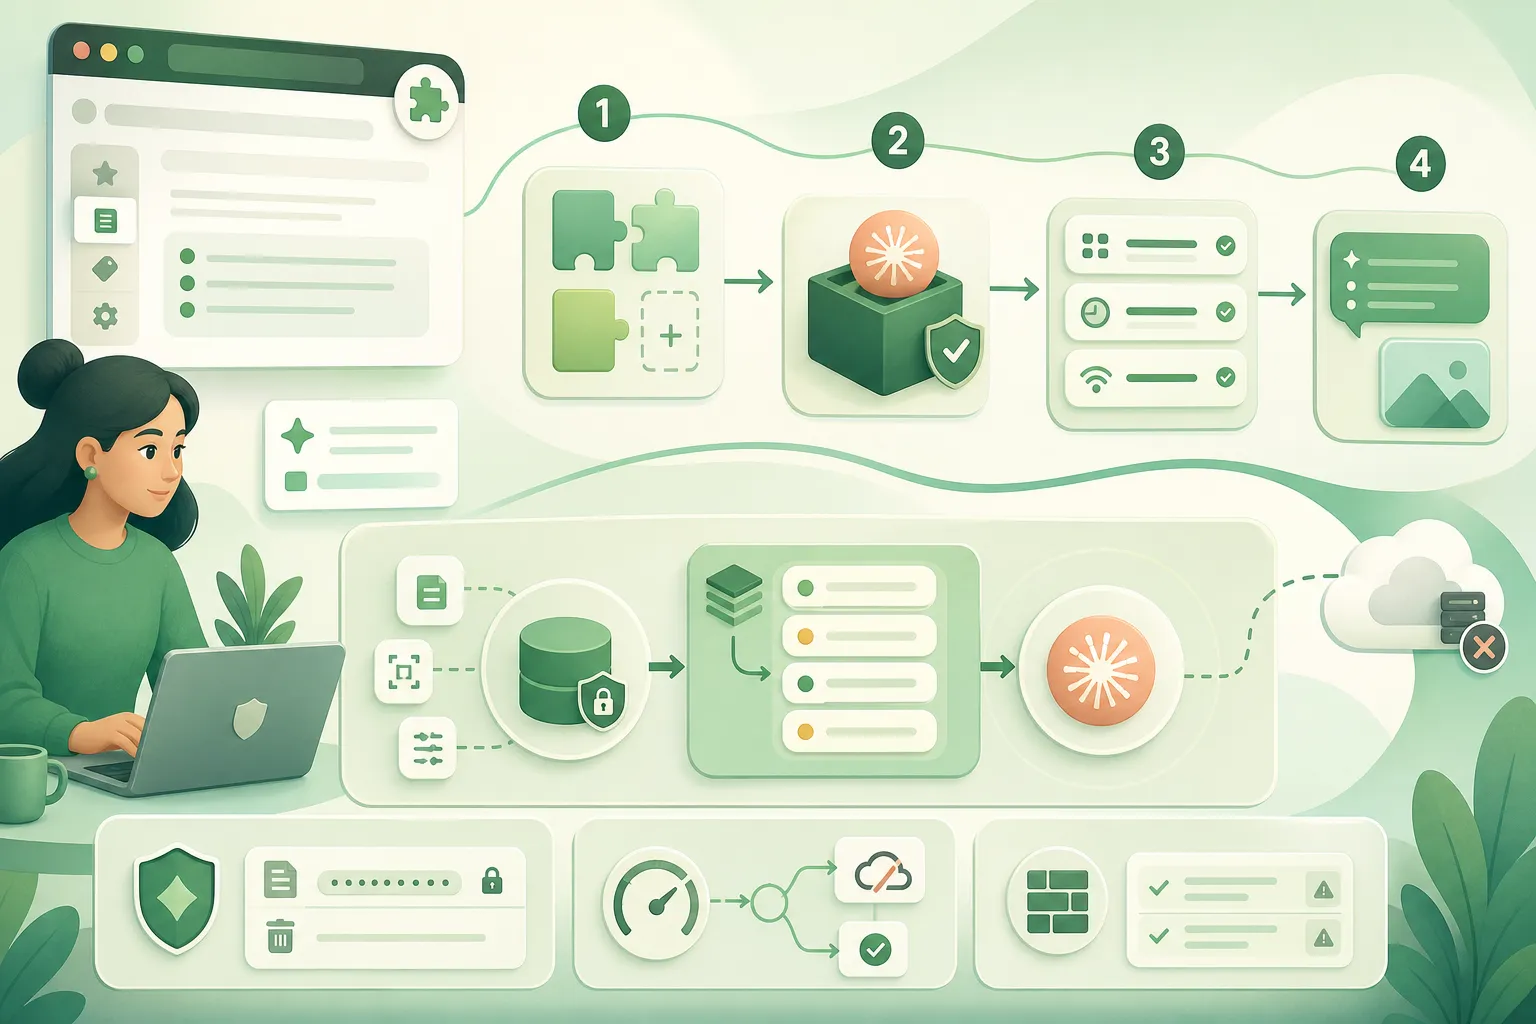
Inżynierowie z LY Corporation, twórcy Flava API Gateway, opisali, że agenty kodujące nie psują starych zasad dobrego programowania, tylko je obnażają: to, co człowiek nadrabiał uwagą, agentowi trzeba podać wprost, jako automatyczne kontrole. Ich trzy filary to spisanie specyfikacji przed kodem, szybka weryfikacja przez testy i lintery (2754 testów w jakieś 15 sekund dzięki izolacji schematów) oraz powtarzalne środowisko na Devenv i Nix. Dyscyplina, którą dawniej można było po cichu wyciąć pod presją terminu, przy agencie przestaje być opcją.
 Poradnik / Praktyka
Wtyczka, która układa twoją historię w wątki, a model dokłada etykiety na końcu
4 min
openloops, otwartoźródłowa wtyczka do Chrome'a z poradnika FreeCodeCampu autorstwa Shola Jegede, skanuje historię przeglądania i grupuje ją w wątki intencji, licząc podobieństwo domen i słów miarą Jaccarda. Cały rdzeń działa lokalnie w IndexedDB, bez jednego wywołania sieci, a Claude (model Haiku) tylko opcjonalnie dokłada tytuły i następne kroki. Pouczający jest moment, w którym pierwsza wersja po cichu się wywaliła: przy 30 wątkach odpowiedź uderzyła w limit max_tokens i urwała JSON. Lekcja brzmi tak, że model wpina się jako wycinalny dodatek, nie jako centrum produktu.
Tydzień 25 · 15–21 czerwca 2026
 Poradnik / Praktyka
Boris Cherny już nie pisze promptów. Pisze pętle
5 min
Boris Cherny, twórca Claude Code, mówi CNBC, że nie pisze już promptów, tylko rozmawia z agentem koordynującym całość, a Addy Osmani z Google Cloud nazwał to podejście loop engineering. Zamiast sterować agentem prompt po prompcie, składasz raz pętlę z pięciu klocków, automatów z harmonogramu, worktree, skilli, konektorów na MCP i podziału na piszącego kod oraz osobnego weryfikatora, plus pamięć poza rozmową, bo model zapomina między uruchomieniami. Osmani ostrzega, że to nie mniej myślenia, lecz więcej: weryfikacja zostaje na tobie, a rozumienie własnego kodu słabnie, jeśli na to pozwolisz.
 Poradnik / Praktyka
Najtrudniejsze w pracy z agentem jest wiedzieć, kiedy kazać mu przestać
5 min
Menedżer produktu Zephyr w Espressif opisuje, jak po raz drugi zbudował to samo firmware z pomocą agenta, tym razem w C zamiast Rust, i wyciąga z tego jeden wniosek: skoro model pisze kod szybciej, niż człowiek nadąża go ocenić, praca nie znika, tylko przenosi się z pisania na ocenianie. Jego receptą jest rytm plan, wykonanie, commit, test, z commitem przed testowaniem, żeby zawsze był punkt powrotu. Reszta reguł pilnuje granic: kodu z upstreamu agent nie rusza bez pozwolenia, a dziennik prób chroni przed zapętlaniem nieudanych poprawek.
 Poradnik / Praktyka
Sto procent poprawnego JSON-a, zero zgodności ze schematem
5 min
Prototyp Microsoftu zamieniający dziennik zmiany operatora przemysłowego na ustrukturyzowany JSON zdał test poprawności składniowej w 100%, a test zgodności ze schematem oblał na zero, bo model po cichu gubił całe wymagane sekcje. Zamiast poprawiać prompt, zespół przeszedł pole po polu i odkrył, że ponad połowa wartości już jest na wejściu, więc powinien je przepisać kod, nie model. Po rozdzieleniu pól deterministycznych od wymagających interpretacji zgodność wzrosła z zera do 47%, a metoda dociągnęła ją do 100% i utrzymała się nawet po podmianie modelu bazowego.
 Poradnik / Praktyka
Sędzia z paskiem błędu: instrukcja budowy harnessu do oceny LLM
6 min
Niedeterministyczny system AI trzeba mierzyć przyrządem z paskiem błędu, a nie testować na zasadzie zielone-czerwone światełko. Harness opisany na dev.to przepuszcza szablon przez tanie bramki, zanim włączy drogiego sędziego, ocenia w skali 1-5 i próbkuje trzy razy nawet w temperaturze 0, bo ten sam wymiar dał raz 4,00, a raz 2,67. Kluczem jest podział ról: tani Amazon Nova 2 Lite pilnuje struktury i poprawnego JSON-a, DeepSeek V3.2 pisze treść jakieś siedem razy taniej niż Sonnet, a sędzia z innej rodziny ocenia tylko sens.
Tydzień 17 · 20–26 kwietnia 2026
 Poradnik / Praktyka
Czy trzy LLM-y naprawdę wygrały Kaggle? Tylko w trybie Playground.
3 min
GPT-5.4 Pro, Gemini 3.1 Pro i Claude Opus 4.6 wygrały zawody Kaggle o przewidywanie odpływu klientów telekomu — 150 modeli wybranych z 850 eksperymentów, złożonych w stos. NVIDIA opisuje to jako triumf trójki agentów na jej GPU z cuDF i cuML, ale przemilcza dwie rzeczy: że "Playground" to seria edukacyjna bez medali i nagród, oraz że za sterami siedzi Grandmaster decydujący, którą hipotezę puścić dalej. Przepis jest realny dla problemów tabelarycznych, lecz bez człowieka u steru 850 iteracji zamienia się w losowe obroty.
 Poradnik / Praktyka
Mój edytor sam pisze konfigurację serwera MCP po jednej komendzie
3 min
Jedna komenda `npx sanity@latest mcp configure` wykrywa Claude Code i Cursora, wpisuje konfigurację do obu plików i bierze token z zalogowanej sesji CLI. Ashok Varma Matta zmierzył, że pytanie „jak działa LlmRouter" bez MCP otwiera 143 pliki i pali 362 000 tokenów, a po podpięciu serwera kosztuje 700 — 513 razy mniej. Architektura protokołu, który Anthropic otworzył w listopadzie 2024, nie zmieniła się od 18 miesięcy; zmieniło się to, ile zachodu kosztuje wpięcie. Brakuje jeszcze sklepu z serwerami i modelu uprawnień.
Tydzień 16 · 13–19 kwietnia 2026
 Poradnik / Praktyka
Cztery zasady Karpathy'ego w jednym pliku CLAUDE.md, 33 tysiące gwiazdek na GitHubie
3 min
Forrest Chang zamknął cztery obserwacje Andreja Karpathy'ego o słabościach LLM-ów w jednym pliku CLAUDE.md i w niespełna dwa miesiące zebrał 33,2 tysiąca gwiazdek na GitHubie. Reguły "myśl przed kodowaniem", "prostota najpierw", "chirurgiczne zmiany" i "sterowanie celem" odpowiadają na konkretne grzechy modeli: ciche wybieranie interpretacji, puchnięcie abstrakcjami i refaktoryzowanie tego, o co nikt nie prosił. Żaden benchmark tego nie potwierdza, ale koszt jest zerowy, a markdown powoli staje się standardową warstwą programowania agentów.
 Poradnik / Praktyka
Gemma 4 26B sprawdza się w lokalnych agentach. Google trzyma najszybszą wersję dla siebie.
4 min
Gemma 4 26B-A4B aktywuje tylko 3,8 miliarda parametrów na token, więc generuje z prędkością modelu 4B, a na AIME 2026 wyciąga 88,3%, punkt poniżej dużo cięższego 31B dense. Sześć specjalnych tokenów do narzędzi wbitych prosto w architekturę robi z niej pierwszy otwarty model, z którym lokalny agent realnie wie, kiedy zawołać funkcję. Tyle że głowice Multi-Token Prediction, dające niemal dwukrotne przyspieszenie, Google zostawił sobie w LiteRT. Wagi na Hugging Face są na Apache 2.0, ale najszybsza wersja zostaje w prywatnym stosie.
 Poradnik / Praktyka
Trzeci raz odrzucasz tę samą uwagę i agent przestaje ją powtarzać
3 min
Jerin Mathew Vinu zbudował agenta do code review, który zapamiętuje, które uwagi zespół akceptuje, a które odrzuca — po trzech kliknięciach Reject komentarz znika z czwartego PR-a. Pamięć trzyma Hindsight, recenzje generuje qwen3-32b przez Groq, a całość spina FastAPI. Kluczowa obserwacja: decyzje lądują w bazie jako jedno zdanie po angielsku, bo i tak wracają prosto do promptu — format zapisu warto dopasować do formatu odczytu. To weekendowy projekt bez pomiarów, ale wzorzec jest na tyle prosty, że można go sprawdzić u siebie.