Programowanie AI
Zdjęcie z iPhone'a otworzyło drogę do wewnętrznego repozytorium OpenAI
5 min
Trzech badaczy z Hacktronu wrzuciło na forum pomocy OpenAI spreparowane zdjęcie HEIC i w niecałe 72 godziny dotarło od błędu w nieaktualnej bibliotece libheif do pull requesta w wewnętrznym repozytorium openai/openai. Żaden z trzech zamków nie puścił przez lukę w modelu, tylko przez wspólne logowanie rozciągnięte z forum na narzędzia wewnętrzne i konto AI podpięte do firmowego GitHuba. Claude Opus 5 skrócił jedynie najdroższy etap, czyli napisanie działającego kodu ataku, dzięki czemu dwa miesiące polowania zamknęły się kwotą poniżej 3000 dolarów, a zgłoszenie przyniosło 6500 dolarów.
WorkOS chce, żeby agent zakładał konto za ciebie, bez formularza
4 min
WorkOS wypuścił auth.md, otwarty protokół, w którym aplikacja kładzie u siebie zwykły plik Markdown i opisuje w nim, na jakich zasadach przyjmuje rejestracje od agentów, podobnie jak robots.txt opisuje indeksowanie. Do wyboru są dwie ścieżki: dostawca tożsamości podpisuje zaświadczenie, że za agentem stoi konkretny człowiek, albo użytkownik zatwierdza kod we własnej przeglądarce, jak przy parowaniu telewizora. Obie kończą się tokenem OAuth przypisanym do człowieka, więc w audycie zostaje ślad zamiast wspólnego konta technicznego. Na liście wdrożeń nie ma jednak na razie ani jednej aplikacji.
Po co budować własną pętlę agenta, skoro OpenAI poprowadzi ją za ciebie?
4 min
OpenAI wyjęło z Codexa całą warstwę, która prowadzi agenta, i 10 września wystawiło ją jako Agents API w publicznej becie: podajesz zadanie, model i narzędzia, a pętlę prowadzi już ktoś inny. Sam harness nic nie kosztuje, płacisz za tokeny i czas kontenera, a ten najgrubszy, z 64 GB pamięci, wychodzi 5,76 dolara za godzinę pracy agenta. Jest jeden warunek: dane zostają w Stanach Zjednoczonych nawet wtedy, gdy kod wykonujesz u siebie, bo stan sesji i tak leży po stronie OpenAI. Czytam to jako wynajem, nie fundament, tym bardziej że kod harnessu Codexa leży otwarty na GitHubie.
Model przepisuje 90% migracji i dostaje za to zero punktów
4 min
Google przebudował Android Bench od podstaw: zamiast drobnych poprawek mierzy zadania, nad którymi inżynier siedzi kilka dni, a wynik podaje jako ciągły wskaźnik ukończenia. Czołówka, która na poprzedniej wersji meldowała ponad 90%, zjechała do 28% dla prowadzącego GPT-6 Astra, czyli tą samą drogą co wcześniej przy SWE-Bench Pro. Przepisywanie z Javy na Kotlina modele robią gładko, ale przeniesienia aplikacji wieloplatformowej na natywnego Androida nie domknął żaden. Oceniany jest przy tym model razem z harnessem, więc różnica między wierszami tabeli nie musi być różnicą między modelami.
Jedenaście plików GGUF i ani jednego pomiaru
4 min
Empero wrzucił na Hugging Face destylat Qwen3.8-35B-A3B w wersjach od 12,6 GB po pełne 71 GB, a zalecany czterobitowy plik waży 21,7 GB i mieści się na karcie z 24 GB pamięci albo w 32 GB RAM-u. Przy każdym tokenie pracuje tylko około 3 miliardów z 35 miliardów wag, dzięki czemu odpowiedzi lecą szybciej, niż sugeruje rozmiar, ale cały plik i tak musi wejść do pamięci, bo router sięga w każdej chwili po dowolny z 256 fragmentów. Karta nie podaje ani jednego pomiaru, więc dopóki nie przepuści tego ktoś przez niezależny benchmark, destylacja pozostaje zapowiedzią wydawcy, a nie faktem.
Drugie okno terminala, w którym widać pracę agenta linia po linii
3 min
Odpalasz livediff w drugim oknie terminala i od tej chwili widzisz każdy zapis pliku na bieżąco, jako zwykły diff Gita, zamiast zsumowanego stanu, który pokazuje watch git diff. Liczy się kolejność: wyłapujesz moment, w którym agent poprawia funkcję, po 20 sekundach cofa własną poprawkę i pisze ją trzeci raz zupełnie inaczej. Narzędzie śledzi wyłącznie pliki znane Gitowi, więc build ani dociągane zależności nie zasypują okna tysiącem linii. Nie wie za to, kto zmianę wprowadził, i nie pokaże niczego sprzed uruchomienia.
Sprzątanie miliona linii kodu za 19 300 dolarów. Regresje wyłapali ludzie.
4 min
Nous Research puściło 1393 wykonawców swojego agenta Hermes na milion linii Pythona i w 19 godzin, za jakieś 19 300 dolarów w tokenach, skróciło kod o 34,4%. Kontrole oparto na tym, co maszyna porówna sama: niezmieniony schemat JSON narzędzi, wynik polecenia z flagą help bajt w bajt i zamrożoną listę testów, które sypały się już wcześniej. Dwóch regresji to nie złapało, bo agenty wycięły publiczne nazwy potrzebne wtyczkom i w około 65 miejscach zmieniły obsługę błędów, a wyłapały je dopiero dwie rundy przeglądu przez społeczność open-source.
OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich
4 min
Od 14 października GPT-5.5 przestaje odpowiadać w ChatGPT i w Codexie na wszystkich planach, ale wywołania przez API OpenAI działają dalej, więc zacznij od sprawdzenia, którędy twoje zadania wołają model. Podmiana na gpt-5.6-sol zajmuje chwilę, gorzej z miejscami, których nikt nie ogląda: zadaniem wrzuconym kiedyś do harmonogramu albo krokiem w CI z flagą --model gpt-5.5, bo takie wywołanie nie przełączy się po cichu, tylko wróci błędem. Sol jest o jedną trzecią tańszy na tokenach wyjściowych od modelu, który znika, tyle że ta promocyjna stawka obowiązuje tylko do 21 listopada.
Agent przeszedł pilotaż. Co zrobi, gdy w połowie biegu wygaśnie klucz dostępu?
4 min
Diagrid wydał 17 września pięć kryteriów gotowości produkcyjnej dla agentów: wznawianie od miejsca awarii, dostęp, który nie wygasa w połowie biegu, idempotentność, kontrola tego, co oddaje model, i trwały zapis przebiegu. Każde jest pytaniem, na które odpowiada się logami, a nie akapitem w dokumencie projektowym. To klasyczne wzorce systemów rozproszonych, z jedną różnicą: ponowiony krok agenta może wybrać inne narzędzie i inny plan, więc nie jest tą samą operacją. Tyle że Diagrid sprzedaje dokładnie tę warstwę uruchomieniową, a kryteria wyszły komunikatem prasowym bez jednej liczby.
Agent-Reach nie czyta za ciebie internetu, tylko pilnuje, którędy da się do niego wejść
4 min
Agent-Reach, projekt jednego dewelopera, przez dobę wisiał na szczycie trendów GitHuba, choć sam nie pobiera ani jednej strony: trzyma uporządkowaną listę dróg dostępu do każdej platformy, z wariantami zapasowymi. Gdy w czerwcu Bilibili zaczęło odpowiadać kodem 412 na zapytania yt-dlp, wystarczyło przestawić kanał na bili-cli. Sześć kanałów działa bez konfiguracji, ale Reddit i X wymagają oddania skryptowi ciasteczka z zalogowanej sesji, więc autor radzi używać konta pomocniczego. Kupujesz tu czyjąś uwagę, bo gdy autor przestanie testować, lista dalej poda martwe drogi jako pierwszy wybór.
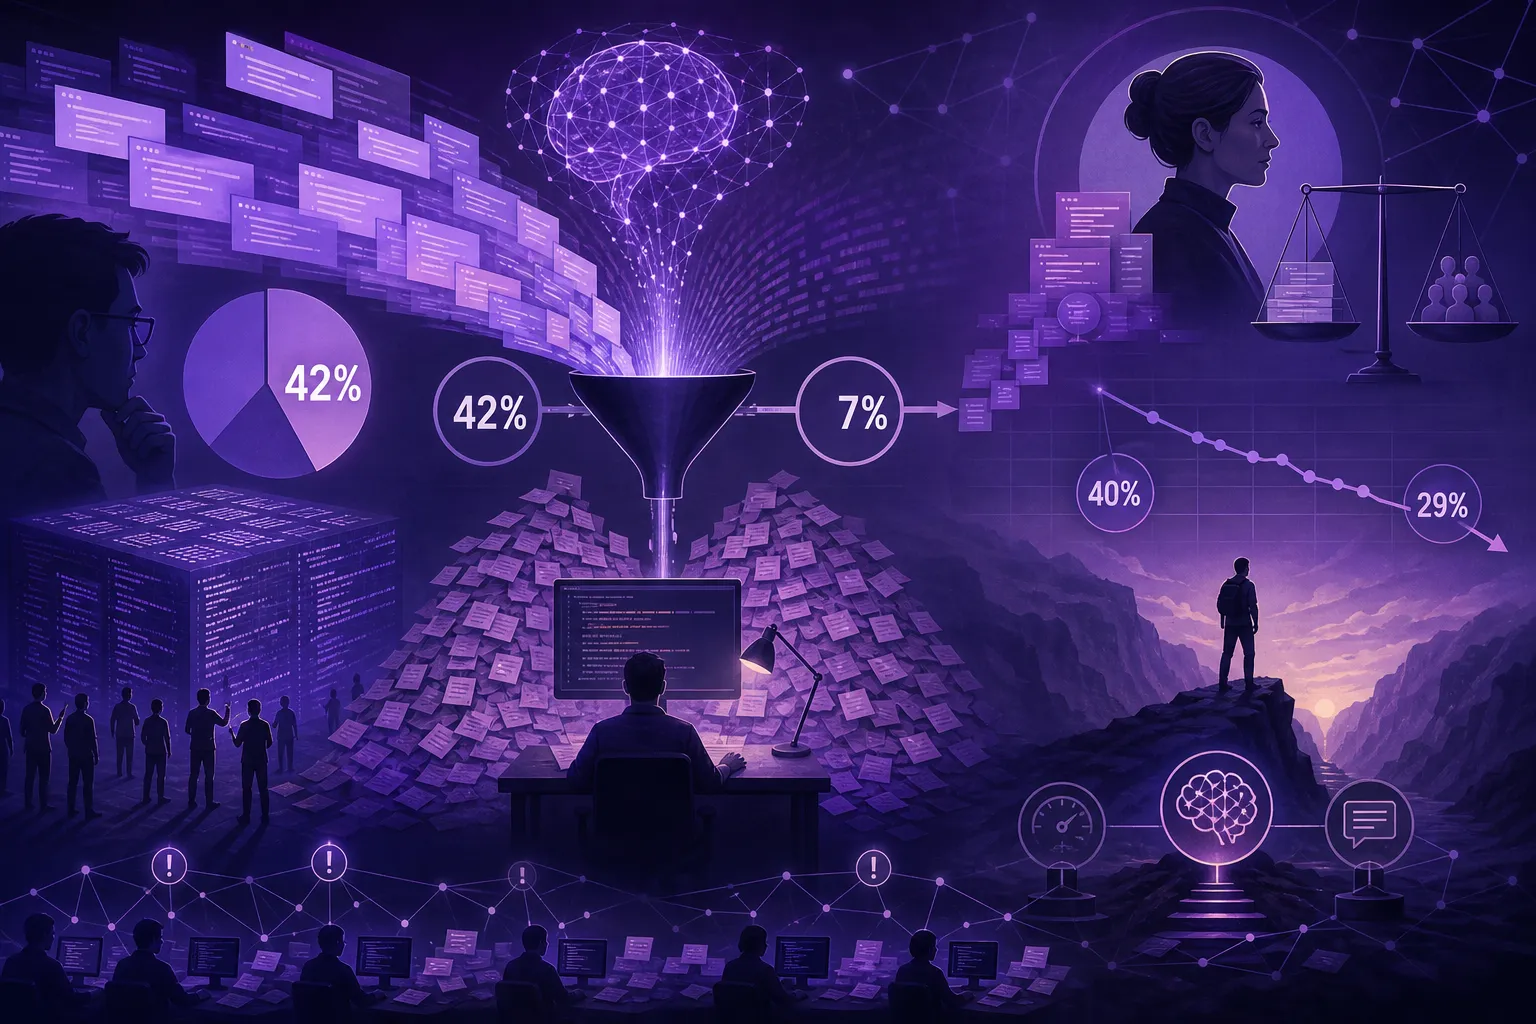
AI oszczędza 13 godzin tygodniowo, z których nie wraca ani jedna
4 min
Ankieta BairesDev za trzeci kwartał 2026 pokazuje, że AI oszczędza programistom już 13 godzin tygodniowo zamiast siedmiu rok temu, tylko że, jak przyznaje Darren Shimkus, nie wróciła z nich ani jedna. Godziny przeszły na przeglądanie kodu z modelu, szukanie w nim błędów i naukę narzędzi, która zjada dziś dziewięć godzin tygodniowo. Co najmniej połowę kodu oddaje maszynie 42% badanych, ponad trzy razy więcej niż rok wcześniej, a 58% czuje większą odpowiedzialność za kod, którego samo nie napisało. Ankietę zamówiła firma wynajmująca programistów, więc procenty czytałbym jako odczyt tendencji.
Recenzent nie pomylił się ani razu i to był problem
5 min
Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.
Agenty lepiej łatają cudzy kod, niż dopisują brakującą funkcję
3 min
Claude Opus 4.5 zamyka 74,4% zadań na SWE-bench, a na nowym benchmarku FeatureBench dowozi 11%, choć model jest ten sam i zmieniło się tylko to, o co go poproszono. Qixing Zhou i współautorzy, w pracy zgłoszonej na ICLR 2026, wycięli z 24 repozytoriów open-source kod stojący za wybranymi testami, tak że agent ma odtworzyć brakującą funkcję bez wskazanego miejsca i bez gotowych granic zmiany. Agenty domykają pętlę, którą ktoś już otworzył i opisał, a dużo gorzej radzą sobie z wykrojeniem zadania od zera. Ostrożnie z tą liczbą, bo trudność dziur ustawia sam twórca benchmarku.
Cloudflare otworzył swojego audytora bezpieczeństwa i zabronił mu wierzyć samemu sobie
4 min
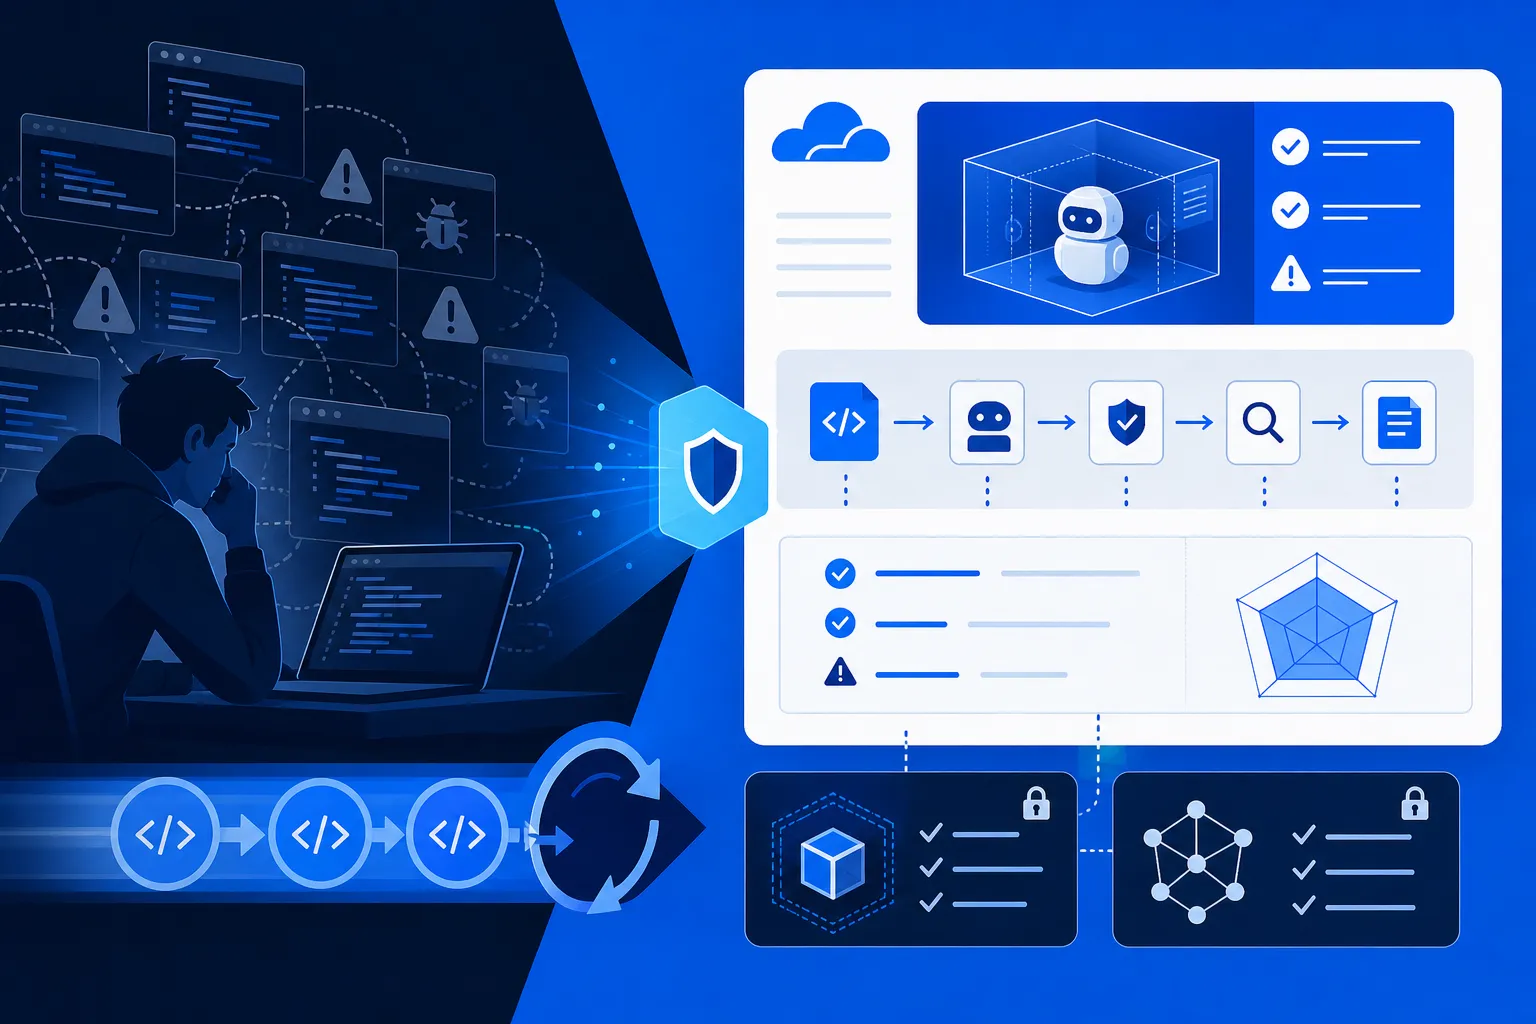
Cloudflare wyłożył na GitHubie security-audit-skill, zestaw instrukcji na licencji MIT, który zamienia agenta kodującego w zespół audytorów, gdzie ten, kto znalazł dziurę, nie ma prawa jej potwierdzić, bo do sprawdzenia rusza świeży agent z zadaniem odwrotnym: obalić ustalenie. Pilnuje tego rejestr pokrycia i walidator w Node, dzięki czemu nic nie trafia do wyników bez wskazania miejsca w kodzie, a bez piaskownicy audyt kończy się na hipotezach. Pojedynczy bieg znajduje mniej więcej połowę tego, co wszystkie razem, więc to raczej dodatkowa para oczu przed wydaniem niż bramka w CI.
Agenty gubią się w cudzym systemie, nie w składni
4 min
Real-SWE mierzy agenty na produkcyjnym kodzie licencjonowanym od prawdziwych firm, którego nie było w danych treningowych, i wyszło z tego 640 przebiegów ze średnią 26,9%, przy najlepszym wyniku 38,8% dla Fable 5.1 w Claude Code. Z 468 porażek tylko 5,1% to zepsuty kod, a 40,6% to pominięty wymóg, czyli instrukcja, której agent nie doczytał do końca. Kolejność w tabeli i tak niewiele znaczy, bo przedziały ufności czołówki nachodzą na siebie, a każdy model biegł w harnessie swojego producenta. Jedyna liczba, która cokolwiek rozstrzyga, to ta zmierzona na twoim repozytorium.
Fork Claude Code, który zdradza się już pierwszą zmienną środowiskową
4 min
OpenClaude to fork Claude Code, który po ustawieniu zmiennej CLAUDE_CODE_USE_OPENAI kieruje tego samego terminalowego agenta do ponad 20 dostawców modeli, z lokalną Ollamą włącznie, więc próg wejścia spada do zera. Narzędzia do plików, strumieniowanie i MCP zostają nietknięte, zmienia się tylko to, kto odpowiada po drugiej stronie. README przyznaje, że jakość pracy narzędziami zależy od wybranego modelu, a mniejsze modele lokalne gubią się w długich ciągach wywołań, czyli tam, gdzie agent ma pracować. Pochodzenie zdradza flaga tengu_hive_evidence, od wewnętrznej nazwy kodowej Claude Code.
14 serwerów MCP na jednym laptopie. Dopiero skaner pokazał, co potrafią.
5 min
Walden Wu przeskanował własny laptop i naliczył 14 serwerów MCP oraz pięć kluczy API leżących otwartym tekstem w konfiguracji, choć nikt się do niego nie włamał. Tak mu to narosło samo. Dwie niezależne implementacje, system zgłoszeń Christopha Hermannsa i ubezpieczeniowy serwer Juana Llamazaresa, rozbrajają to ryzyko identycznie: w kodzie zwyczajnie nie ma ścieżki zapisu, a osiem narzędzi Llamazaresa obudowano 44 testami. Skłaniam się ku tej amputacji, bo Digital Realty sprzedaje tymczasem MCP jako warstwę sterowania 800 centrami danych i o samym odczycie nie wspomina ani razu.
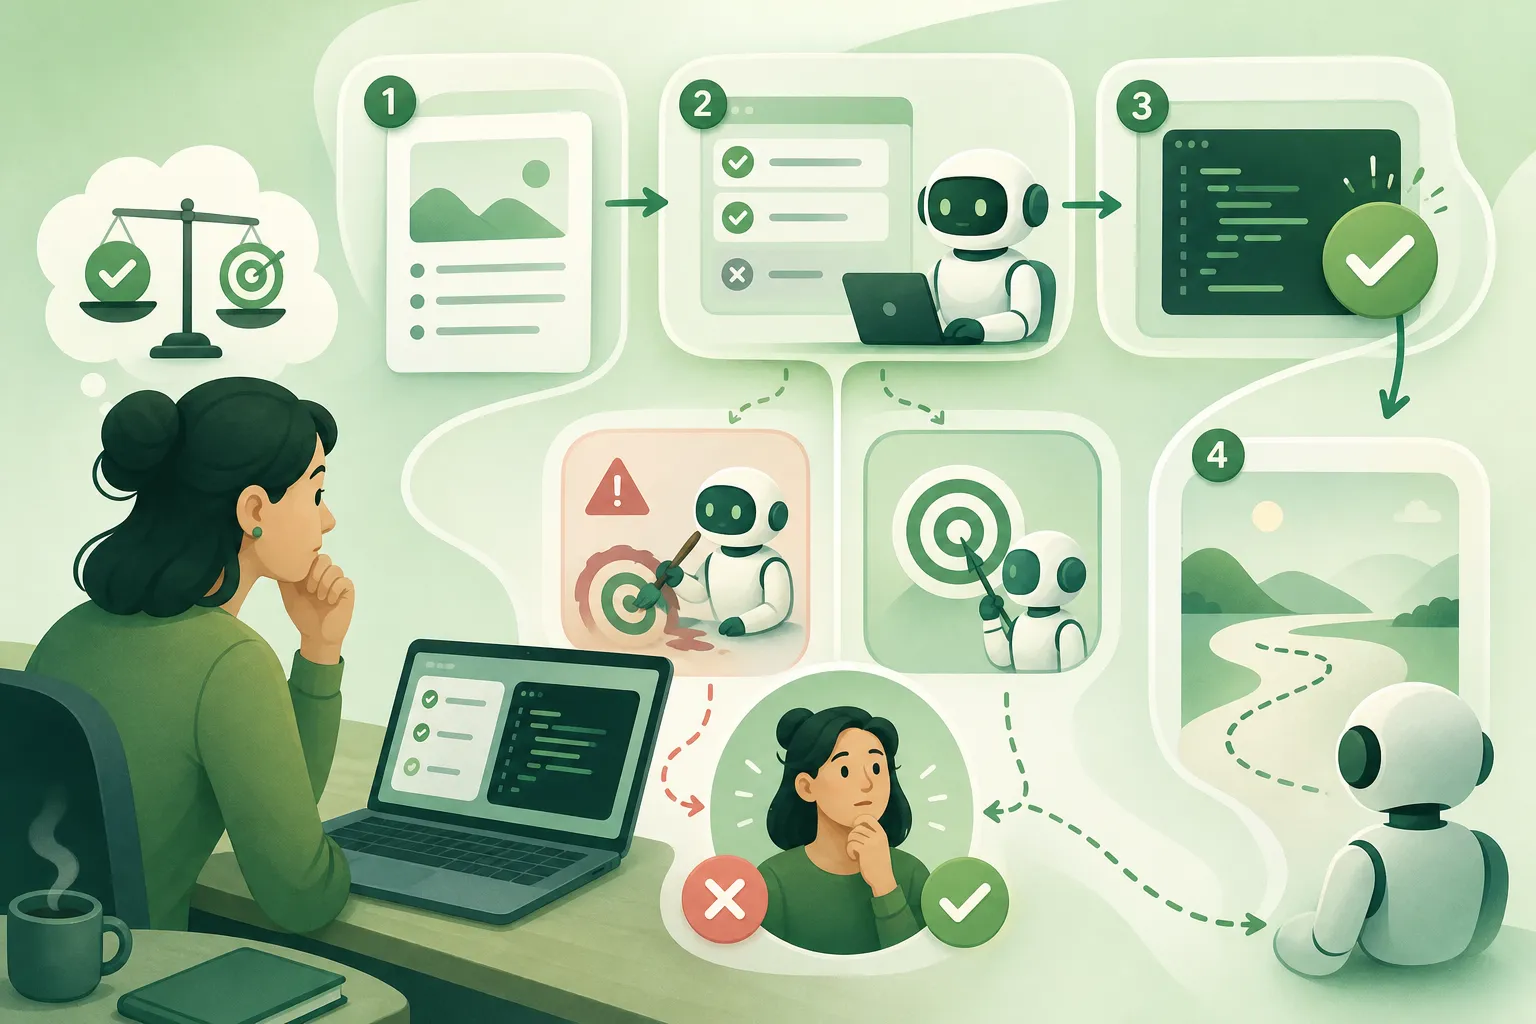
Trzy wymagania, dwie asercje i poprawka, która wygląda poprawnie
4 min
Poprawka jednym warunkiem zapala dwie asercje na zielono, ale kasuje trzeci punkt kontraktu, bo Python traktuje None i pustą listę tak samo. Człowiek taki wynik najwyżej przeoczy, natomiast agent naprawczy zbiega do testu zamiast do wymagania, więc odwrotnie napisana asercja potrafi go skłonić do zepsucia działającego kodu. W preprincie ExecCritic ten sam agent rozwiązywał 61,2% zadań z SWE-bench Verified, a ze słabszymi wygenerowanymi testami osuwał się do 57,3%, przy nierównych budżetach obliczeniowych. Stąd jedno pytanie do każdego testu: którą błędną implementację odrzuci.
Agent Cognition zabiera się do kodu po 18 krokach zamiast 48
4 min
SWE-2, nowy model Cognition napędzający Devina, zabiera się do edycji kodu po 18 krokach zamiast 48, a całą drogę przez zadanie skrócił ze 127 kroków do 53, bo koszt wpisano wprost do funkcji nagrody podczas uczenia. Na własnym benchmarku firmy wypada niemal jak Fable 5.1, 50,0% wobec 50,9%, i to o 64% taniej, ale na trudniejszym Terminal-Bench 4 zostaje daleko w tyle z wynikiem 27,3%. Cennika ani osobnego API nie ma, model dostajesz wyłącznie razem z Devinem, więc przewagi kosztowej nikt z zewnątrz na razie nie sprawdzi u siebie.
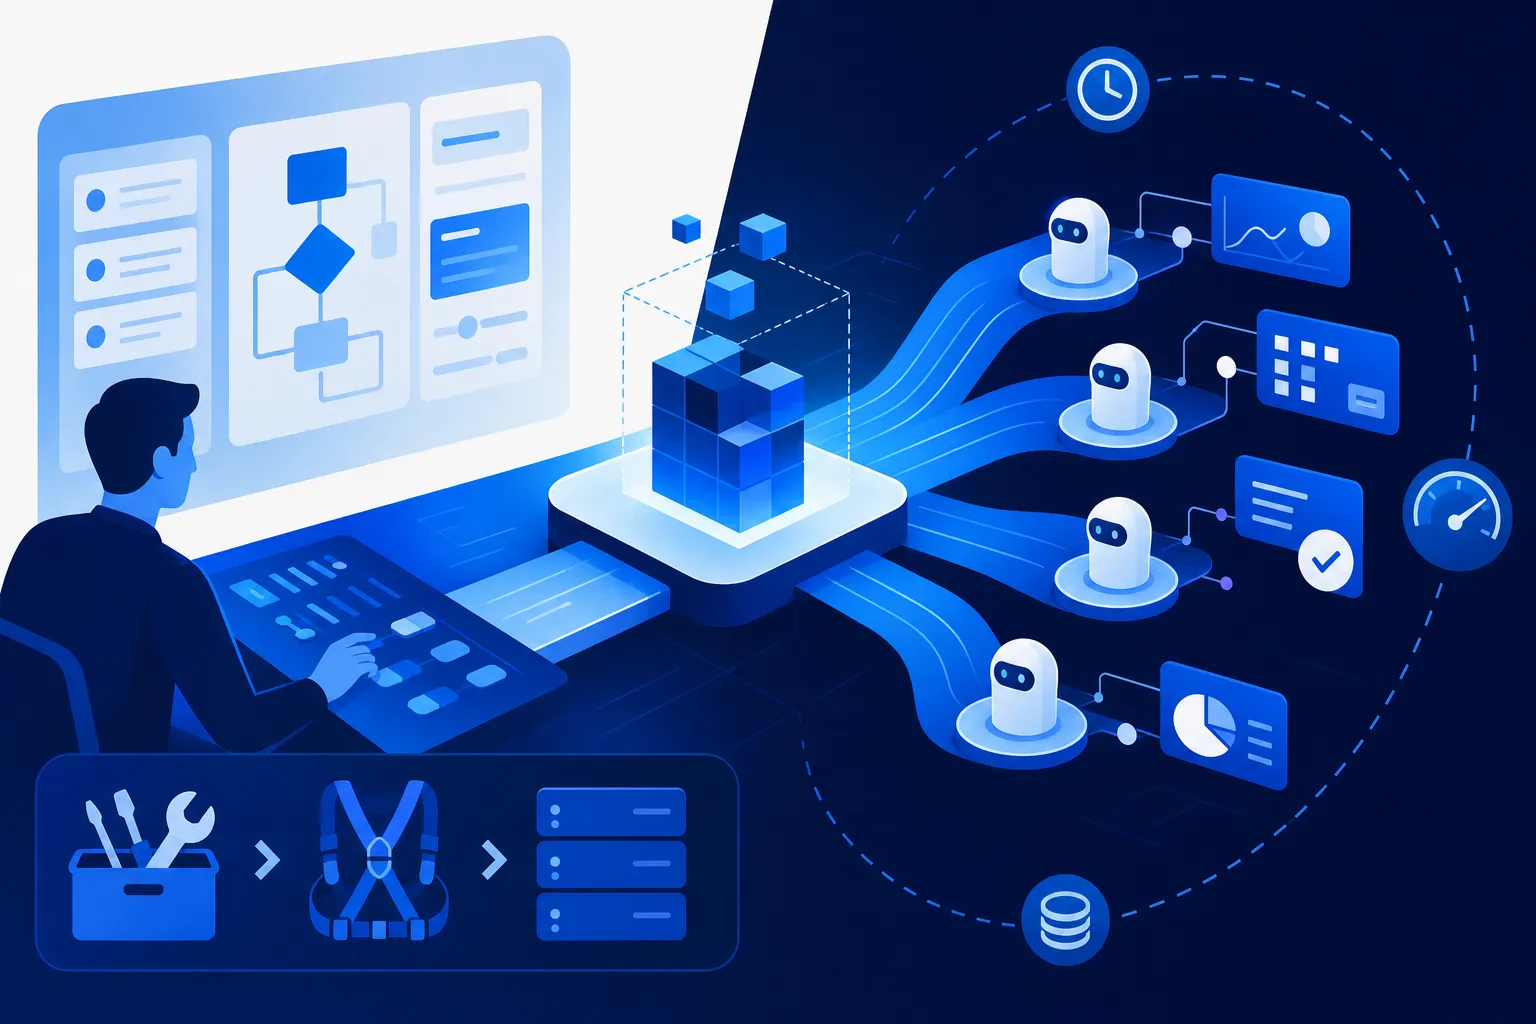
Jedno wywołanie, trzy subagenty i cała infrastruktura po stronie OpenAI
4 min
Agents API, które OpenAI pokazało 10 września, wystawia wszystkim ten sam harness, który od ponad roku pilnuje Codexa: jedno wywołanie i agent sam rozbija zadanie na maksymalnie trzy subagenty z własną pamięcią, a przy limicie okna kontekstowego sam zwija starszą część zapisu. Za samą platformę nie płacisz nic, rachunek obejmuje tokeny, narzędzia i czas kontenera, tylko że dane leżą wyłącznie w Stanach, nawet gdy sandbox stoi u ciebie. To wygoda kupiona uzależnieniem od dostawcy, bo sesja razem ze swoim stanem zostaje już po jego stronie.
Cursor stawia nad agentami koordynatora, który sam nie tyka kodu
4 min
Cursor wypuścił 10 września betę Projects: koordynator pracuje na osobnej maszynie w chmurze, sam nie tyka kodu, tylko rozsyła zadania podległym agentom, a projekt pamięta, czego się nauczyły, więc kolejny agent nie zaczyna od pustej kartki. Firma chwali się sześciokrotnie większą liczbą zmergeowanych pull requestów, ale nie podała ani wielkości grup, ani okresu pomiaru, a narzędzie rozbijające tę samą pracę na kilkanaście wątków z definicji pokaże więcej zamkniętych kawałków. Wąskim gardłem robi się wtedy ludzki przegląd kodu, więc przed pierwszym uruchomieniem warto ustawić limit wydatków.
Czy model zbuduje agenta bez inżyniera? Na razie co czwarte zadanie.
4 min
Sierra otworzyła hyper-tau-bench: 53 zadania, w których agent ma sam zbudować działającego agenta obsługi klienta. Najlepiej wypadł Claude Opus 5 z maksymalnym rozumowaniem, ale zaliczył 23,9% rozmów testowych, podczas gdy ten sam model prowadzony przez inżyniera dochodzi na tych samych zadaniach do 82,2%. Przepaść nie bierze się z pisania kodu: w zadaniach bankowych agent zaglądał do mniej niż 80 z około 1700 plików i zadawał symulowanemu klientowi najwyżej cztery pytania, choć już dwa podnosiły skuteczność z 5% do 25%. Ta różnica to po prostu cena braku nadzoru.
Kolumna z ceną w rankingu Cursora mówi więcej niż kolejność miejsc
4 min
Fable 5.1 Max zamyka 51,8% zadań w CursorBench 4.0 i wygrywa ranking, ale sąsiednia kolumna mówi więcej: to pierwsze miejsce kosztuje 17,28 dolara od zadania, a Muse Spark 1.3 Max dochodzi do 41,6% za 2,64 dolara. Poziom wysiłku waży tu więcej niż sama nazwa modelu, bo Fable 5.1 Low z wynikiem 45,1% wypada lepiej niż droższy o dwie trzecie Opus 5 High. Cursor układa zadania, sam je ocenia i w tej samej tabeli wystawia własnego Composera 2.5, który ląduje dopiero na 36. pozycji, więc czytam tę listę jak pomiar z jednego stanowiska.
Anthropic radzi opisać zadanie raz i zostawić Opusa 5 w spokoju
3 min
Anthropic radzi dawać Opusowi 5 całą specyfikację naraz i nie przerywać mu w trakcie, bo milionowe okno kontekstowe nie zmusza już do cięcia zadania na tury. Druga połowa tych porad jest o pieniądzach: przegląd kodu ma trzymać skuteczność także na niższych poziomach parametru effort, a model domyślnie startuje z high, więc konfiguracja nieruszana od czasów Opusa 4.8 kupuje dziś myślenie, które niczego już w wyniku nie zmienia. To jedyna rada z własnym sposobem sprawdzenia, bo reszta, łącznie ze zdaniem o przeglądach, to deklaracja producenta o własnym modelu.