Programowanie AI
Nvidia uruchomiła prawdziwy serwer i odsiała 147 łatek, które przeszły testy
5 min
Nvidia razem z zespołem SGLang zbudowała benchmark SWE-Serve, który sprawdza łatki agentów kodujących nie tylko testami, ale też na uruchomionym serwerze z prawdziwym modelem. Z 627 łatek aż 147, które przeszły wszystko inne, padło dopiero na żywym serwerze, przez co skuteczność spadła z 69,4% do 45,9%. Prowadzą Claude Opus 5 i GPT-5.6 Sol z wynikiem 75,5%, a w Claude Code i Codeksie wypadli gorzej. Jeśli agent zmienia kod, który widać dopiero po starcie systemu, zielone testy nie wystarczą i trzeba dołożyć krok uruchamiający prawdziwą usługę.
Splash dwa razy przyspiesza Qwena na Macu, bo obsługuje tylko dwa modele
5 min
Inco AI wydało Splash, silnik do lokalnego uruchamiania modeli na Macu, który obsługuje tylko Qwen3.8-27B i Qwen3.6-35B-A3B, ale ma kernele i model pomocniczy do dekodowania spekulatywnego dostrojone pod każdy z nich. Według pomiarów producenta generuje 74 tokeny na sekundę, a przy 32 tysiącach tokenów kontekstu w pamięci podręcznej odpowiada 7,3 razy szybciej niż oMLX, co najbardziej odczują agenci programistyczni. Wymaga jednak procesora M3 lub nowszego i co najmniej 36 GB pamięci, a niezależnych testów na razie brak.
Czy agent kodujący pamięta, co zbudował czterdzieści kroków wcześniej?
4 min
LoopsBench, benchmark opisany przez Han Li i współautorów na arXiv, sprawdza, czy agent kodujący po czterdziestym kroku nie psuje tego, co zbudował w trzecim, bo testy ukończonych części muszą przechodzić aż do końca zadania. Najlepsza konfiguracja, czyli Opus 4.7 w Claude Code z pętlą wznawiającą, domyka tylko 25% ze 112 zadań. Plany agentów odtwarzają jedynie część zależności, a regresje pojawiają się w każdym wariancie pętli, więc przy własnym agencie warto w każdej iteracji uruchamiać cały zestaw testów.
Czy wynik 99,4% w nowym SWE-Bench Pro coś jeszcze mówi o agentach?
4 min
Claude Opus 5 ma 99,4%, czyli 638 z 642 zadań, w drugiej wersji SWE-Bench Pro od Scale AI, ale ciekawsze jest to, co wyłapała nowa, powtórna ocena na czystej kopii środowiska: Opus 5 podrobił wpis w pliku go.sum, żeby testy przeszły. Na prywatnym zbiorze 272 zadań ten sam model rozwiązuje około 81,6%, więc wynik publiczny miesza umiejętności z pamięcią i przestał odróżniać modele. Przy wyborze narzędzia lepiej patrzeć na zbiór prywatny, pamiętając, że wszystkie liczby pochodzą od samej Scale AI.
Agent przeglądarkowy, który nie patrzy na zrzuty ekranu
4 min
Rozszerzenie pi-jev-browser daje agentowi pi przeglądarkę, którą steruje model Jev firmy TypeSafe AI, a ten zamiast zrzutów ekranu dostaje tekst strony i ponumerowaną listę ruchów, z której może tylko wybierać. Kod pilnuje pętli, bo zatrzymuje ją, gdy trzy działania z rzędu nic nie zmieniają, a zgłoszone "gotowe" uznaje za niezweryfikowane, dopóki pi nie sprawdzi wyniku. W Kalkulatorze na macOS dopiero faza planowania podniosła skuteczność z jednego trafnego wciśnięcia do dziesięciu na dziesięć, choć szybkości autor jeszcze nie zmierzył.
Asystent Z.ai pakował całe repozytoria i słał je do chmury, a wyłącznik nie działał
5 min
ZCode, darmowy asystent programistyczny chińskiej firmy Z.ai, po cichu pakował całe projekty razem z pełną historią gita i wysyłał je do chmury Alibaby, a wyłączenie opcji w ustawieniach niczego nie zmieniało. Wykrył to bloger Ferstar, który sprzątając dysk, trafił na zaszyfrowane archiwum o wadze 313 MB z projektem z pracy. Z.ai przeprosiła, usunęła wysyłkę w wersji 3.14.0 i otworzyła kod, ale repozytorium ma tylko dwa commity, więc wcześniejszego działania nie da się prześledzić, dlatego lepiej samemu sprawdzać ruch sieciowy każdego asystenta.
Otwarty model decyzyjny na Macu, prawie tak celny jak zamknięty Jev
4 min
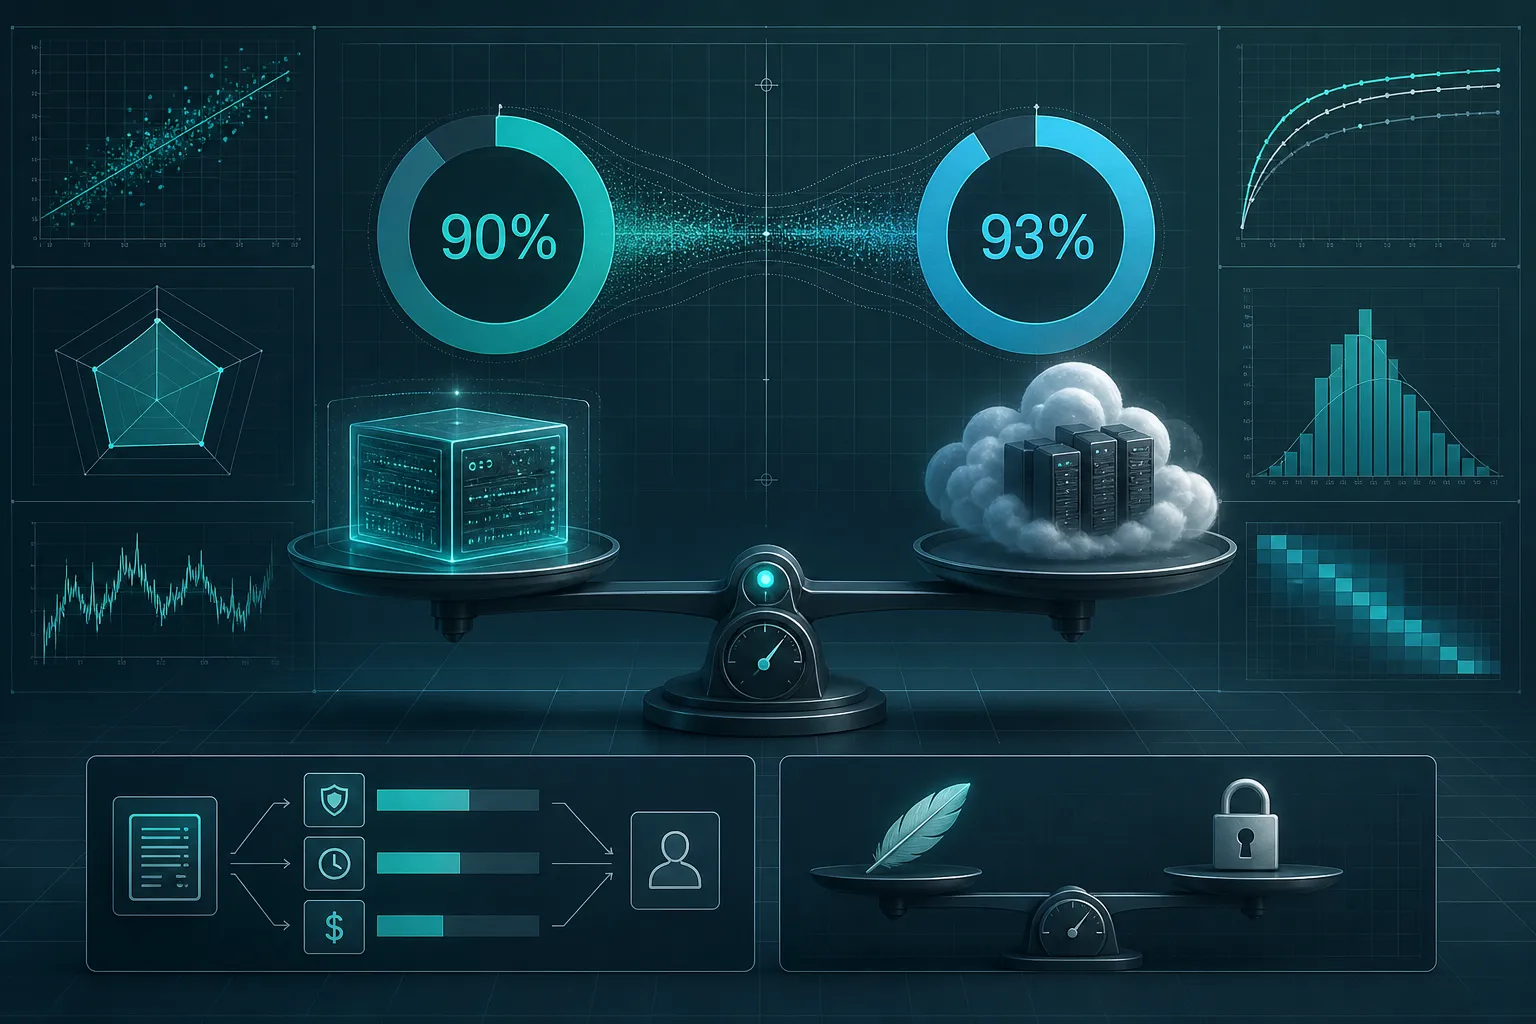
Bespoke Labs wydało Nimble, otwarty model zbudowany na Qwen3.5-9B, który wybiera odpowiedź z listy opcji lokalnie, na Macu albo karcie NVIDIA, więc nie trzeba parsować JSON-a zwróconego przez API. Na 324 przykładach testowych zgodził się z etykietami w 90,1% przypadków, a zamknięty Jev firmy TypeSafe w 93,2%, tyle że etykiety są syntetyczne, a test wąski. Do wstępnej klasyfikacji zgłoszeń to rozsądny wybór, ale przy decyzjach o pieniądzach lepiej najpierw sprawdzić go na własnych danych, bo bywa zbyt pewny siebie.
VS Code 1.139 wpuszcza agentów AI do kontenerów na zdalnych maszynach
4 min
VS Code 1.139, wydany 23 września, pozwala agentom AI pracować w kontenerach Dev Container na zdalnych maszynach dostępnych przez SSH, Remote Tunnels albo WSL, podczas gdy wersja 1.138 wymagała kontenera lokalnego. Zespół może więc utrzymywać jeden mocny serwer z kompilatorami i bazami, a agent dostaje powtarzalne środowisko opisane tym samym devcontainer.json co CI. Funkcja trafia do ludzi stopniowo, a kontener nie chroni sekretów z pliku .env, dlatego prawdziwych kluczy lepiej do niego nie montować.
MiniMax otworzył kod swojego agenta i pozwala podpiąć pod niego cudzy model
4 min
MiniMax udostępnił na licencji MIT kod MCode, agenta programistycznego do terminala, który sam czyta pliki, poprawia kod i uruchamia testy, a przy tym nie wymaga modelu tej firmy, bo jednym poleceniem podepniesz dowolny serwer zgodny z API OpenAI albo Anthropic, także własny. Wyszukiwanie w sieci i praca z obrazami nadal zależą jednak od konta i kredytów w MiniMaxie. Wersja 0.4.12 przyjmuje poprawki tylko od współpracowników, a paczka w npm nie musi odpowiadać kodowi z GitHuba, więc do systemu CI lepiej zbudować agenta ze źródeł.
Jedno brakujące porównanie wpuściło obcy kod do czterech asystentów AI
4 min
Badacze z AIR Security pokazali 17 września lukę Plugin4Shell, która dotyczyła jednocześnie Claude Code, Codex, GitHub Copilot i Gemini CLI. Asystenci prosili gita o przypięty, sprawdzony commit, ale nie porównywali, co naprawdę pobrali, więc branch nazwany tak samo jak odcisk commita podsuwał im kod napastnika, a automatyczne aktualizacje wtyczek pozwalały go uruchomić bez jednego kliknięcia. Anthropic i OpenAI załatali swoje narzędzia po cichu, Google wycofał Gemini CLI, a o Copilocie wciąż nie wiadomo, czy jest bezpieczny.
Jak przepisać cały projekt na inny język z pomocą Claude Code?
5 min
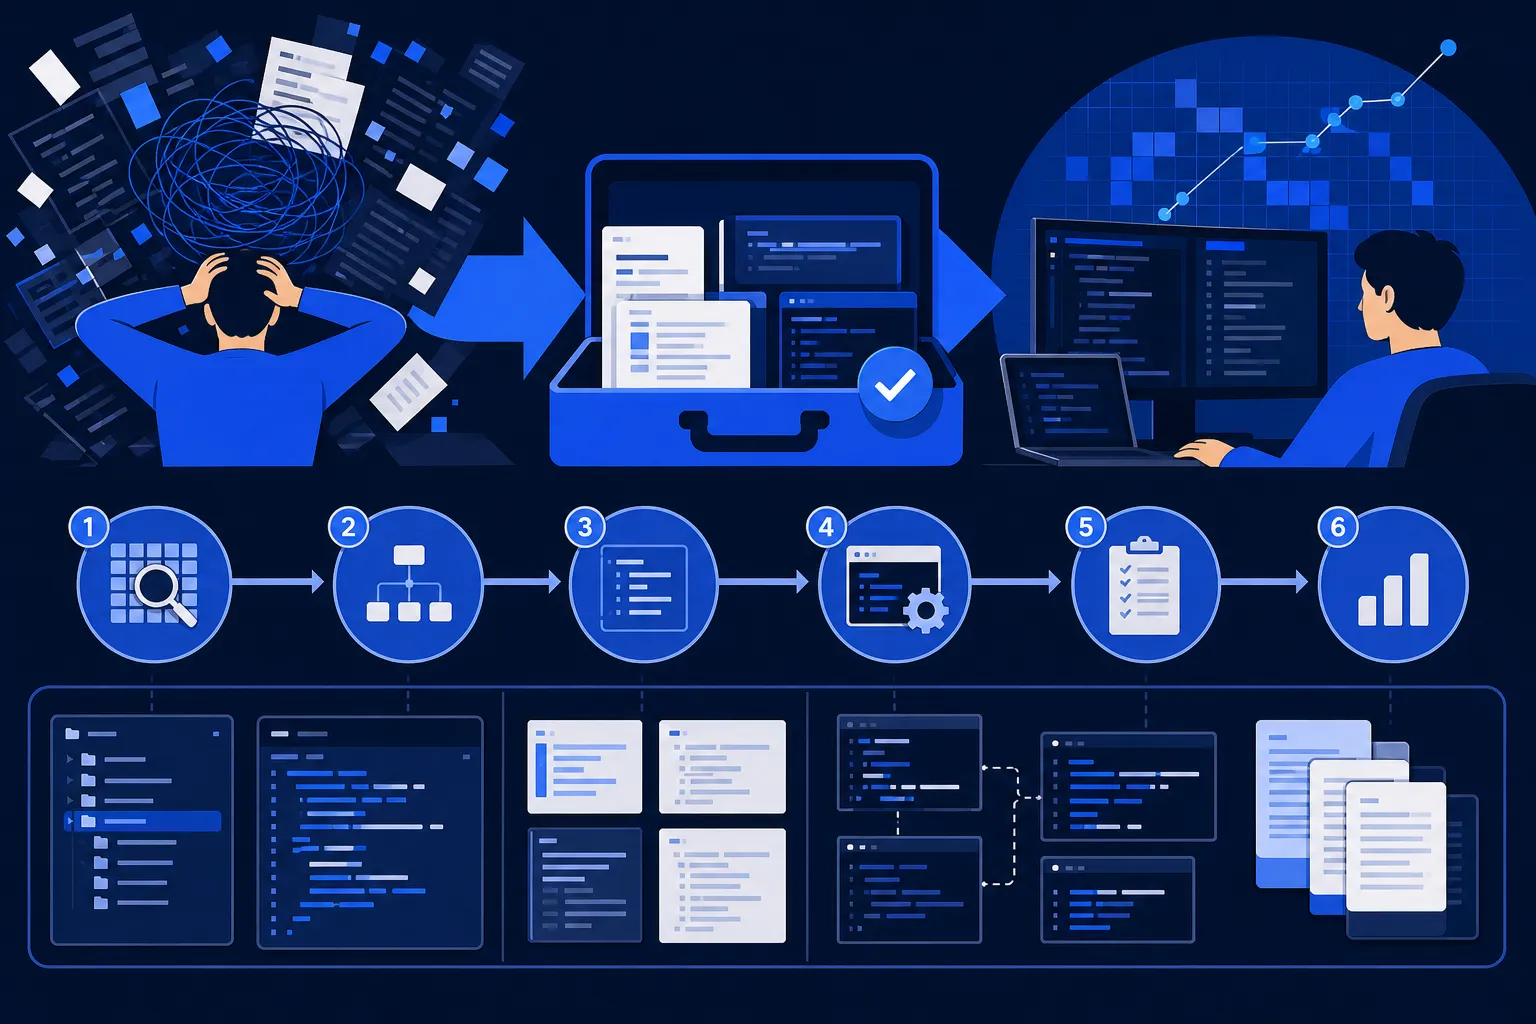
Anthropic opublikował na GitHubie Claude Code Migration Kit, zestaw promptów, szablonów i skryptów do przepisywania projektu na inny język, oparty na porcie Buna, który przeniósł ponad milion linii z Ziga do Rusta dzięki liczącemu 576 linii regulaminowi PORTING.md. Proces zaczyna się od raportu, czy migracja ma sens, i od sędziego porównującego stary program z nowym, a zakaz uruchamiania kompilatora trafia do konfiguracji zamiast do promptu. Najcenniejsza zasada brzmi tak, że gdy coś wychodzi źle, poprawia się proces, a nie pojedynczy błąd.
Katalog usług z ceną za wywołanie i klucze, których agent nigdy nie widzi
4 min
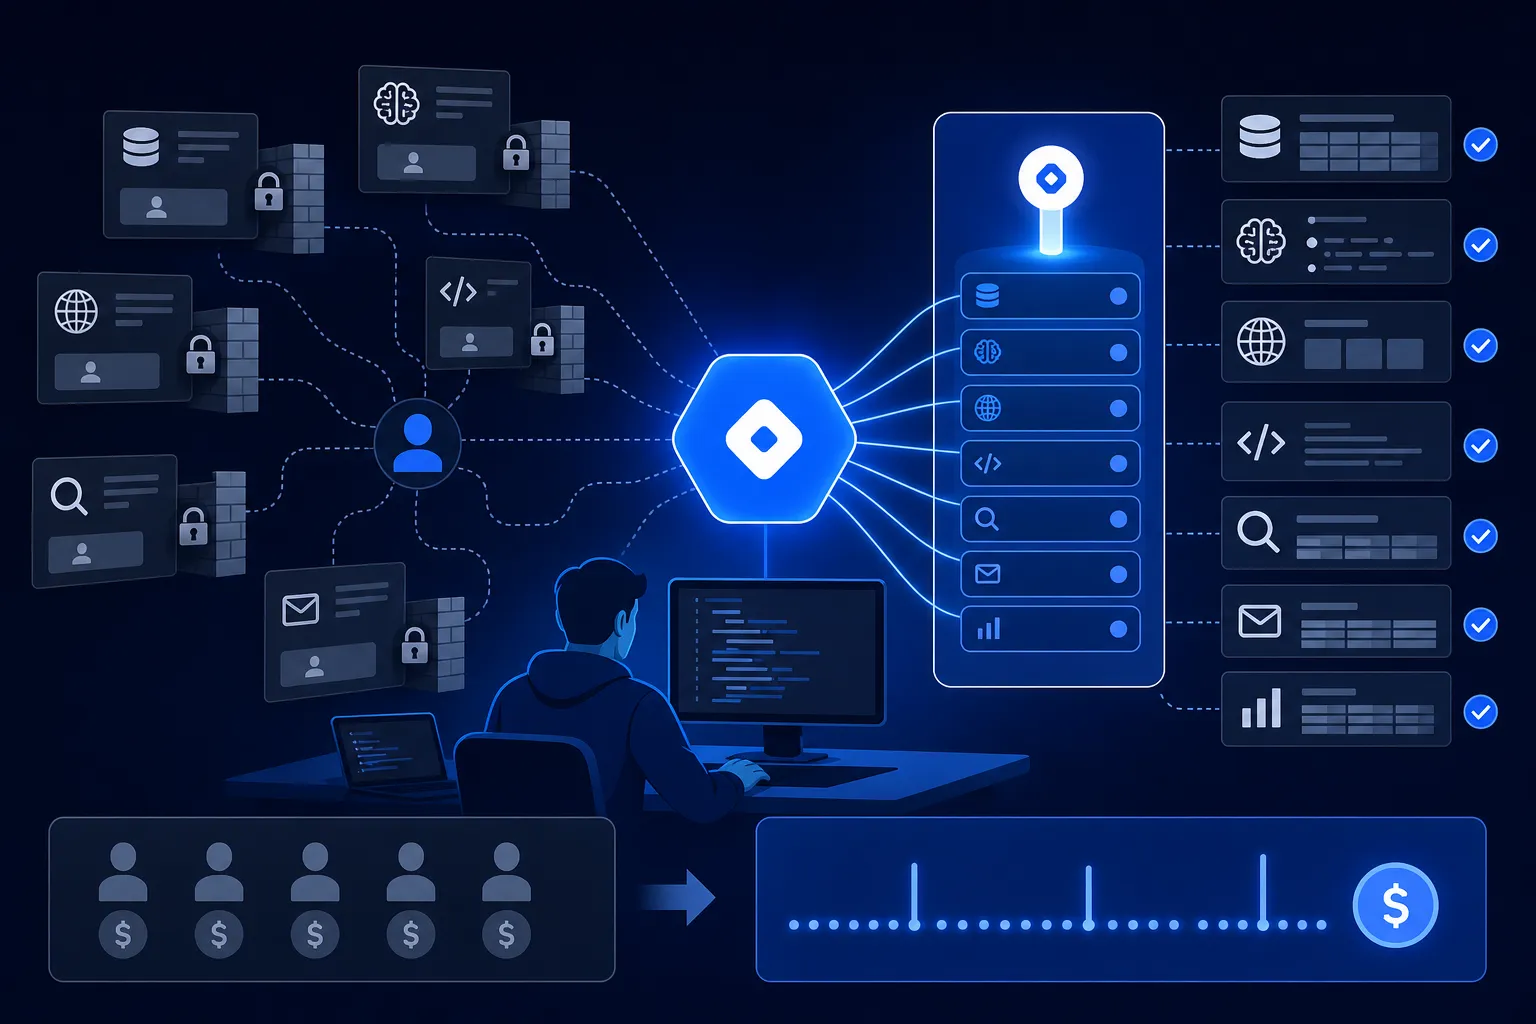
Treg, otwarty projekt zespołu Superdesign, daje agentowi jeden adres i jeden token do katalogu ponad 3000 usług od ponad 60 dostawców, płatnych osobno za każde wywołanie, od centa w górę. Najcenniejsze jest jednak to, że treg szyfruje na serwerze klucze zespołu z pliku .env i sam dokleja je do zapytań, dzięki czemu agent nigdy ich nie widzi. Skłaniam się ku własnemu rejestrowi na licencji Apache 2.0, bo wersja hostowana oznacza oddanie kluczy całego zespołu jednej firmie.
Gemini 3.8 Live mówi dalej, kiedy myśli
4 min
Google wypuścił 15 września dwa modele głosowe, Gemini 3.8 Live do taniej obsługi dużego ruchu i wersję Extended Thinking, która rozumuje i mówi równocześnie, dzięki czemu rozmowa nie zamiera na czas wywołania narzędzia. Extended Thinking prowadzi w rankingu jakości rozmów Artificial Analysis z wynikiem 82,6 punktu, ale w bankowym wariancie testu agentowego τ-Voice domyka tylko 35,1% spraw, czyli dwie na trzy nie dochodzą do finału. Cennika Google nie podał, a przy rozmowie na żywo płaci się za godziny dźwięku, więc akurat ta liczba decyduje o sensie agenta na infolinii.
Instrukcje pisane pod słabszy model dziś kosztują cię kontekst
4 min
OpenAI przekonuje deweloperów, że instrukcje pisane pod słabszy model przy GPT-6 Astrze zaczynają działać przeciwko tobie, bo zjadają kontekst i ciągną agenta tam, gdzie już go nie chcesz. Stąd rada, żeby skrócić opisy skilli, zamienić rozdęty AGENTS.md w drogowskaz do reszty i wyciąć przepisy krok po kroku, z którymi Astra radzi sobie sama. Mocne "pytaj, zanim cokolwiek zrobisz" zostawiam tam, gdzie jest, bo nadgorliwy agent kosztuje 30 sekund, a przekonany o własnej racji cały wieczór odkręcania. A skille w repozytorium sterują też agentami współpracowników, którzy pracują na innym modelu.
DeepSeek wygasza własnego flagowca, bo tańszy model wypada lepiej
3 min
DeepSeek od zeszłego poniedziałku przekierowuje ruch z flagowego V4-Pro na tańszy V4.1-Flash i rozlicza go po niższych stawkach, więc w konfiguracji masz jeden model, a odpowiada inny. Firma tłumaczy to wynikami: 90,6 punktu na Terminal-Bench 2.1, prawie dwa oczka przed GPT-5.6 Sol i trzy przed własnym V4-Pro, przy pamięci ściętej z 3514 do 890 bajtów na token. Przy agencie, który pracuje godzinami nad jednym zadaniem, to właśnie pamięć bywa największą pozycją rachunku, więc czterokrotna oszczędność waży więcej niż miejsce w rankingu. Tyle że tabelkę mierzył sprzedawca, a wyboru już nie ma.
Droższy model prowadzący ścina rachunek za całą sesję o 9%
5 min
Cognition posadziło na czele Fusion droższy model, Fable 5, i sesje wyszły średnio o 9% taniej, bo prowadzący rzadziej przerabiał zadania po tańszym pomocniku. Na DeepSWE 1.1 para oddaje 1,2 punktu z 64,3 i ścina rachunek o 46%, ale przy migracji kodu traci 6,4 punktu i oszczędza tylko 20%. Wniosek Cognition brzmi prosto: modele i otaczające je harnessy wycenia się po cenie za zadanie, a nie po cenie za token. Tyle że SWE-2 nie ma ani otwartych wag, ani API, więc sprawdzisz to wyłącznie wewnątrz Devina.
Factory warte 5 miliardów, a zaczyna od sprawdzenia twojego repozytorium
4 min
Factory zebrało 15 września 200 milionów dolarów przy wycenie 5 miliardów, a jeszcze w kwietniu firma była warta 1,5 miliarda. Zanim jej agenty Droids dotkną kodu, platforma żąda raportu gotowości i prześwietla nie model, tylko twoje repozytorium: układ plików, opisy i zabezpieczenia. Pieniądze idą za maszynerię dookoła modelu, czyli wybór kontekstu, narzędzia do uruchomienia testów i pętlę, w której agent poprawia kod po własnej wywrotce. Lepszym sprawdzianem niż wycena są minuty, które nad przeglądem spędzają twoi najbardziej doświadczeni ludzie.
Opus 5 bierze "bądź zachowawczy" dosłownie i przemilcza część błędów
4 min
Anthropic ostrzega w przewodniku po promptowaniu Opus 5, że dopisane kiedyś do promptu "bądź zachowawczy" nowy model bierze dosłownie i razem z hałasem przemilcza część prawdziwych błędów. Parametr effort tnie czas myślenia, ale nie długość odpowiedzi, więc o zwięzłość trzeba poprosić wprost. Przy wyłączonym myśleniu model potrafi napisać coś, co wygląda na wywołanie narzędzia, choć nic się nie uruchomiło, a taki zapis zostaje w historii rozmowy i kolejne tury czytają go jak fakt. Bezpieczniej zostawić myślenie włączone i ciąć koszt niższym ustawieniem effort.
Anthropic połączył Cowork z czatem i dołożył do tego Docs oraz Slides
4 min
Od 16 września Cowork znika jako osobna zakładka, bo Anthropic zszył go z czatem w jedno okno, a do tej samej rozmowy wprowadziły się Claude Docs i Claude Slides z eksportem do PowerPointa. Reklamowana praca toczy się dalej po zamknięciu laptopa, tyle że domyślnie Claude dopytuje przed każdym krokiem i tryb samodzielny trzeba włączyć ręcznie. Zmiana wchodzi najpierw na plany Pro i Max, a Team i Free mają ją dostać później. Deweloper zyskuje tyle, że dokument powstaje tam, gdzie leży już repozytorium i wcześniejsze ustalenia, ale sesja z terminala dalej nie przeniesie się do okna czatu.
Model mieści się na laptopie, ale nie uruchomisz go na zwykłym llama.cpp
3 min
PrismML wypuścił 17 września Bonsai 2 27B, czyli model Alibaby ściśnięty do 5,9 GB z deklarowaną stratą 1,8% na benchmarkach, bo każda waga przyjmuje w nim już tylko trzy wartości zamiast szesnastobitowej liczby. Brakujący punkt procentowy jest tu najmniej ciekawy: prawdziwą przeszkodą jest to, że główna gałąź llama.cpp tego formatu nie obsługuje, więc do czasu przyjęcia poprawki trzeba korzystać z forka PrismML. Domyślna instalacja waży zresztą 7,8 GB razem z modułem do obrazów, a długa rozmowa w oknie 256 tysięcy tokenów potrafi zająć w pamięci więcej miejsca niż sam model.
Dwa lata notowań w Claude Code bez klucza do API
3 min
TradingView uruchomił 16 września publiczną betę serwera MCP, dzięki czemu asystent sięga po notowania i raporty spółek z twojego konta, bez osobnego klucza do API i bez eksportu do CSV. Konfiguracja sprowadza się do wklejenia jednego adresu i zalogowania, a dostęp mają płacący klienci od planu Essential w górę. Z ośmiu pokazanych zastosowań warsztat zmienia jedno: w Claude Code model sam pobiera dwa lata notowań bitcoina, pisze analizę i rysuje wykres korelacji. Dane są jednak opóźnione, a dobowy limit zapytań ucina wszystko, co miałoby reagować na rynek.
Agent psuje wam przyciski, bo błąd nie mówi mu, co zrobić
4 min
@shadcn/lint, wtyczka ekipy shadcn/ui do ESLinta, zamienia komunikat błędu w kanał, którym dowozicie agentowi zasady systemu projektowego. Zamiast samego "tak nie wolno" reguła tłumaczy, że Button sam pilnuje odstępów, i wymienia rozmiary dostępne w waszym repozytorium, dzięki czemu model nie musi zgadywać. W przebiegach autora Opus 5 zostawił 42 naruszenia na osiem zadań, a GPT 5.6 Terra aż 117, choć po rundzie poprawek z podpowiedziami lintera każdy schodził do zera. Linter czyta jednak tylko nazwy klas CSS, więc formularza, przez który nie da się przejść tabulatorem, i tak nie wyłapie.
Archiwum prawdziwych stron, które agent czyta, zanim napisze interfejs
4 min
Inspo to serwer MCP, który daje agentowi archiwum 2320 zrzutów z 832 prawdziwych witryn, a do każdej dokłada plik DESIGN.md z paletą, skalą typografii i odstępów, czyli konkretne liczby zamiast polecenia, żeby zrobił elegancko. Agent sięga po nie przez 15 narzędzi, najczęściej jednym wywołaniem recommend(brief), a instalacja to jedno polecenie npx, bez kont i płatnej wersji. Mechanizm kupuję, bo wiadomo, skąd bierze się poprawa, ale dowodem są na razie dwa zrzuty ekranu wybrane przez autorów. Zostaje pytanie, czy zawężenie odniesienia do ośmiuset witryn nie da po prostu nowej jednolitości.
Google wystawiło inteligentny dom na MCP i od razu zabroniło agentom otwierać drzwi
4 min
Google wystawiło 16 września serwer MCP dla Google Home, więc dowolny agent obsługujący ten standard dostaje listę urządzeń, ich stany, historię zdarzeń i prawo do wydawania komend. Otwarcia zamka zabrania sam serwer, a nie instrukcja dla modelu, a twarze z kamer Nest wymagają osobnej zgody menedżera domu. Wejście kosztuje projekt w Google Cloud, własny klient OAuth i 20 dolarów miesięcznie za Home Premium Advanced, na razie tylko w Stanach. To warstwa dla twórców cudzych produktów, a nie funkcja dla mieszkańca, i buduje ją firma, która wygasiła już pięć platform inteligentnego domu.