Wydanie · Tydzień 29 · 13–19 lipca 2026
Archiwum wydań →Prawie wszystko w tym tygodniu wychodzi jako open source: modele, routery, recenzenci kodu i biblioteki do trenowania. Tyle że każde wydanie ma osobny haczyk decydujący, kto naprawdę może tego użyć: od wag na 1,7 TB, których nie uruchomisz w domu, po silnik zamknięty w becie.
Premiera / Narzędzie · 21
Agent Weco przez osiem dni przepisywał sam siebie i pobił dwa lata pracy inżynierów
5 min
Weco skierowała swój autonomiczny agent badawczy na własny szkielet i po ośmiu dniach bez udziału człowieka system wymyślił wersję siebie lepszą niż ta, którą jej inżynierowie budowali przez dwa lata. Firma nazywa to pierwszym dowodem na rekurencyjne samodoskonalenie, ale uczciwie stawia się dopiero na pierwszym z czterech szczebli własnej drabiny. Zwycięski AIDE 85 pobił ręcznie strojonego agenta na trzech nieznanych mu benchmarkach i sam ograniczył naciąganie metryki z 63 do 34 procent, choć część jego kodu jest martwa i nikt nie wie, dlaczego całość wypada tak dobrze.
Recenzja kodu, która nie zmyśla znalezisk
3 min
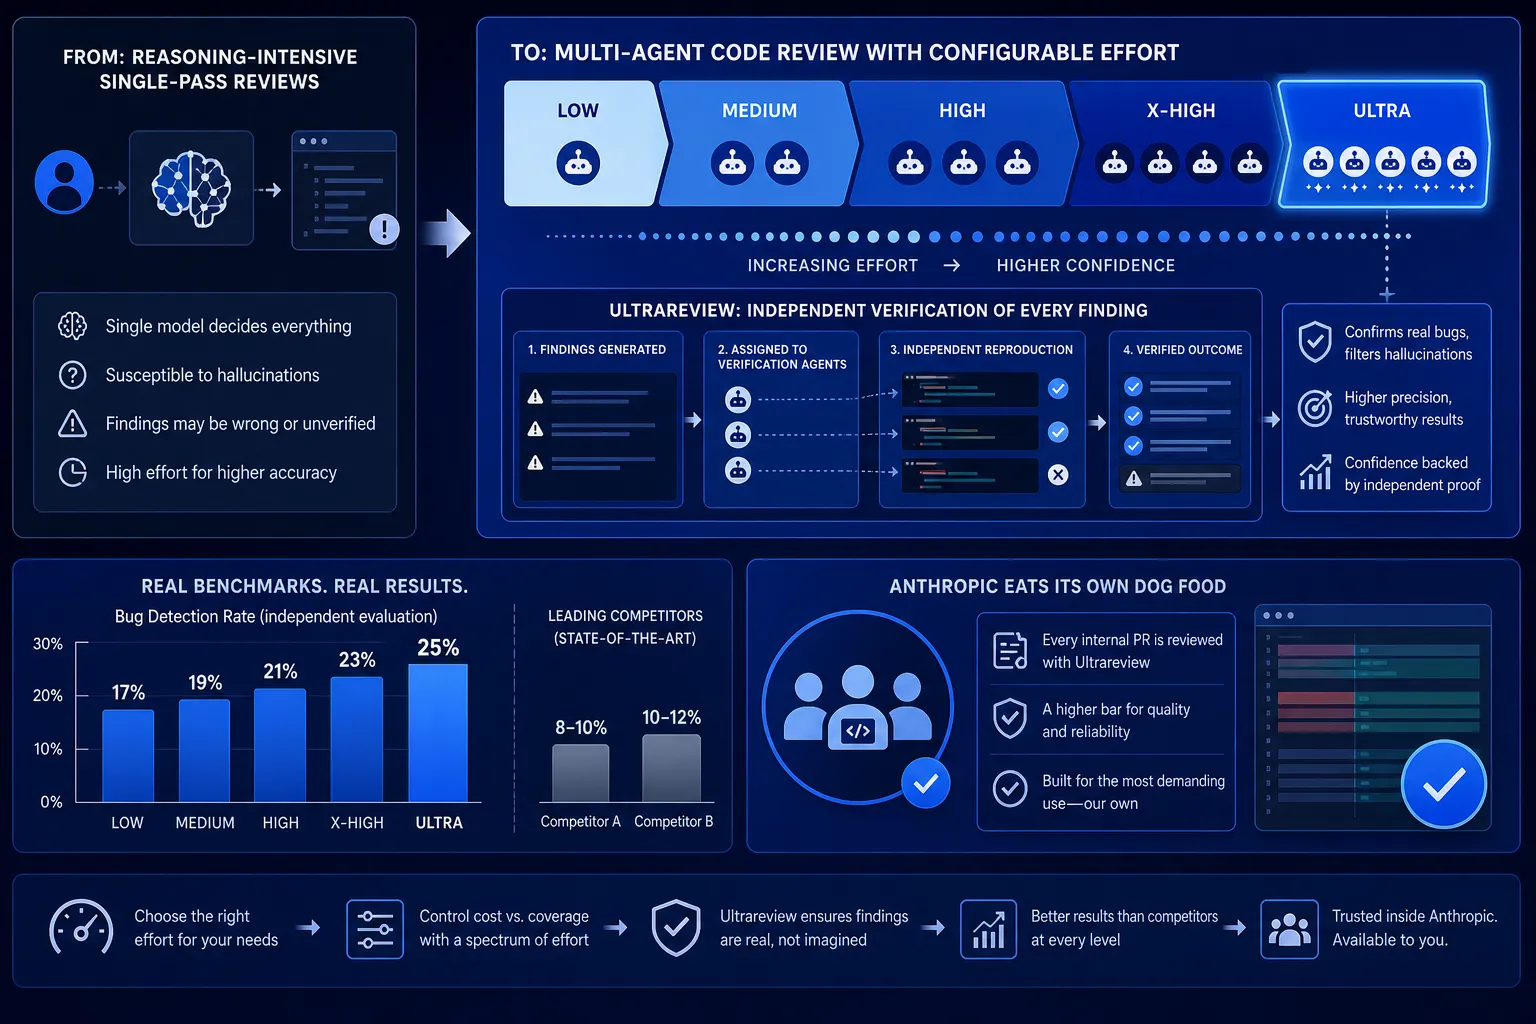
Anthropic przebudował recenzję kodu w Claude Code: zamiast jednego suwaka między krótszym a dłuższym myśleniem dostajemy pięć poziomów, od Low po Ultra. Najciekawszy jest tryb Ultra, który przenosi analizę do chmury i każdą zgłoszoną usterkę najpierw niezależnie odtwarza, więc do raportu trafiają tylko potwierdzone błędy, a nie zmyślony szum. Według domowych testów na Opusie 4.8 wykrywalność rośnie z 17% w najlżejszym trybie do 25% w najcięższym lokalnym, więc nawet on przepuszcza trzy czwarte usterek.
OpenRouter sam wybiera model do kodu, ty podajesz tylko próg jakości
4 min
OpenRouter uruchomił router Pareto Code: zamiast wskazywać konkretny model do pisania kodu, podajesz jedną liczbę, min_coding_score od 0 do 1, a router sam dobiera najtańszy model mieszczący się w progu jakości według rankingu Artificial Analysis. Wybrany model zostaje przypięty do rozmowy na pięć minut, żeby nie stracić prompt cache. Pomysł oszczędza czas, gdy modele wymieniają się co tydzień, ale ma granice: nie ustawisz twardego limitu kosztu, a poziom jakości definiuje jeden uśredniony benchmark, który nie mówi, czy model trzyma się akurat na twoim kodzie.
Twoje klucze, twoja maszyna, rachunek za AI niższy nawet o 70%
4 min
NadirClaw to otwarty router LLM, który uruchamiasz lokalnie jako pośrednik między narzędziem a dostawcą modelu, więc klucze API nigdzie nie wychodzą. Kieruje proste zapytania, czyli 60-70% typowej sesji, do tańszych modeli i sięga po mocniejszy dopiero, gdy tani nie da rady, a przy okazji kompresuje tokeny wejściowe o 30-70%, ścinając ośmiogodzinny dzień z Claude Code z około 24 do poniżej 11 dolarów. Haczyk w tym, że efektowne wyniki z rankingów pochodzą z płatnej wersji Nadir Pro, a otwarta licencja PolyForm Noncommercial i tak nie pozwala użyć go komercyjnie w firmie.
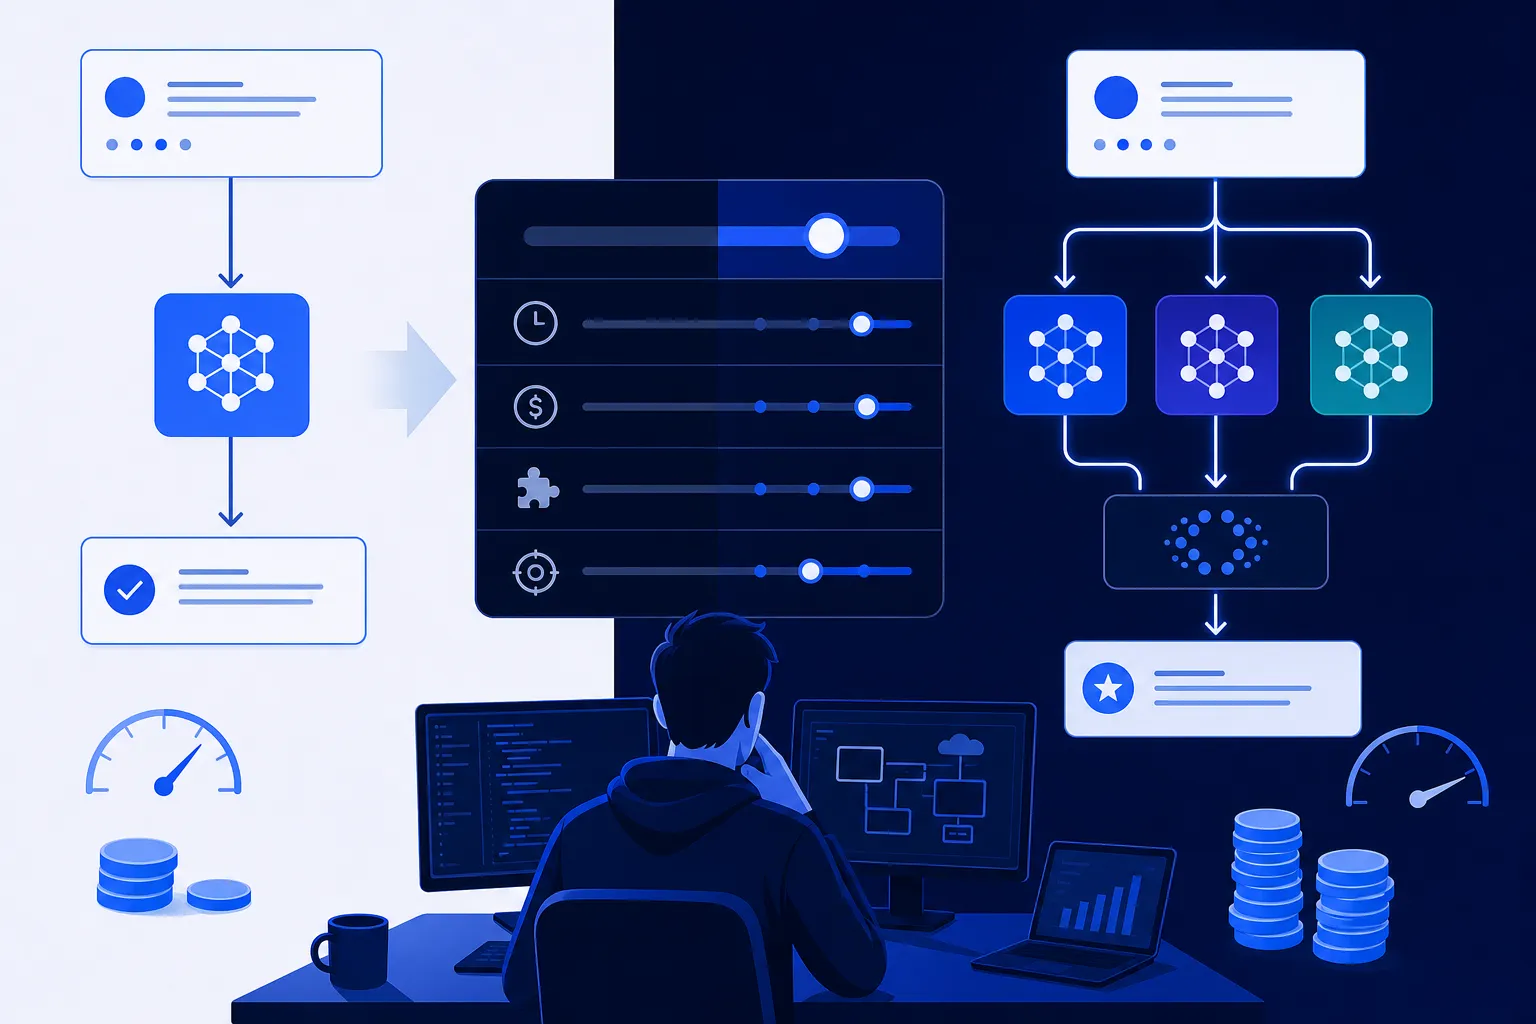
OpenRouter Fusion: panel modeli i sędzia zamiast jednego pytania
4 min
OpenRouter uruchomił 14 czerwca Fusion: ten sam prompt idzie do panelu kilku modeli, a osobny model-sędzia zestawia ich odpowiedzi i pisze z nich jedną. Na benchmarku DRACO trójka tańszych modeli sięgnęła 64,7%, o włos od najlepszego solisty Claude Fable 5 (65,3%), i to za połowę ceny. Sporo zysku bierze się nie z różnorodności modeli, tylko z drugiej próby i redakcji: Opus 4.8 sparowany sam ze sobą podskoczył z 58,8% do 65,5%. Fusion nie zastępuje modelu do kodu i trwa dwa do trzech razy dłużej, więc opłaca się dopiero tam, gdzie pomyłka kosztuje tydzień pracy.
PR-AF stawia na wolną recenzję kodu i próbuje obalić własne uwagi, zanim je wyśle
4 min
PR-AF od Agent-Field to agent do recenzji kodu, który nad jednym pull requestem pracuje od 35 do 50 minut i zanim wyśle jakąkolwiek uwagę, próbuje ją najpierw obalić, przepuszczając dalej tylko te poparte dowodem z konkretnej linijki. Na benchmarku Code-Review-Bench z otwartym modelem GLM-5.2 osiąga 0,706 golden recall, pierwsze miejsce wśród narzędzi open-source w zestawieniu 42 pozycji, choć liczby pochodzą na razie od samych twórców. Ma być nie konkurencją dla Claude Code, tylko ostatnią bramką w GitHub Actions tuż przed mergem, z domyślnym limitem 2 dolarów na recenzję.
Podręcznik dostrajania modeli, do którego trzeba się najpierw zapisać
4 min
Thinking Machines Lab udostępniło na GitHubie tinker-cookbook, otwartą bibliotekę dziewięciu gotowych receptur na dostrajanie modeli językowych, od trójstopniowego RLHF, przez destylację, po dane audio i modele wizualno-językowe. Kod jest otwarty, ale silnik pod spodem, Tinker, chodzi na serwerach firmy w zamkniętej becie, więc żeby cokolwiek uruchomić, trzeba poprosić o dostęp i czekać. W zestawie jest też framework do oceny z dwunastoma benchmarkami i dwie umiejętności dla Claude Code. Bliżej temu do podręcznika podpiętego pod lejek do API niż do narzędzia, które każdy odpala po południu.
Mniej fałszywych alarmów, bo narzędzie kłóci się samo ze sobą
3 min
Capital One udostępniło 16 lipca jako open-source (Apache 2.0, GitHub) VulnHunter, agentowe narzędzie, które szuka podatności tak jak napastnik: startuje od punktów wejścia i idzie w przód przez logikę aplikacji, zamiast cofać się od groźnego wzorca. Jego falsification engine po znalezieniu dziury najpierw próbuje obalić własną tezę, więc do programisty trafia tylko to, czego narzędzie nie zdołało odrzucić, co ma ściąć lawinę fałszywych alarmów. Cała walidacja jest jednak wewnętrzna, a do uruchomienia potrzeba modelu Claude Opus 4.8 i środowiska Claude Code.
Dlaczego lepsze narzędzia popsuły recenzenta kodu w Copilocie
3 min
GitHub podmienił narzędzia, którymi jego agent do recenzji kodu w Copilocie przeszukuje repozytorium, na wspólny uniksowy zestaw z Copilot CLI, i wyszło odwrotnie: recenzja podrożała, a agent łapał mniej problemów. Napalys Klicius prześledził zapisy przebiegu i zobaczył, że agent zwiedzał całe repozytorium zamiast badać jeden pull request, bo odziedziczył instrukcje pisane pod interaktywną pracę CLI. Przepisanie ich pod rytm recenzenta obniżyło koszt o około 20% przy tej samej jakości. Morał: na cudzym frameworku dziedziczysz nie tylko narzędzia, ale i zaszyte w ich opisach założenia o pracy.
cangjie-skill zamienia książki i podcasty w testowane skille dla agentów
3 min
cangjie-skill, otwarte narzędzie dewelopera podpisującego się jako kangarooking, przerabia książki, wykłady i podcasty na pliki SKILL.md, które agent sam wywołuje przy pasującym zadaniu. Sercem jego procesu RIA-TV++ jest potrójna weryfikacja: przez sito co najmniej dwóch niezależnych potwierdzeń przechodzi zwykle 25 do 50 procent kandydatów, a to, co zostaje, jest jeszcze testowane pytaniami-pułapkami jak kod. W odróżnieniu od RAG, który zwraca najbardziej podobny fragment, gotowy skill z góry wie, kiedy ma się odpalić. Projekt jest jednak wczesny: ponad 20 paczek zrobił głównie sam autor.
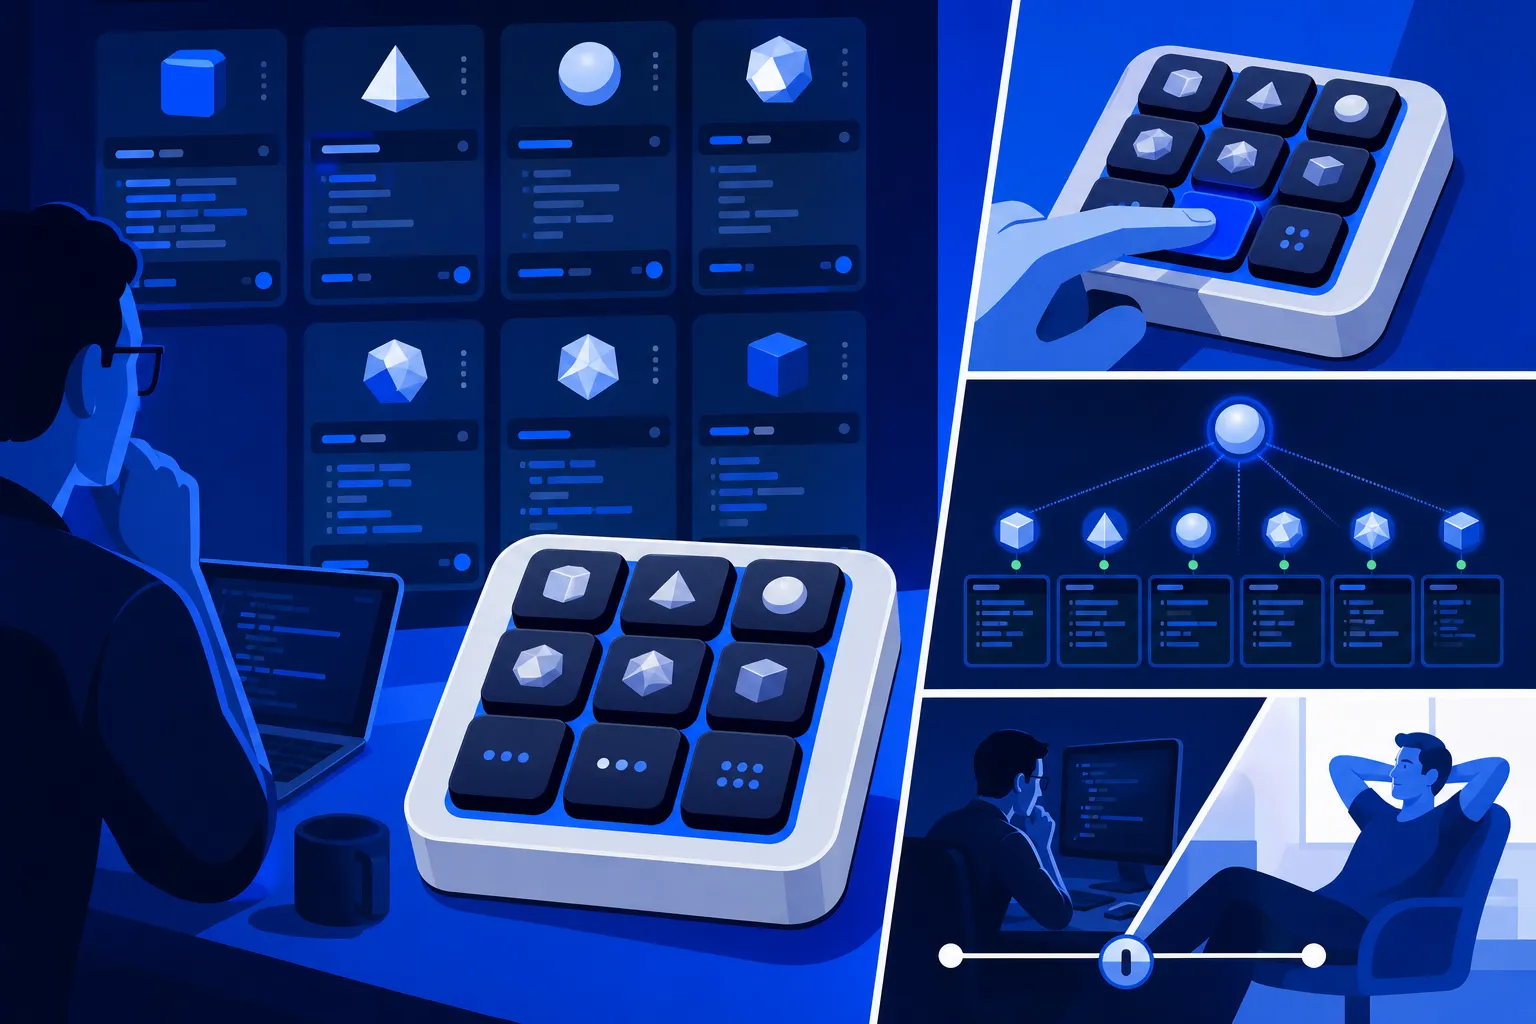
OpenAI sprzedaje klawiaturkę za 230 dolarów, żeby doglądać agentów
4 min
OpenAI wypuściło swój pierwszy sprzęt z własnym logo i nie jest to zapowiadany głośnik Jony'ego Ive'a, tylko Codex Micro, podświetlana klawiaturka za 230 dolarów zrobiona z Work Louder. Sześć kolorowych klawiszy pokazuje na żywo, na jakim etapie jest każdy agent Codexa, do tego dochodzi pokrętło do regulacji poziomu myślenia i joystick do gotowych scenariuszy. Całą konstrukcję trzyma teza, że praca programisty przestała polegać na pisaniu kodu, a zaczęła na doglądaniu floty agentów. Te same skróty odtworzysz jednak na Stream Decku za ułamek ceny.
Open Interpreter obstawia, że o wyniku taniego modelu decyduje rusztowanie, nie wagi
3 min
Open Interpreter, przepisany w Ruście fork Codexa od OpenAI, stawia jedną tezę: o wyniku taniego modelu decyduje w dużej mierze rusztowanie wokół niego, a nie same wagi. Poleceniem /harness ubierasz model w otoczenie pożyczone od Claude Code, Qwena czy DeepSeeka, w nadziei, że tani model zbliży się do drogiego zestawu, a sesja agenta spadnie z kilkudziesięciu centów do groszy. Problem w tym, że repozytorium z 60 tysiącami gwiazdek pokazuje tezę bez ani jednej liczby, bez wyniku na SWE-Bench i bez porównania tego samego modelu w różnych rusztowaniach.
Git, sandbox i dane ze stron: trzy premiery, których prawdziwym użytkownikiem jest maszyna
3 min
Na berlińskim WeAreDevelopers World Congress padły trzy premiery, które łączy jedno: narzędzia dla programistów projektuje się dziś pod agenta AI, nie pod człowieka. Thomas Dohmke, były szef GitHuba, wrócił ze startupem Entire, rozproszoną siecią Git trzymającą lustrzane kopie repozytoriów blisko agentów; Google pokazał Cloud Run sandboxes do bezpiecznego odpalania kodu, któremu nie można ufać; a Bright Data wypuściło Scraper Studio, które zwraca agentom czysty Markdown zamiast surowego HTML-a. Dwie z nich są dopiero w wersji zapoznawczej.
Warp wpina recenzję kodu agenta w terminal, jeszcze przed commitem
3 min
Warp, terminal z wbudowanym agentem, dodał panel Code Review, w którym przeglądasz każdą zmianę agenta lokalnie, jeszcze przed commitem. Uwagi przypinasz do konkretnego pliku i linii, a Warp zbiera je wszystkie i wysyła agentowi naraz, który nanosi poprawki w jednym przebiegu i oddaje zaktualizowany diff. Możesz cofnąć pojedynczy fragment zmiany albo przełączyć widok na różnicę względem main, a panel działa z dowolnym agentem CLI, od Claude Code po agenta Warpa. Sedno jest takie, że narzędzie robi z przeglądu rzecz znośną, ale samego czytania kodu z nikogo nie zdejmuje.
Dlaczego żaden model nie przekracza 25% na nowym benchmarku Scale?
3 min
Na nowym benchmarku SWE-Bench Pro od Scale Labs żaden model nie przekroczył 25 procent, a najlepszy GPT-5 rozwiązał tylko 23,3 procent zadań. Sekret tkwi w konstrukcji: 1865 zadań z 41 wciąż utrzymywanych repozytoriów, w tym z ukrytej i komercyjnej puli, której modele nie mogły zapamiętać podczas trenowania, gdzie pojedyncze zgłoszenie zajmuje inżynierowi kilka godzin lub dni. Agent radzi sobie z jedną funkcją, ale w cudzym, dużym projekcie gubi kontekst, więc lepiej samemu pokroić robotę na małe kawałki. Liczbę podaje firma, która sprzedaje ewaluacje, ale sygnał się trzyma.
GitLab 19.2 wysyła agenty tam, gdzie zrobiło się wąskie gardło: do przeglądu i bezpieczeństwa
4 min
GitLab 19.2, wydany 16 lipca, przyjmuje diagnozę Manava Khurany, że agenty kodujące przesunęły wąskie gardło z pisania kodu na przegląd i bezpieczeństwo, i odpowiada na to kolejnymi agentami. Dependency Scanning Auto-Remediation sam otwiera merge requesta z poprawką podatnej zależności i iteruje, aż kompilacja przestanie się psuć, a Security Review Flow rozumuje o błędach w logice, których skanery wzorców nie wychwycą. Ostatnie słowo ma człowiek, tyle że im więcej pracy wpada do jego kolejki, tym łatwiej klika odruchowo „zatwierdź" i sam staje się nowym wąskim gardłem.
Not Diamond trenuje router między modelami na twoich danych z ewaluacji
3 min
Not Diamond to framework, który zamiast ręcznie pisanych reguł sam uczy się kierować każde zapytanie do najlepszego z kilku modeli. Podajesz plik CSV z zapytaniami, odpowiedziami modeli kandydujących i własnymi ocenami tych odpowiedzi, wołasz train_custom_router i dostajesz identyfikator, którego select_model używa potem przy każdym prompcie. W przykładzie kandyduje pięć modeli, w tym GPT-5 i Claude Opus 4, a oceny pochodzą z HumanEval. Sednem są własne dane, ale to ich zebranie jest najdroższą częścią, a obietnica, że router pobije każdy model, to deklaracja producenta bez liczb.
Czy wyszukiwarka dla agentów bije zwykłe API? Google daje ją klientom, dowodów na razie brak.
4 min
16 lipca Parallel Web Systems, startup byłego szefa Twittera Paraga Agrawala, wpiął swoją wyszukiwarkę wprost do Gemini Enterprise Agent Platform, dzięki czemu przy składaniu agenta wybiera się ją jednym kliknięciem, a zużycie ląduje na tej samej fakturze Google Cloud co model i reszta. Cała przewaga leży w wygodzie: jedna konsola i jeden rachunek zamiast sklejania wyszukiwania, modelu i płatności od trzech dostawców. Że wyszukiwarka dostrojona pod modele jest realnie lepsza od zwykłego API, dowodów brak, bo nie ma ani liczb, ani porównań z konkurencją, choćby z Exą.
Cursor dokłada boczne czaty i wyszukiwarkę, bo w sesji z agentem łatwo się zgubić
3 min
Najnowsza aktualizacja Cursora dokłada trzy rzeczy: boczne czaty (komenda /side lub /btw) biegnące obok głównej rozmowy z agentem, wyszukiwarkę po treści wcześniejszych rozmów opartą na lokalnym indeksie oraz hooki, które w agentach chmurowych sięgają teraz samego toku rozumowania modelu. Wspólny wątek jest jeden: sesje z agentem spuchły tak, że człowiek gubi się we własnej pracy. Boczne czaty i wyszukiwarka łatają tę złożoność, ale najwięcej wart jest ostatni kawałek, bo tylko hooki dają realnie nową możliwość, choćby pętlę samokorygującą wokół odpowiedzi agenta.
Silnik w jednym pliku C uruchamia 744-miliardowy model bez GPU
3 min
Colibrì, jednoosobowy projekt open-source w jednym pliku C, uruchamia GLM-5.2 z 744 miliardami parametrów na zwykłym laptopie z 25 GB RAM, bez karty graficznej. Dzięki mieszance ekspertów silnik trzyma gęsty rdzeń w pamięci, a wyspecjalizowanych ekspertów podczytuje z dysku dopiero na żądanie. Ceną jest prędkość: od 0,05 do 0,1 tokena na sekundę na skromnym sprzęcie, choć na MacBooku M5 Max dochodzi do około 1 tokena. Pierwszy pomiar na skwantyzowanych do czterech bitów wagach dał 62,5%, a całość pokazuje, że sprzętowa ściana wokół modeli klasy frontier to kwestia inżynierii, nie prawo fizyki.
Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć
4 min
mind, jednoplikowe narzędzie Da7-Tech, próbuje dać agentom do kodu pamięć między sesjami bez embeddingów, bazy wektorowej czy zapytań do LLM: opiera się na wyszukiwaniu leksykalnym, grafie pojęć i ręcznym słowniku 83 mapowań, a nieużywane fakty gasną według krzywej Ebbinghausa. Autor podaje recall@1 równy 1,00 przy medianie 2,9 ms na grafie 1000 węzłów, choć sam przyznaje, że to tylko 20 zapytań na sztucznych danych. Największe pytanie nie dotyczy algorytmu, lecz tego, czy agent w ogóle zechce sięgnąć do pamięci wszytej w pliki CLAUDE.md i AGENTS.md.
Model / Badania · 6
Największy otwarty model świata jest już na szczycie, tylko nie uruchomisz go w domu
5 min
Chiński Moonshot AI wypuścił 16 lipca Kimi K3, który tego samego dnia stanął na szczycie Frontend Code Arena z wynikiem 1 679 punktów, 48 oczek przed Claude Fable 5. Z 2,8 biliona parametrów to największy model z otwartymi wagami w historii, ale nikt nie odpali go w domu: pełne wagi zajmą około 1,7 TB, a agresywna kompresja nie schodzi poniżej 650 GB. Znaczenie i tak jest realne, bo otwarte wagi spłaszczają marże, dają wybór, gdzie liczyć, i uczą mniejsze modele przez destylację. Wagi, licencję i raport techniczny obiecano na 27 lipca.
Model, którego nikt nie nauczył oszczędzać własnego myślenia
4 min
Ring-Zero, praca zespołu InclusionAI z chińskiego Ant Group z 14 lipca, to pierwszy udokumentowany przypadek dociągnięcia trenowania zero RL, które pomija etap uczenia na ludzkich przykładach, aż do biliona parametrów bez rozsypania procesu. Model wykształcił przy tym pięć zachowań, których nikt nie zaprogramował i które ujawniają się dopiero w tej skali, w tym "context anxiety": sam zerka na resztki okna kontekstowego i skraca własne rozumowanie. Ring-2.5-1T-Zero notuje 84,2% na AIME 2026, ale wszystkie wyniki pochodzą od samego twórcy i nikt niezależny ich nie potwierdził.
Pierwszy model Miry Murati nie wygrywa benchmarków. I dobrze.
4 min
Mira Murati pokazała Inkling, pierwszy model laboratorium Thinking Machines Lab, i od razu przyznała, że nie jest najmocniejszy. Wagi wyszły na czystej licencji Apache 2.0, a pod spodem działa mixture of experts z 975 mld parametrów, z których na token pracuje tylko 41 mld, z oknem kontekstowym do miliona tokenów. Na SWE-Bench Verified dostaje 77,6%, powyżej amerykańskiego Nemotrona 3 Ultra, ale poniżej chińskich liderów DeepSeek V4 Pro i GLM 5.2. Sensem jest rzadki, naprawdę otwarty amerykański model dla zespołów gotowych dostroić go na własnym klastrze GPU z 2 TB pamięci.
Needle sprowadza wybór funkcji z chmury na urządzenie
3 min
Cactus-Compute wypuściło Needle, model z otwartymi wagami, który robi na urządzeniu jedno: z pytania użytkownika i listy funkcji wybiera, którą wywołać i z jakimi argumentami. Powstał przez destylację Gemini 3.1 do zaledwie 26 milionów parametrów, na architekturze enkoder-dekoder bez warstw feed-forward, dzięki czemu decyzja o wyborze narzędzia zostaje na telefonie i nic nie trafia do chmury. Karta modelu daje pełną przejrzystość i licencję MIT, ale ani jednej liczby o skuteczności, więc trafność sprawdzisz sam na własnym zestawie funkcji, dotrenowując model w 45 minut.
Model do RAG, który zmieści się na jednej karcie
3 min
NVIDIA wypuściła 16 lipca Nemotron-3-Embed-1B, model osadzeń do RAG, którego atutem nie jest jakość, tylko rozmiar: 1,14 miliarda parametrów mieści się na jednej karcie GPU, więc cały etap wyszukiwania po dokumentach można trzymać u siebie, razem z danymi. Wersja ściśnięta do 4 bitów traci na benchmarku RTEB ledwie 0,38 punktu, a wektor da się obciąć z 2048 do 512 liczb, oszczędzając miejsce w bazie wektorowej. Wśród 34 przetestowanych języków nie ma jednak polskiego, więc jakość na polskich dokumentach trzeba sprawdzić samemu.
Nowy Kimi K2: podwojone okno kontekstu i skok na SWE-Bench
3 min
Moonshot AI wypuścił Kimi K2-Instruct-0905, aktualizację modelu z otwartymi wagami, który na SWE-Bench Verified podskoczył z 65,8% na 69,2%, praktycznie zrównując się z Qwen3-Coder i tracąc tylko trzy i pół punktu do Claude Sonnet 4. Ciekawszy jest Terminal-Bench, gdzie 44,5% Kimi wyprzedza zarówno Sonnet 4, jak i mocniejszego Opus 4, więc model z otwartymi wagami bije zamkniętą czołówkę na jej boisku. Okno kontekstowe podwojono ze 128 do 256 tysięcy tokenów. Lokalnie tego nie postawisz, więc realną drogą zostaje API zgodne z interfejsem OpenAI i Anthropica.
Poradnik / Praktyka · 2
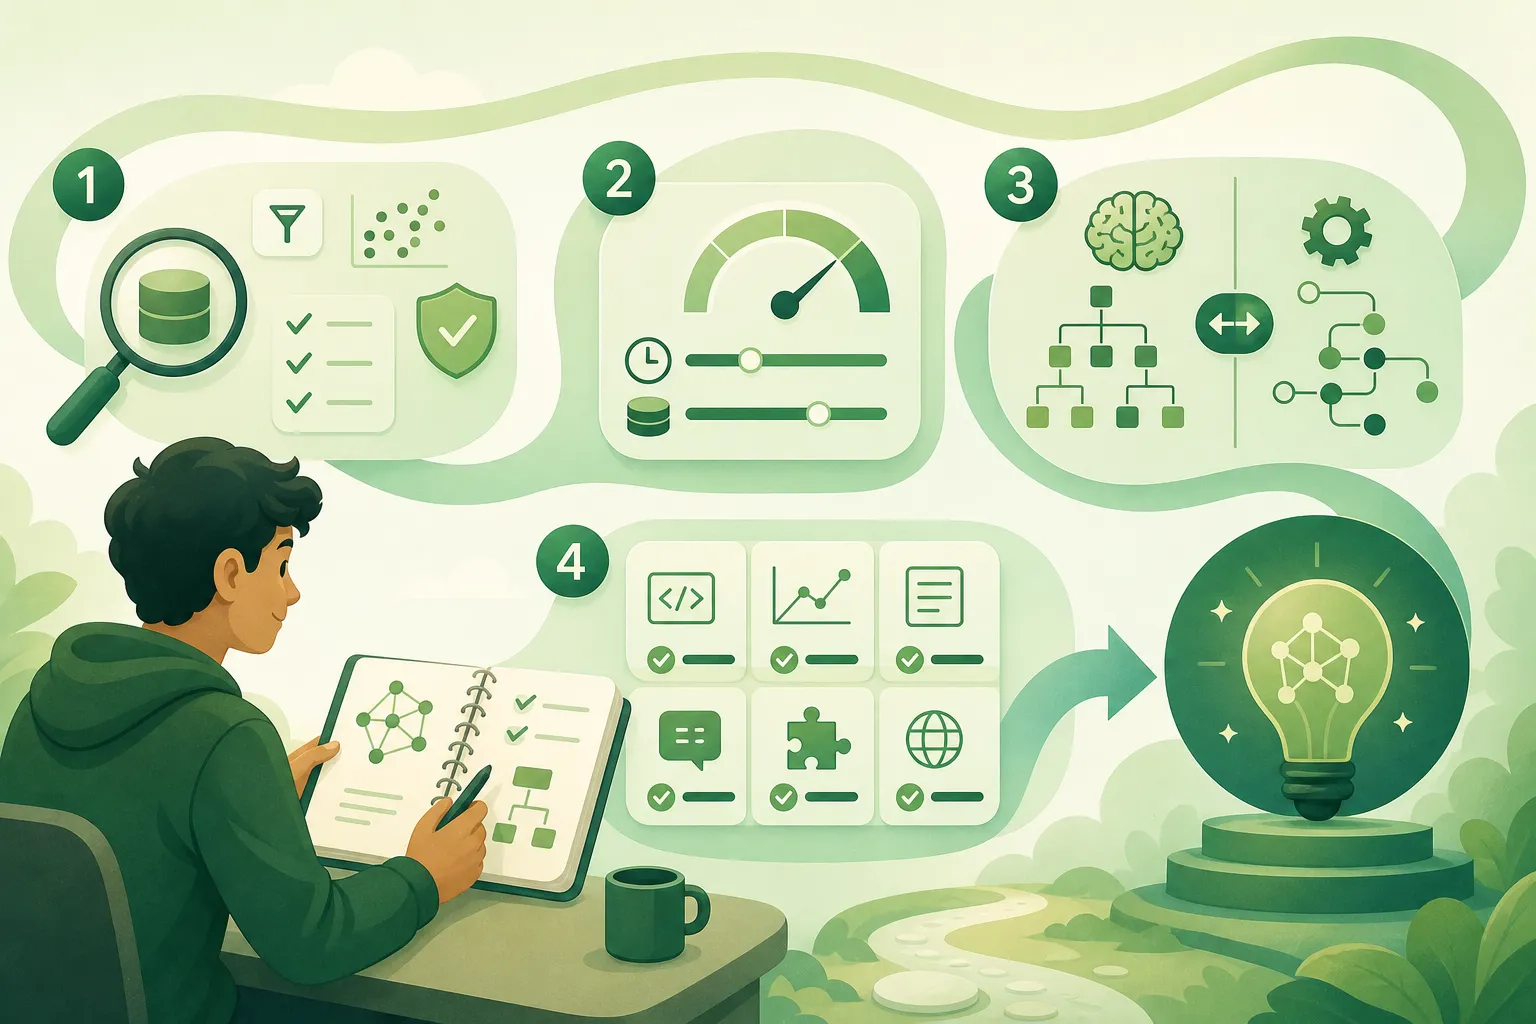
Co naprawdę poprawia rozumowanie modelu, gdy nie możesz sięgnąć po większy?
3 min
NVIDIA rozegrała na Kaggle konkurs, w którym ponad 5000 uczestników dostało ten sam model Nemotron-3-Nano-30B, mogło doszkalać tylko adapter LoRA i musiało zmieścić rozumowanie w sztywnym budżecie tokenów bez internetu. Z pięciu wniosków wraca jeden: model uczy się tak dobrze, jak dobrze da się sprawdzić każdy krok jego rozumowania, bo prawidłowa odpowiedź potrafi ukrywać zepsutą drogę, a jedna uśredniona liczba zamiata pod dywan słabości w konkretnych zadaniach. To podsumowanie NVIDIA, promujące jej model i karty Blackwell, ale kto dostraja własny model, dostaje gotową listę do sprawdzenia.
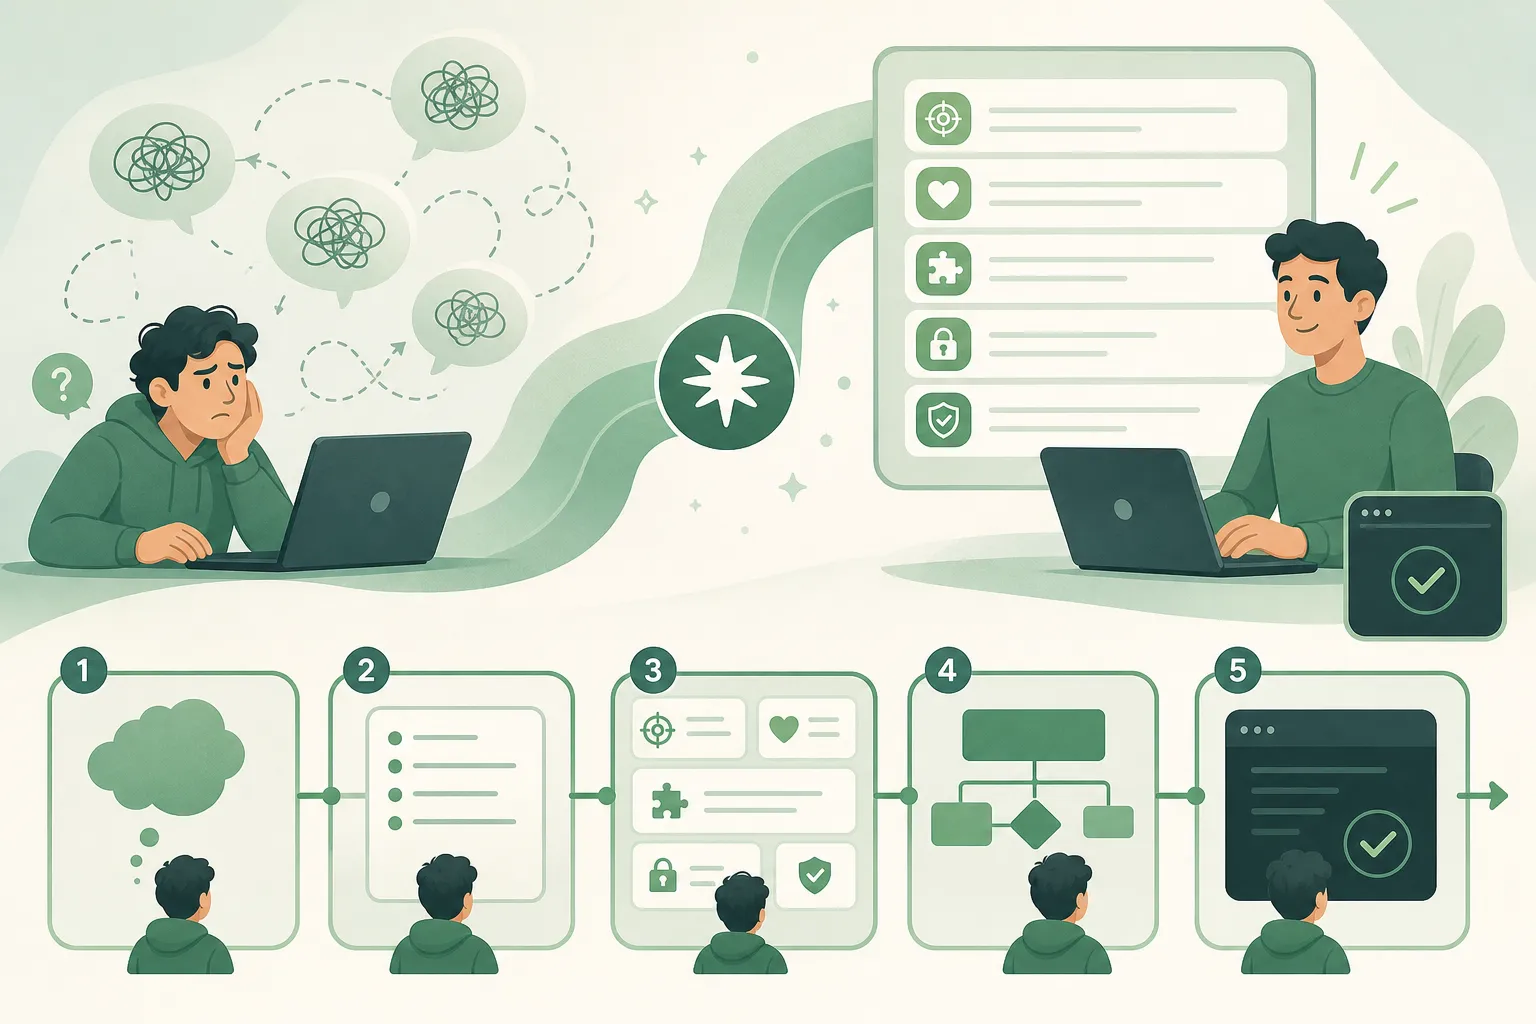
Najtrudniejsza linijka promptu to ta, w której mówisz, co znaczy gotowe
4 min
Komenda /goal w Claude Code odwraca pracę z modelem: zamiast sterować nim ruch po ruchu, podajesz metę i szablon z pięcioma polami, a model sam pracuje, aż dowiezie wynik albo wyczerpie limit tur. Najtrudniejsze jest pole VERIFICATION, bo trzeba w nim mierzalnie zapisać, co znaczy „gotowe”, inaczej model kończy za wcześnie albo kręci się w kółko. Sabrina przepuściła szablon przez sześć projektów, ale rada, żeby pracował godzinami, zderza się z ceną: drogi Claude Fable ma ścięty o połowę tygodniowy limit, więc rozsądniej puszczać go na planowanie, a pisanie kodu zostawić tańszemu Opusowi 4.8.