Programowanie AI
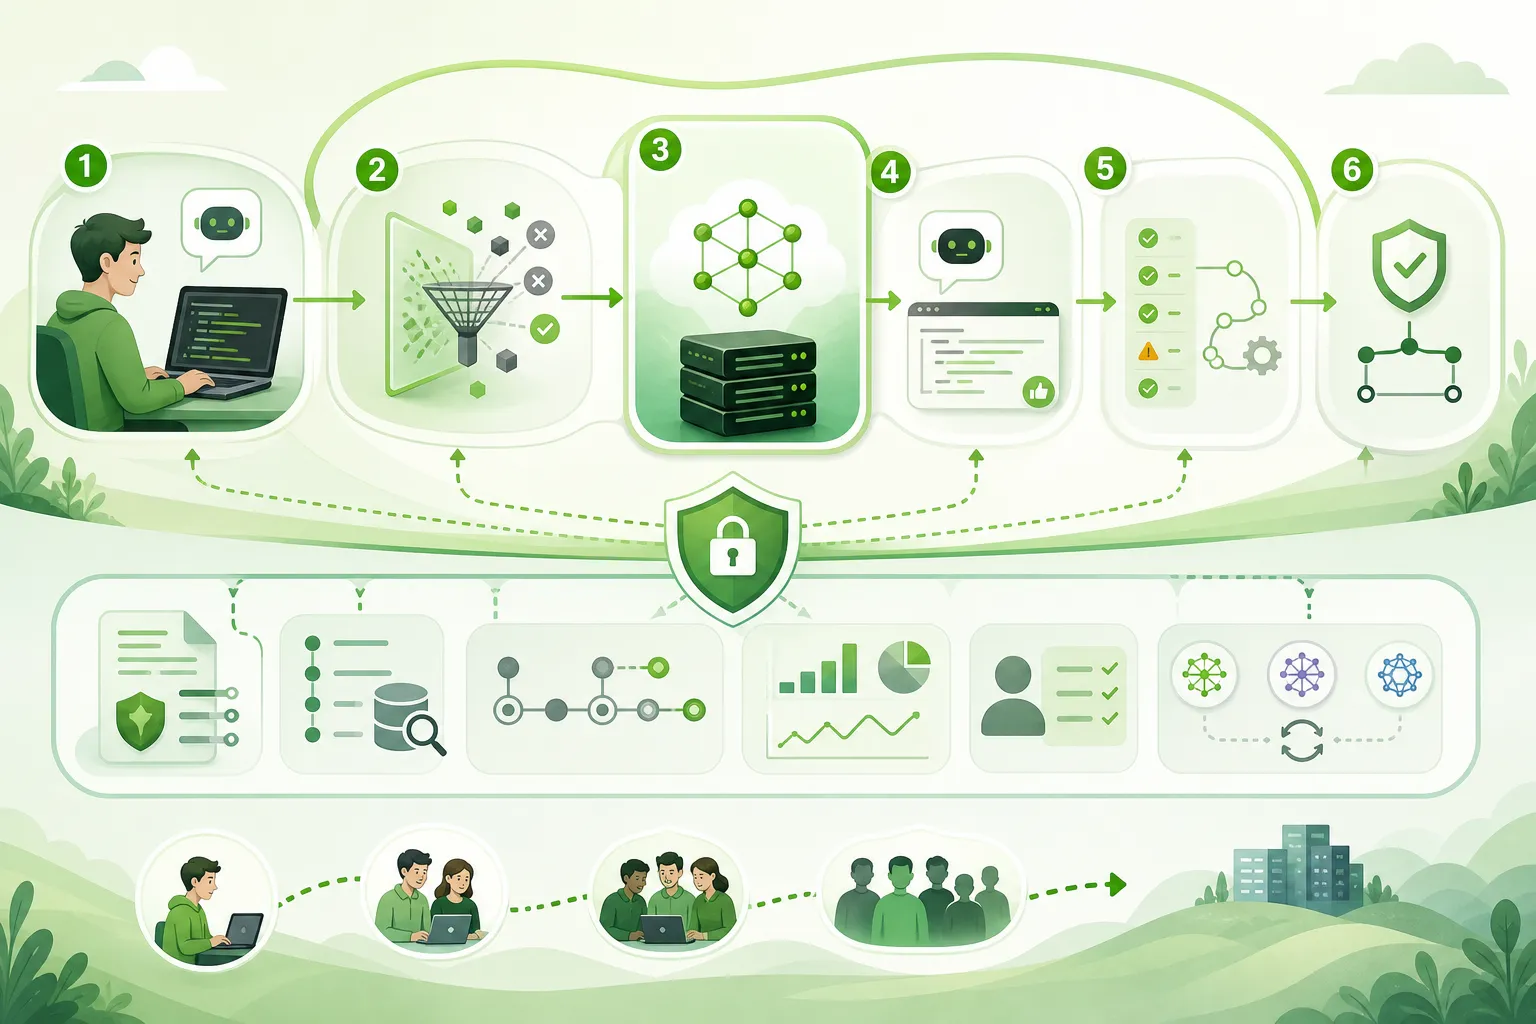
NVIDIA pokazuje, jak wpuścić asystenta AI do wrażliwego kodu, nie oddając mu kontroli
4 min
NVIDIA pokazuje, jak wpuścić asystenta AI do wrażliwego kodu, nie oddając mu kontroli: model tylko podpowiada, a pilnowanie zasad, skanowanie zależności i pomiar żyją poza nim, w systemach, którym zespoły już ufają. Na własnych kartach stoi StarCoder2 o 7 miliardach parametrów w kontenerze udającym API OpenAI, NeMo Guardrails odrzuca ryzykowne zapytania, a bramka w CI wyłapuje slopsquatting, czyli wymyślone przez model nazwy paczek. Zastrzeżenie jest poważne: to przepis, nie wynik, bez ani jednej liczby, a robotę nie tyle zdejmuje z zespołu, ile przesuwa na pisanie i utrzymanie reguł.
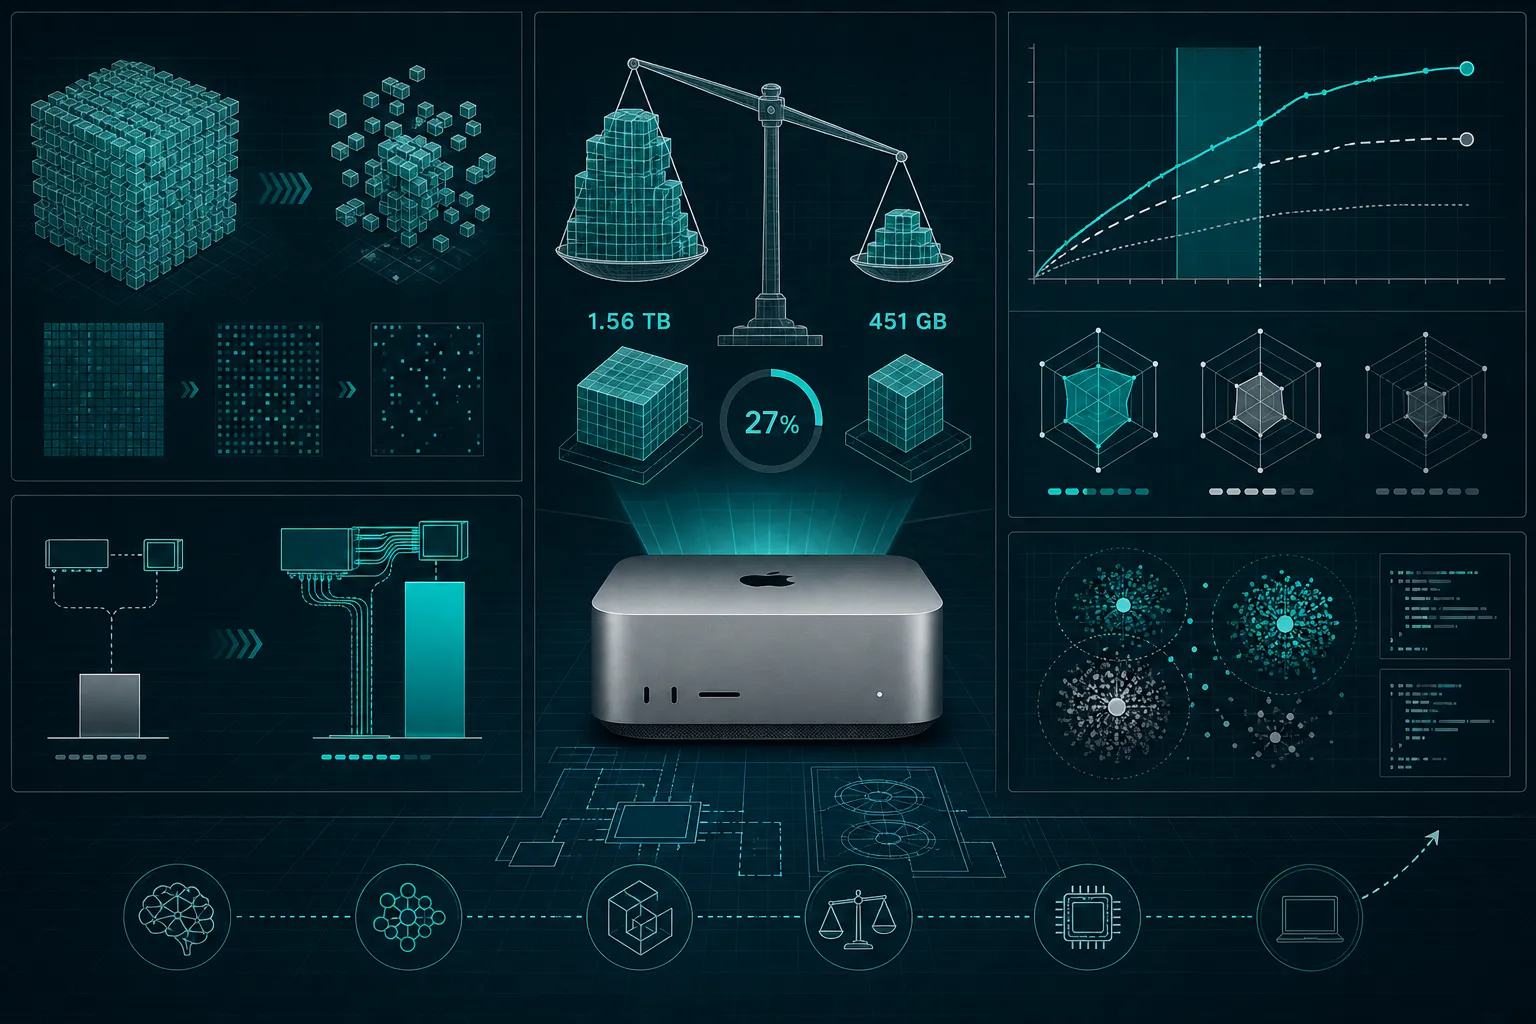
Kimi K3 na jednym Macu Studio zamiast 64 kart graficznych
3 min
Niezależny projekt PipeNetwork udostępnił wersję chińskiego modelu Kimi K3, która wchodzi na jeden Mac Studio: 451 GB zamiast 1,56 TB, ładowana w 62 sekundy. Sztuczka to metoda REAP od Cerebras, która wycina większość ekspertów mieszanki (z 896 do 242 na warstwę), oszczędzając akurat te od kodu, więc uzupełnianie kodu przechodzi cięcie niemal bez szwanku, choć model częściej gubi wątek. Najciekawsze nie jest jednak samo cięcie, tylko to, że autor złapał własny błąd pomiarowy zaniżający wydajność 39 razy (0,14 zamiast 5,51 tok/s) i publicznie go sprostował.
Laguna S 2.1 bije modele kilkanaście razy większe i pokazuje zapisy
3 min
Laguna S 2.1 od Poolside dostała 40,4% na benchmarku DeepSWE, cztery razy więcej niż kilkanaście razy większy DeepSeek V4 Pro Max, a firma opublikowała pełne zapisy każdej próby, żeby liczbę dało się sprawdzić samodzielnie. Model ma 118 miliardów parametrów, ale na każdy token uruchamia tylko około 8 miliardów, więc wywołanie przez API kosztuje 0,10 dolara za milion tokenów na wejściu, jakieś 50 razy mniej niż Claude Opus 5. To wąski specjalista wyłącznie od kodu, bez niezależnego wskaźnika ogólnej inteligencji, a wynik trzyma się tylko z włączonym trybem myślenia, bo bez niego spada do 16,5%.
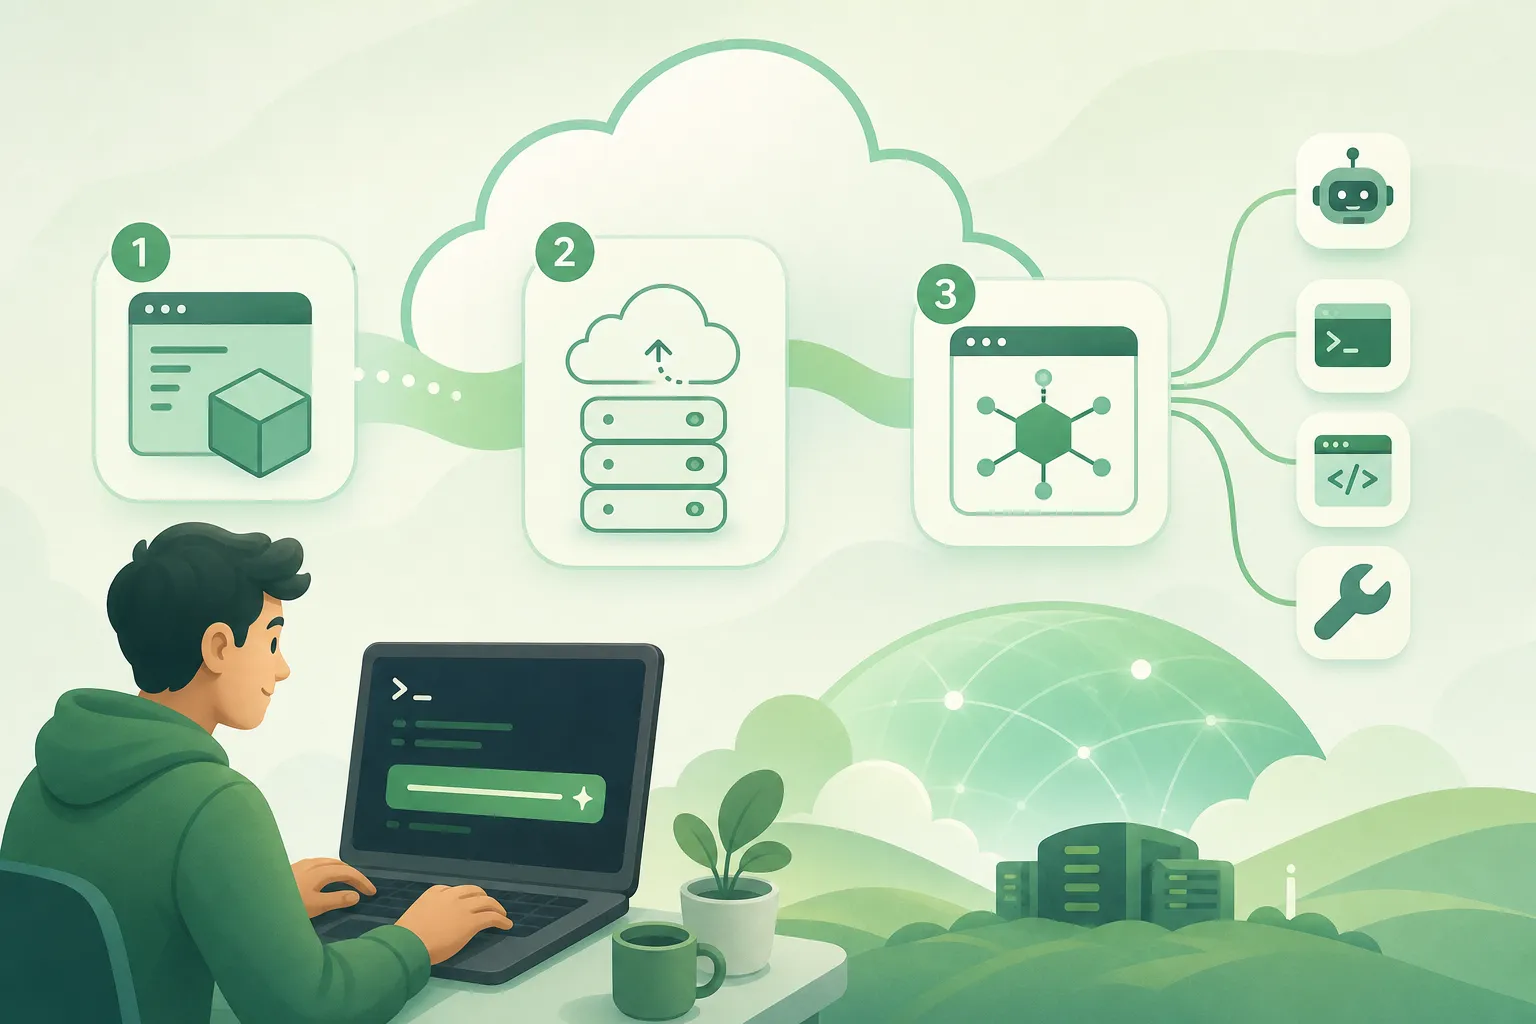
Trzy komendy dzielą pusty katalog od zdalnego serwera MCP
3 min
Dokumentacja Cloudflare Agents sprowadza postawienie zdalnego serwera MCP do trzech komend, tak że w kilkanaście minut pusty katalog zmienia się w narzędzie na workers.dev, którego używa prawdziwy agent. Wzorzec Code Mode idzie dalej: zamiast wystawiać każdy z ponad 2500 endpointów API Cloudflare jako osobne narzędzie, co zjadłoby modelowi ponad milion tokenów, serwer daje tylko search() i execute() i mieści się w około tysiącu. Tyle że bezobsługowy hosting działa wyłącznie na Cloudflare, a oszczędność bierze się z typowanego opisu ich API, więc własne narzędzia i tak piszesz ręcznie.
Milion tokenów i 90 wywołań na jedno zadanie: jak w ogóle zmierzyć takiego agenta?
4 min
AgencyBench, benchmark z ACL 2026, mierzy agenty na zadaniach zbliżonych do całodziennej pracy: 138 zleceń, w których rozwiązanie jednego wymaga średnio 90 wywołań narzędzi i około miliona tokenów. Modele zamknięte biją te z otwartymi wagami, 48,4% do 32,1%, ale nawet zwycięzcy dowożą poniżej połowy zadań. Ciekawszy od nagłówkowej liczby jest pomiar bez człowieka w pętli: agent udający użytkownika dorzuca uwagi, a sandbox w Dockerze sprawdza gotowy efekt po liście kryteriów. Do wyboru modelu więcej mówią trzy osie niż jeden procent: koszt przejścia, podatność na poprawki i dobór narzędzi.
Ręczny bufor promptu w GPT-5.6: kiedy naprawdę tnie rachunek?
4 min
GPT-5.6 trafił do ogólnej dostępności na Amazon Bedrock, a AWS dołożył ręczne sterowanie buforem promptu: sam wyznaczasz koniec powtarzalnego prefiksu, który potem czytasz z pamięci o 90% taniej przez 30 minut. Nowość ma drugą stronę, bo zapis do bufora, dotąd darmowy na GPT-5.5 i 5.4, kosztuje teraz 1,25 raza więcej niż zwykły token wejściowy, więc realnie oszczędzasz dopiero, gdy odczyty stanowią około 20% ruchu. To wygrana dla pętli agenta, gdzie ten sam prompt systemowy wraca dziesiątki razy, a przy pojedynczych zapytaniach najwięcej zyskujesz, zostając przy trybie automatycznym.
Bezpieczeństwa agenta nie da się napisać w promptcie
5 min
Zespół AI Red Team w NVIDII przez sześć miesięcy łamał agenty programistyczne i za każdym razem wracały te same cztery słabości: brak kontroli dostępu do samego agenta, narzędzia uruchamiające dowolny kod, otwarty ruch wychodzący i sekrety w zasięgu agenta otwartym tekstem. Ważniejszy od listy jest wniosek: bezpieczeństwa nie da się napisać w prompcie, bo strażnik pilnujący modelu jest tym samym rodzajem modelu, więc równie łatwo go zmanipulować socjotechniką albo powolnym gotowaniem żaby. Zostaje traktować model jak niezaufanego użytkownika i otoczyć go twardymi barierami poza promptem.
Greptile uczy swojego bota odpalać kod pull requesta, nie tylko go czytać
3 min
Greptile wypuściło w becie TREX, funkcję przeglądu kodu, która pull requesta nie tylko czyta, ale faktycznie odpala go w sandboksie i wyłapuje błędy widoczne dopiero przy uruchomieniu, jak wyścigi między żądaniami czy wycieki sekretów. Zamiast tekstowego ostrzeżenia zostawia dowód pod pull requestem, log z przebiegu albo nagranie klikania po interfejsie, czego trudniej zignorować niż zwykłą adnotację bota. Chwaloną liczbę, około 20% więcej złapanych błędów, Greptile podaje jednak bez opisu metody, więc sam pomysł kupuję, tej liczby nie, dopóki nie zobaczę jej na cudzym repozytorium.
Nowy benchmark Supabase pokazuje, czego agenty nie doczytują
4 min
Supabase 31 lipca udostępnił Evals, otwarty benchmark, który uruchamia agenty AI na żywej bazie i sprawdza, jak stawiają schemat i reguły bezpieczeństwa, a nie tylko czy piszą poprawny kod. Powód jest konkretny: ponad 60% nowych baz zakłada u firmy narzędzie AI, a nie człowiek. Najciekawsze okazały się nawyki agentów, czyli ręczne migracje mimo deklaratywnego schematu i rozjazd w czytaniu dokumentacji, gdzie Codex zaglądał średnio do ośmiu stron na scenariusz, a Claude Code do dwóch. Test projektuje jednak sam Supabase, który na każdym agencie zarabia, więc nie jest neutralny.
MiniMax sprzedaje już agenta, nie tylko tani model, ale dowodem są głównie dema
3 min
MiniMax wychodzi poza tani model i sprzedaje agenta pod hasłem "Code is cheap, show me the requirement", ale ogłoszenie to dobrane przez firmę dema, bez benchmarku i wyniku na SWE-Bench. Dla programisty konkretem jest natywna integracja z MCP, dzięki której agent sam sięga do GitHuba, GitLaba, Slacka czy Figmy zamiast ręcznego wklejania. Sam żongluje kilkoma modelami naraz, co, jak przyznaje firma, kosztuje i obniża wydajność, więc hasło o tanim kodzie na razie się nie broni. Jedyny twardy sygnał to fakt, że po niecałych 60 dniach stał się codziennym narzędziem ponad połowy zespołu MiniMaxa.
Kiedy naprawdę warto zbudować graf wiedzy zamiast zwykłego RAG-u?
3 min
GraphRAG od Microsoftu znów zbiera rozgłos i 35,1 tysiąca gwiazdek na GitHubie, ale to nie darmowe ulepszenie zwykłego RAG-u. Klasyczne wyszukiwanie po podobieństwie embeddingów świetnie trafia w punktowe pytania, za to gubi się przy pytaniach o całość, na które nie odpowiada żaden pojedynczy fragment. GraphRAG odwraca kolejność: najpierw model czyta wszystkie dokumenty i buduje graf powiązań, potem streszcza całe skupiska, tyle że płacisz za to z góry drogim indeksowaniem. Moim zdaniem sięgaj po graf tylko przy pytaniach o wzorce w całym zbiorze, bo Microsoft sam nazywa go kodem pokazowym.
JetBrains otwiera KotlinLLM: model dopisuje kod, który zostaje w repo jak każdy inny
3 min
JetBrains Research udostępnił na licencji Apache 2.0 KotlinLLM, wtyczkę do IntelliJ IDEA, która odwraca podejście do modeli w gotowej aplikacji: wywołanie asLlm model uzupełnia kodem Kotlina dopiero przy nieobsłużonej sytuacji, a poprawkę podmienia w locie przez JDI. Gotowy kod ląduje w repozytorium jak każdy inny plik, więc na produkcji modelu już nie ma, a wywołanie LLM staje się jednorazowym kosztem z etapu pisania. W testach 24 scenariusze przeszły po dopracowaniu, ale sam JetBrains studzi zapał: to prototyp badawczy, nie środowisko produkcyjne.
Cursor sam wybiera model do każdego zapytania i obiecuje 60% oszczędności
4 min
Cursor Router, uruchomiony w tym tygodniu, kieruje każde zapytanie do najtańszego modelu, który sobie z nim poradzi: rutyna trafia do tanich modeli, a trudne problemy do najdroższych. Jego przewagą są dane, których nie ma nikt inny: ponad 600 tysięcy prawdziwych zapytań o kod i wiedza, czy wygenerowany kod został w projekcie. Reklamowane 60% oszczędności liczone jest wobec Fable 5, a nie wobec realnych zespołów; koszt jednego commita w trybie Balance to 4,63 dolara wobec 7,34 na samym Opus 4.8. Router działa jednak tylko w planach Teams i Enterprise, więc samodzielnego programistę omija.
Najdroższy model potrzebny tylko do planu, resztę zrobi tańszy
3 min
Cursor dał rojowi agentów 835 stron dokumentacji SQLite i kazał odtworzyć bazę w Rust bez kodu źródłowego, a efekt przeszedł 100% ukrytych testów. Prawdziwy wniosek leży jednak w rachunku: przy niemal identycznej jakości koszt rozjechał się od 1339 dolarów, gdy planował Opus 4.8, a wykonywał tani Composer 2.5, po 10 565 dolarów za GPT-5.5 grający obie role naraz. Sztuczka polega na tym, że najdroższy model tylko rozbija cel na jednoznaczne instrukcje, a tańszy je wykonuje, bo naprawdę mało momentów w dużym zadaniu wymaga najkosztowniejszej inteligencji.
Anthropic wypuścił Claude Opus 5, a migracja to głównie kasowanie instrukcji
3 min
Anthropic wypuścił w piątek 24 lipca Claude Opus 5, w tej samej cenie co Opus 4.8, a najważniejsza zmiana leży nie w specyfikacji, lecz w tym, że migracja promptów sprowadza się do kasowania zabezpieczeń dopisywanych dla słabszych modeli. Skoro model według producenta sam sprawdza swoją pracę, instrukcje typu "zweryfikuj wynik" czy rozbijanie roboty na podagentów zaczynają teraz szkodzić i przepalać tokeny. Parametr effort dostał pięć poziomów, powyżej high nie da się już wyłączyć myślenia, a przy myśleniu zgaszonym model potrafi wpisać wywołanie narzędzia jako tekst, zamiast je wykonać.
Poolside wypuszcza model do kodu, który mieści się na jednej maszynie
4 min
Poolside wypuściło Lagunę S 2.1, model do kodu z otwartymi wagami, który mimo 118 miliardów parametrów uruchamia na token tylko 8 miliardów i mieści się na jednej maszynie, a skwantyzowany schodzi do jakichś 40 GB. Na Terminal-Bench 2.1 dostał 70,2%, tyle co modele wielokrotnie od niego większe, ale na trudniejszym DeepSWE ma już 40,4%, daleko za Claude Fable 5 z 70%, i pod presją zaczyna zmyślać. Nie chodzi o to, że mały bije dużego, tylko że "dość dobry, żeby mieć go na własność" to już realna półka w agentowym kodowaniu.
Czy agent do kodu, który gada jak kolega, pisze lepszy kod?
3 min
Cognition, twórca autonomicznego agenta Devin, zapłaciło ponad 100 milionów dolarów za Poke, asystenta żyjącego w SMS-ach i iMessage. Oficjalnie kupuje osobowość, bo Poke jest proaktywny i miło się z nim rozmawia, ale sedno leży gdzie indziej: współzałożyciel Poke, Marvin von Hagen, widzi w nim warstwę rozdzielającą pracę na kilka równoległych sesji Devina i pamiętającą, co każda zdążyła zrobić. To odpowiedź na realny brak dzisiejszych agentów do kodu, które każdą sesję zaczynają z czystą kartą. Pełne połączenie z modelem SWE-1.7 ma jednak ruszyć dopiero w przyszłym roku.
LM Studio wypuszcza Bionic, lokalnego agenta, który nie oddaje twojego kodu w chmurę
3 min
LM Studio wypuściło 22 lipca Bionic, agenta, który pisze kod i składa dokumenty na tej samej lokalnej infrastrukturze co czat, więc kod nie wędruje na cudze serwery. Więcej niż sam agent waży cicha aktualizacja 0.4.20: dzięki LM Link ciężki model chodzi na mocnej stacji, a pracujesz na lżejszym laptopie, zespół może też wskazać jeden model serwowany w sieci firmy, zamiast trzymać osobną kopię u każdego dewelopera. Do najtrudniejszych zadań Bionic i tak sięga po GLM 5.2 czy DeepSeek V4 Pro w płatnej chmurze Secure Cloud, a na razie działa tylko na Windowsie i macOS.
Microsoft wypuszcza SkillOpt, narzędzie do trenowania promptów bez ruszania modelu
3 min
Microsoft wypuścił na GitHubie SkillOpt, narzędzie na licencji MIT, które nie dotyka modelu, tylko po kolei poprawia plik z instrukcjami wczytywany przez agenta na starcie zadania. Zmiany proponuje osobny model-optymalizator, ale żadna nie wchodzi do pliku, dopóki nie udowodni na odłożonym zbiorze zadań, że realnie podnosi wynik. Repozytorium chwali się rezultatem najlepszym lub na równi w 52 z 52 układów i ponad 23 punktami skuteczności na GPT-5.5. Wydanie 0.2.0 dokłada nocny silnik SkillOpt-Sleep, ale to część eksperymentalna, a liczb nikt spoza Microsoftu jeszcze nie potwierdził.
Czy narzędzie, które podważa własne wnioski, naprawdę ścina fałszywe alarmy?
3 min
Capital One udostępniło 16 lipca VulnHuntera, otwarty skaner podatności oparty na modelu Claude. Jego sercem jest silnik falsyfikacji: po znalezieniu luki narzędzie samo próbuje obalić własny wniosek, więc do programisty trafia tylko to, czego nie zdołało odrzucić, co ma ściąć zalew fałszywych alarmów. Zamiast tropić podejrzane wzorce w kodzie, idzie od punktów wejścia napastnika i sprawdza, czy naprawdę da się dojść do wrażliwego miejsca. Cała weryfikacja jest jednak wyłącznie wewnętrzna, bez jednej sprawdzalnej liczby, a do uruchomienia potrzeba płatnego Claude Opus 4.8 i Claude Code.
Google przyznaje, że przegrywa w kodowaniu, a zamiast flagowca wypuszcza tańszy model
4 min
Sundar Pichai na telekonferencji wynikowej przyznał, że Google wypada słabiej w kodowaniu i kodowaniu agentowym. Flagowy Gemini 3.5 Pro, planowany na czerwiec, wciąż się nie pojawił, bo jego wyniki w programowaniu rozczarowały. Zamiast niego Google wypuściło tańsze modele Flash, z Gemini 3.6 Flash na czele, który na benchmarku DeepSWE zużywa do 65% mniej tokenów i podniósł wynik z 37% do 49%. Prawdziwy problem to jednak nie harmonogram premier, tylko brak własnego narzędzia do kodu zbierającego dane o tym, jak ludzie realnie programują z modelem.
Otwarte modele kodują już jak zamknięte. Zatrzymuje je droga na produkcję.
4 min
Doroczny raport Mozilli o otwartym AI pokazuje, że różnica w jakości między najlepszymi otwartymi a zamkniętymi modelami skurczyła się średnio do 3,3%, a na samym kodowaniu modele się zrównały. Cała gra przenosi się teraz do harnessu, czyli warstwy dookoła modelu: na Terminal-Benchu te same wagi Anthropica dawały 79,8% z niezależnym harnessem i tylko 58% w firmowym Claude Code. Otwarte wagi tną też koszty, bo Stripe przeniósł 50 milionów dziennych wywołań na własną infrastrukturę i ściął rachunek o 73%.
Liquid AI powiększył słownik modelu po treningu, żeby przyspieszyć języki azjatyckie
3 min
Liquid AI pokazało, że słownik tokenizera w gotowym modelu można powiększyć już po treningu, w miejscu, zamiast trenować wszystko od zera. Nowy algorytm skleja dotychczasowe tokeny w większe i przywraca jakość dwuetapowym douczaniem. Powstały model LFM2.5-8B-A1B ma słownik 128 tysięcy tokenów i koduje tajski nawet czterokrotnie oszczędniej, a hindi i wietnamski około dwuipółkrotnie. Autorzy szacują, że tekst w tych językach powstaje od 2,2 do 3,7 raza szybciej, choć to wyliczenie, a nie stoper włączony na prawdziwym telefonie.
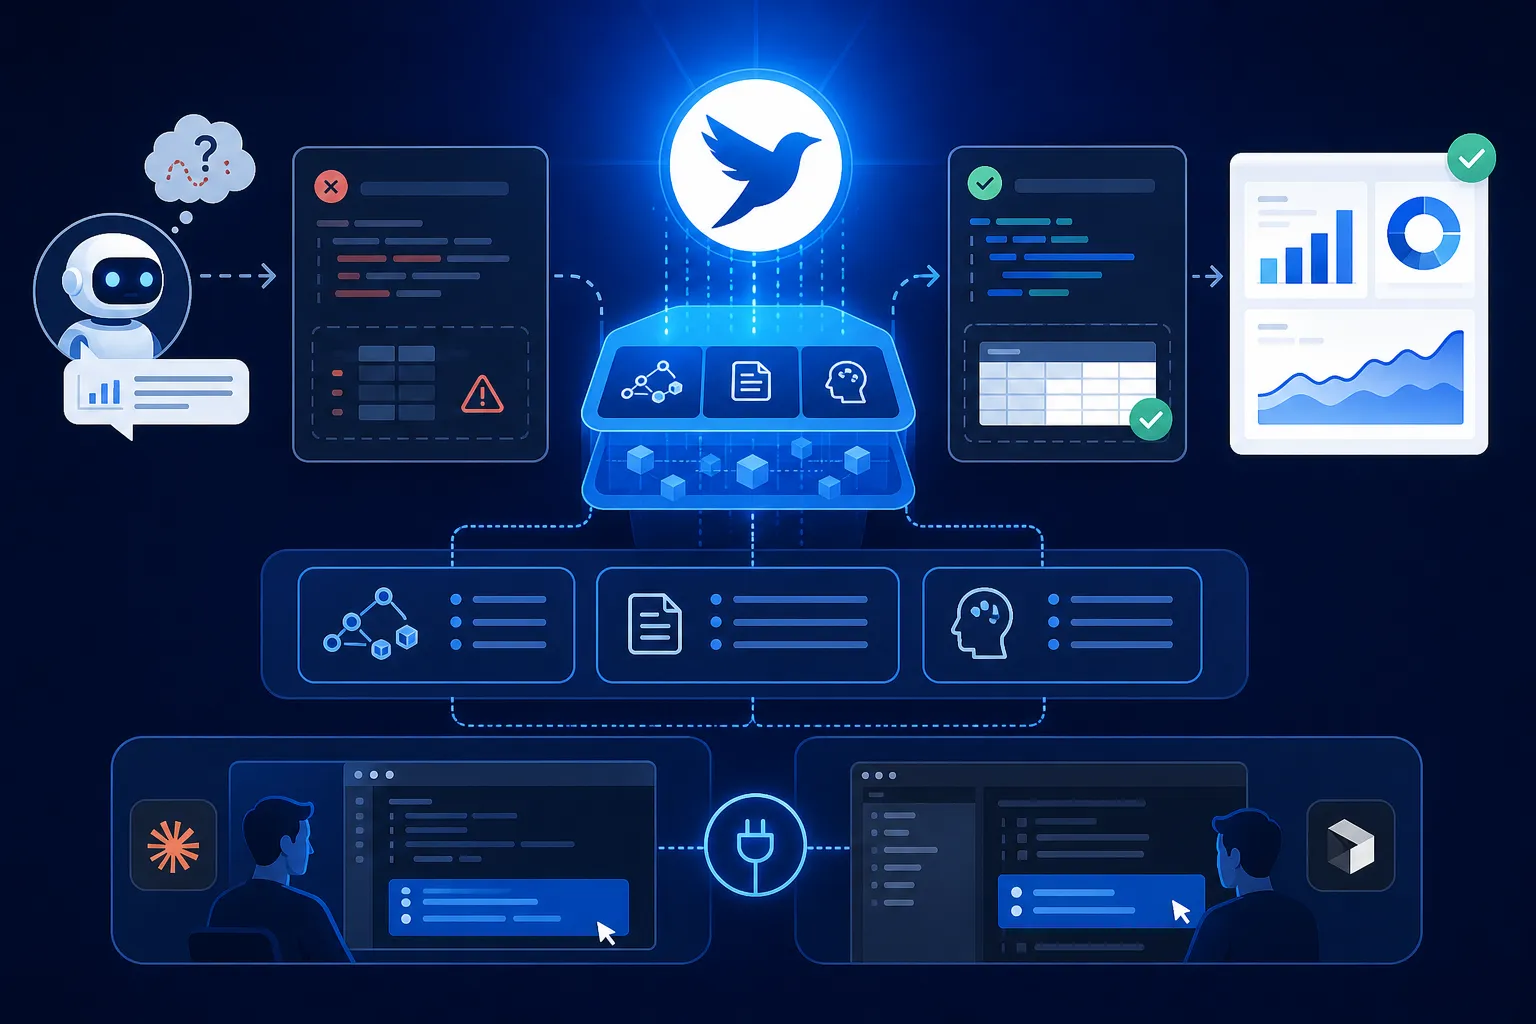
WrenAI każe spisać reguły firmy, zanim agent napisze SQL
4 min
Canner wypuścił na licencji Apache 2.0 otwarte narzędzie WrenAI, które generuje SQL z pytań zadanych po ludzku na ponad 20 źródłach danych, od Postgresa po Snowflake i BigQuery. Nowość nie leży w samej zamianie pytania na zapytanie, tylko w tym, że Wren każe wcześniej spisać reguły firmy w wersjonowanej warstwie kontekstu: model semantyczny w formacie MDL, definicje biznesowe i pamięć sprawdzonych zapytań. Doczepia się do agenta, jak Claude Code czy Cursor, jednym poleceniem npx. Wartość jest w nadzorze i zwraca się dopiero, gdy zespół zainwestuje w utrzymanie tego kontekstu.