Wydanie · Tydzień 34 · 17–23 sierpnia 2026
Archiwum wydań →Wąskim gardłem przestało być pisanie kodu, a stało się jego sprawdzanie. I to sprawdzanie trafia w ręce kolejnego modelu: sędzia wybiera najlepsze z pięciu podejść, agent sam generuje sobie dane testowe, a wiki cytuje własne streszczenia zamiast kodu.
Premiera / Narzędzie · 18
 Premiera / Narzędzie
Pięć podejść agenta, jeden sędzia i żadnych testów
4 min
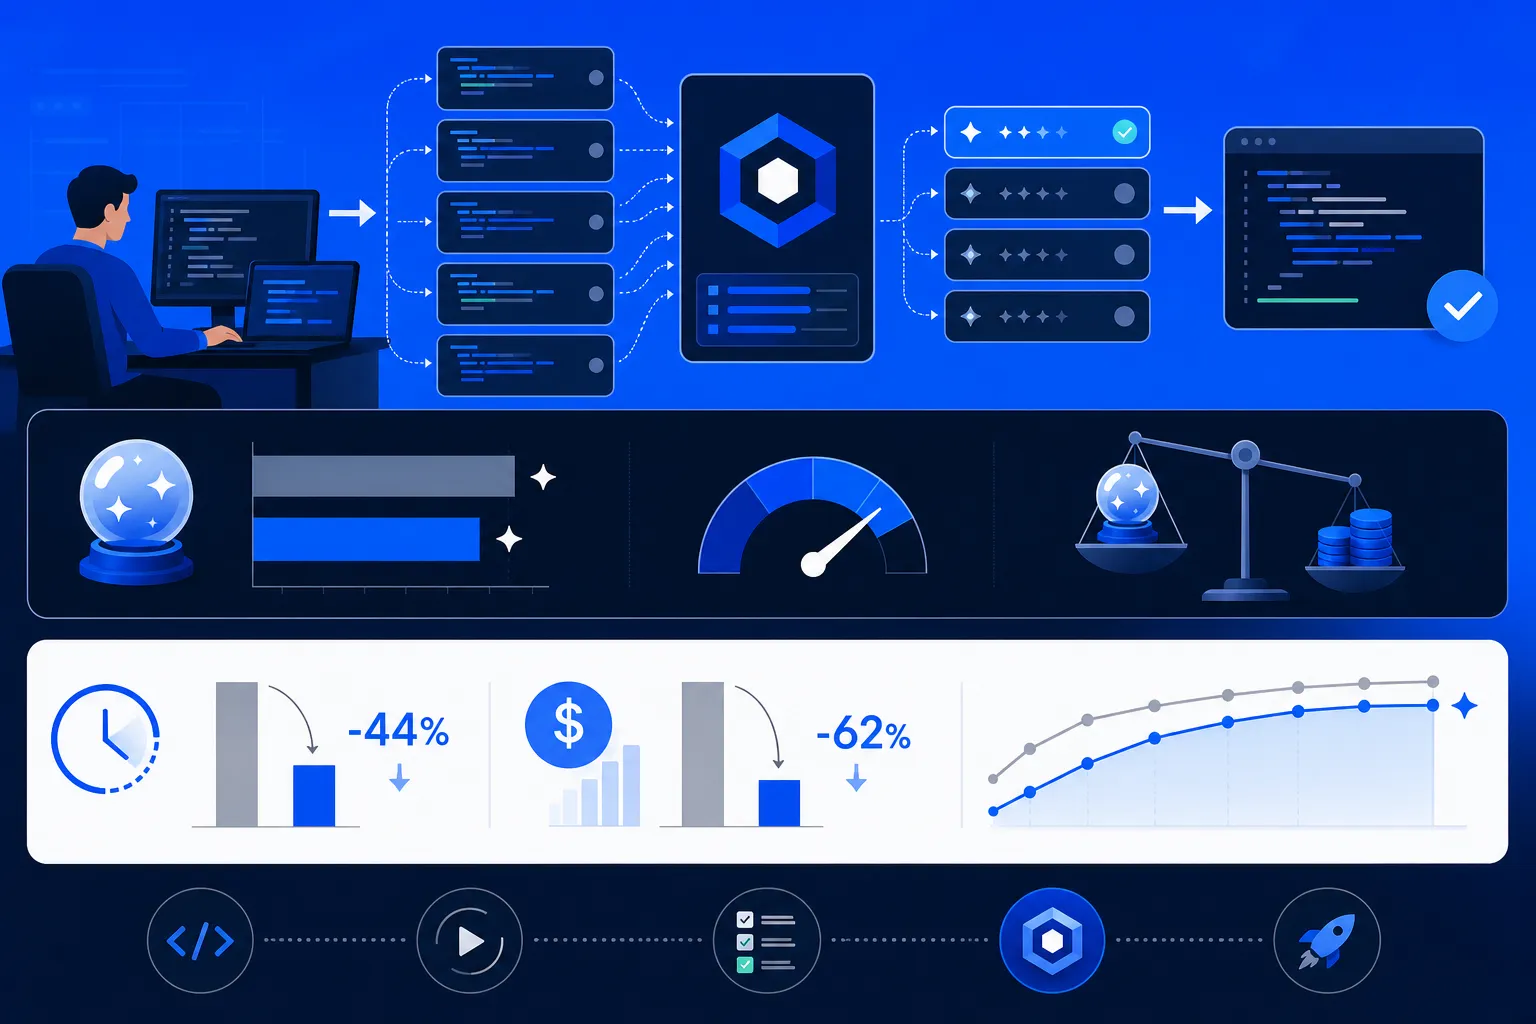
LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania i każe modelowi porównywać je parami, licząc przy tym nie samą notę, tylko pewność, z jaką model ją stawia. Na Terminal-Bench 2.1 model deepseek-v4-flash pojedynczym podejściem zaliczał 78,7% zadań, a wybór najlepszego z pięciu podniósł wynik do 88,0%, tyle że płaci się wtedy pięć razy zamiast raz. Ciekawszy jest drugi tryb, który ocenia jedno podejście krok po kroku, dzięki czemu beznadziejne da się przerwać po trzecim ruchu i ten rachunek raczej zbić niż napompować.
 Premiera / Narzędzie
Magnitude sam sprawdza, co uciągnie twój laptop, i pobiera pod to model
4 min
Magnitude, agent open-source z wbudowanymi modelami lokalnymi, instaluje się jedną komendą, prześwietla pamięć maszyny i sam pobiera dopasowany do niej model, więc odpada wieczór zgadywania, który wariant z Ollamy się zmieści. Umiejętności dokładasz z katalogu skills.sh prowadzonego przez Vercel, a dodatek agent-browser prowadzi twojego zalogowanego Chrome'a, dzięki czemu nic nie wychodzi na zewnątrz. Twórcy nie pokazują jednak ani jednego benchmarku, ani ukończonego zadania, więc obietnica działania na każdym sprzęcie dotyczy instalacji, nie jakości agenta.
 Premiera / Narzędzie
Co trzeci pull request w Cursorze otwiera agent, więc firma zbudowała mu repozytorium
5 min
Cursor wypuścił Origin, własną platformę do hostowania kodu, bo 35% pull requestów zmergeowanych w edytorze otwierają już agenty, a nie ludzie, przez co wąskim gardłem przestało być pisanie, a stał się przegląd. Platforma włącza się sama na wszystkich płatnych planach, a cennika ani odpowiedzi, czy hostowany kod posłuży do trenowania modeli, wciąż nie ma, co po sierpniowym przejęciu Cursora przez SpaceX za 60 miliardów dolarów waży podwójnie. Analitycy radzą więc trzymać GitHuba jako rejestr wzorcowy, a Origin sprawdzać na repozytoriach, przy których pomyłka nie boli.
 Premiera / Narzędzie
Jedno polecenie, dokument w markdownie, nic nie wychodzi z twojego dysku
4 min
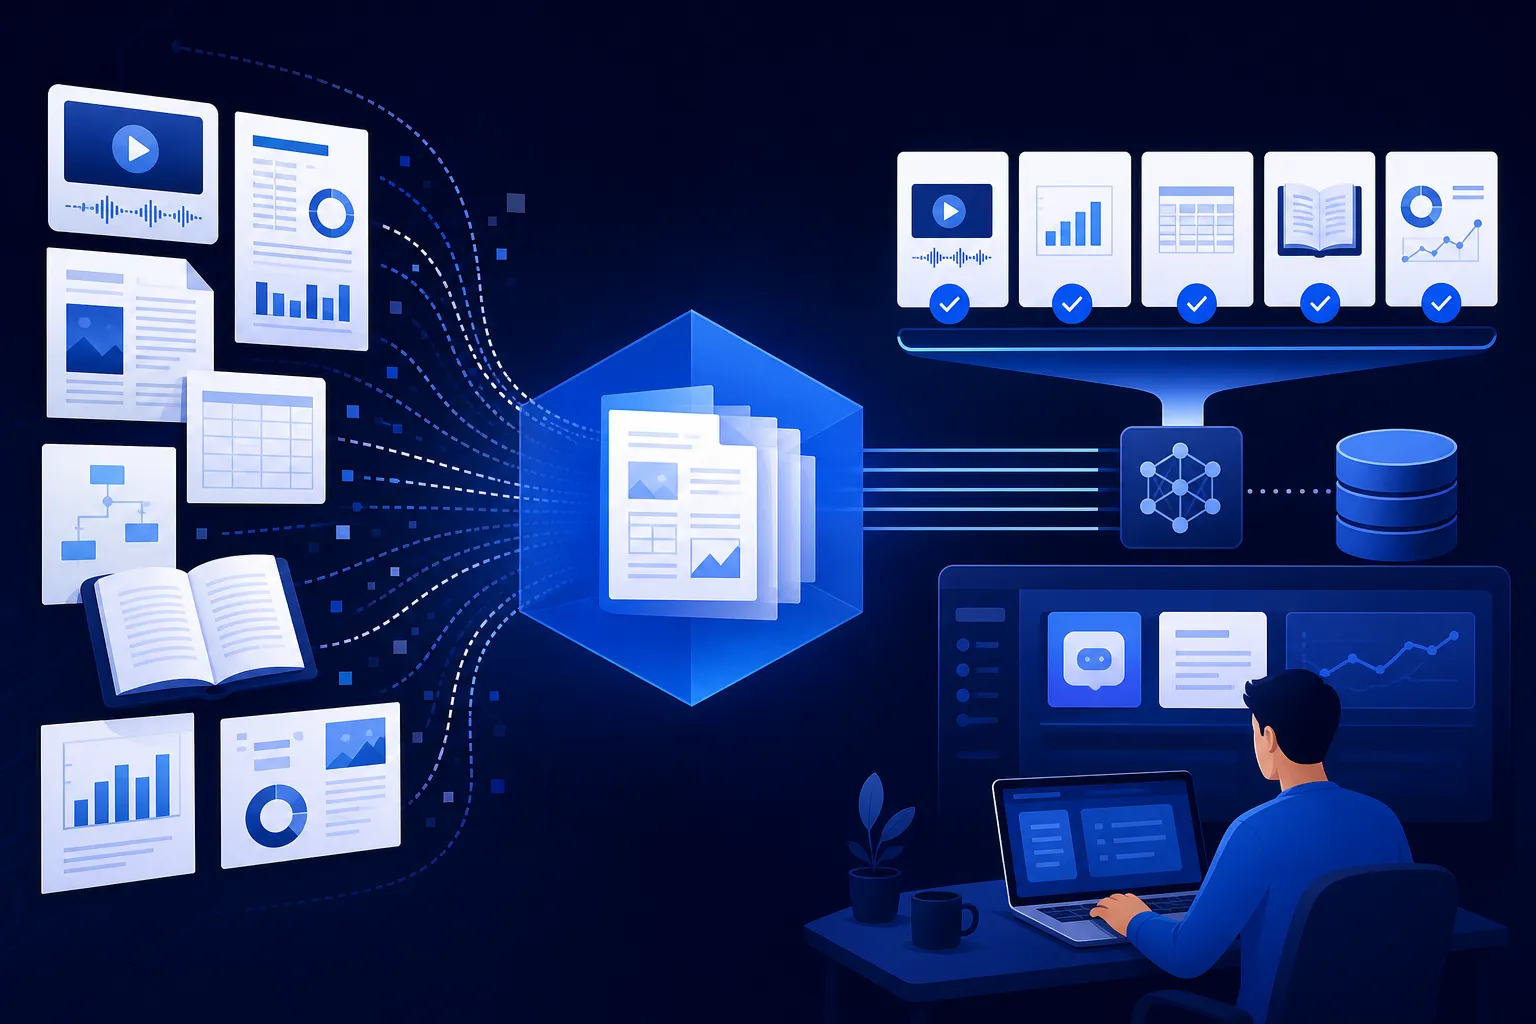
Docling, projekt z IBM Research w Zurychu, dziś pod fundacją LF AI & Data i na licencji MIT, jednym poleceniem zamienia PDF-y, skany, pliki poczty czy wideo w markdown gotowy dla modelu, a liczy to wszystko lokalnie. Najwięcej zmienia odczyt wykresów słupkowych, kołowych i liniowych, które na wyjściu stają się tabelą albo kodem, dzięki czemu model dostaje liczby zamiast podpisu pod obrazkiem. Przy trudnych układach stron pomaga GraniteDocling o 258 milionach parametrów, a konwersję można wystawić agentowi jako serwer MCP. Miar dokładności nie ma, więc trzeba to sprawdzić na własnych plikach.
 Premiera / Narzędzie
Cursor budzi agenty na zdarzenia i każe im trzymać cel do skutku
4 min
Sierpniowe wydanie Cursora wprowadza subskrypcje: agent w chmurze budzi się sam, gdy drgnie wątek na Slacku, pull request albo harmonogram, i prowadzi do końca pull requesty, które sam założył. Naprawia to, co wywala się w CI, a każdy subagent pracuje teraz na własnej maszynie wirtualnej i świeżej kopii projektu, więc agenty nie wchodzą sobie w pliki. Polecenie /goal pozwala opisać warunek końcowy i zostawić agenta przy zadaniu, aż ten cel osiągnie. Changelog nie podaje jednak ani jednej liczby, więc izolacja subagentów przekonuje mnie bardziej niż obietnica roboty bez nadzoru.
 Premiera / Narzędzie
Replit wyłączył licznik na drobne zadania, ale tylko abonentom
5 min
Replit od 19 sierpnia nie zdejmuje kredytów za zwykłe zadania agenta na planach Core i Pro, ale Free Mode działa tylko dla abonentów płacących 20 dolarów miesięcznie. Tryb dało się uruchomić dopiero po tym, jak OpenAI 30 lipca ścięło o 80% cenę modelu GPT-5.6 Luna, więc licznik nie zniknął, tylko schował się w limitach odnawianych co pięć godzin i w automacie, który sam przerzuca cięższe zadania na droższy model. Ważniejsza od samej funkcji jest reguła: tani model do rozmowy i drobnych zmian, drogi dopiero na trudny fragment.
 Premiera / Narzędzie
Pół miliona linii kodu, którym autor NanoClaw nie chciał zaufać
4 min
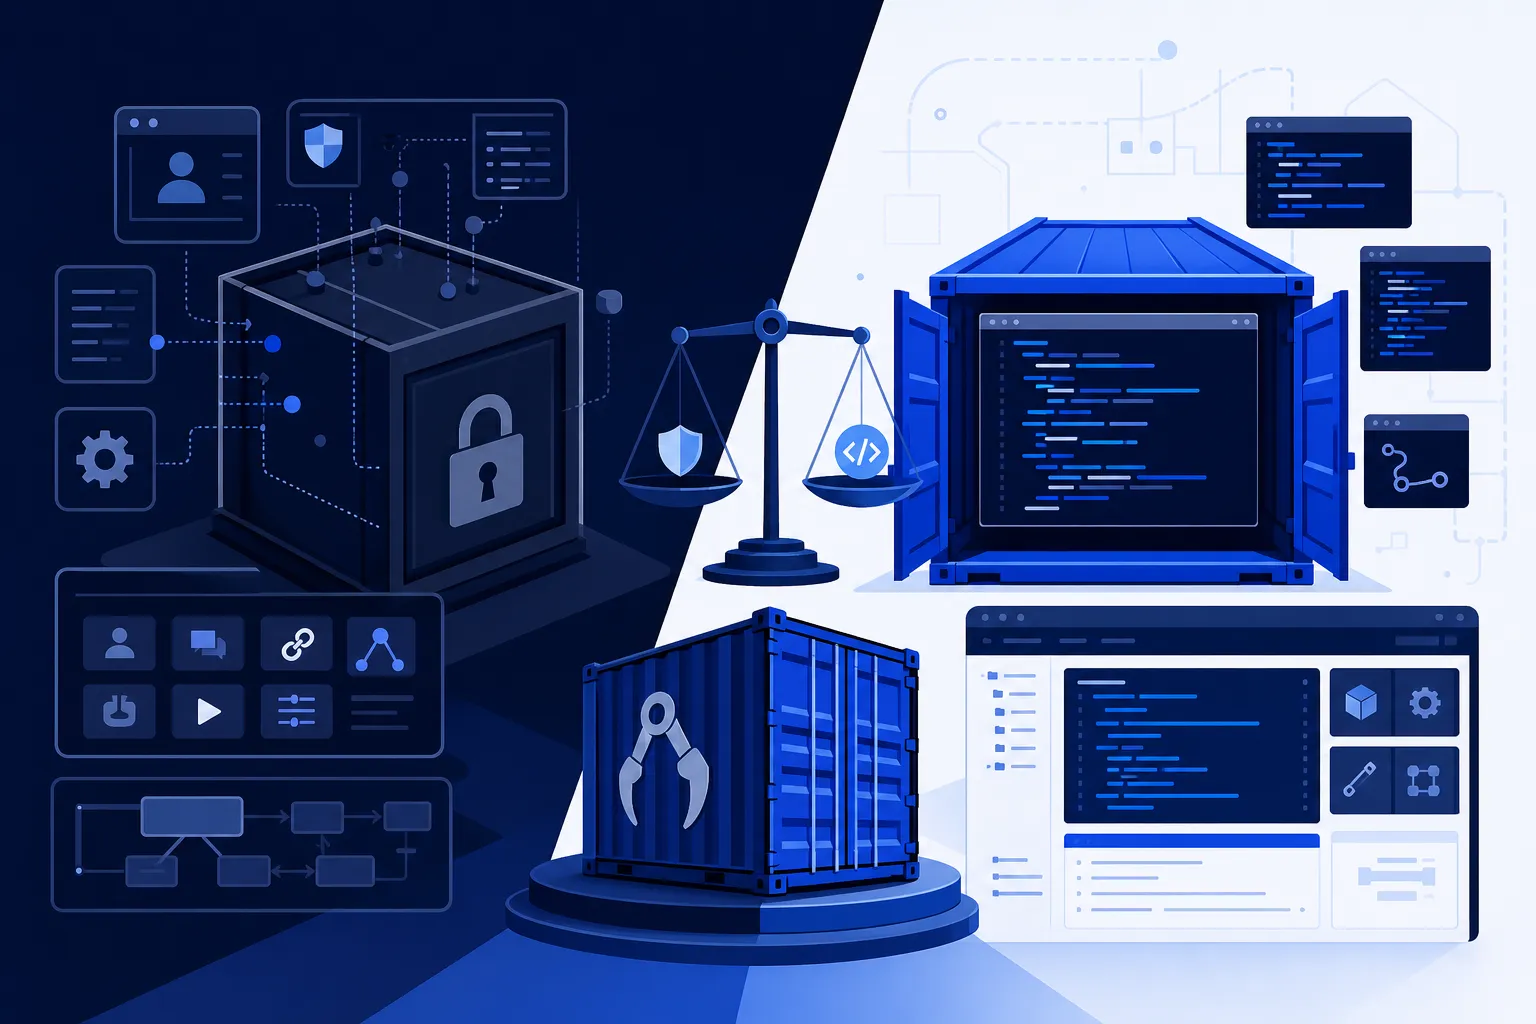
NanoClaw, wydany na licencji MIT, jest lżejszą odpowiedzią na OpenClaw, który ma pół miliona linii kodu w jednym procesie Node: każda sesja agenta startuje we własnym kontenerze i widzi wyłącznie podmontowane katalogi, a klucze API zostają na zewnątrz, bo ruch przechodzi przez Agent Vault z OneCLI. Adaptery do 13 kanałów leżą na osobnej gałęzi i dociągasz je poleceniem /add-telegram, dzięki czemu pień repozytorium zostaje chudy. Izolacja broni się sama, ale obietnica zrozumiałego kodu kuleje, bo mały pień to nie mała instalacja, a audyt rękami Claude Code przesuwa zaufanie o jedno miejsce.
 Premiera / Narzędzie
Brex wypuścił bramkę, która pyta model, czy agentowi wolno wysłać to żądanie
4 min
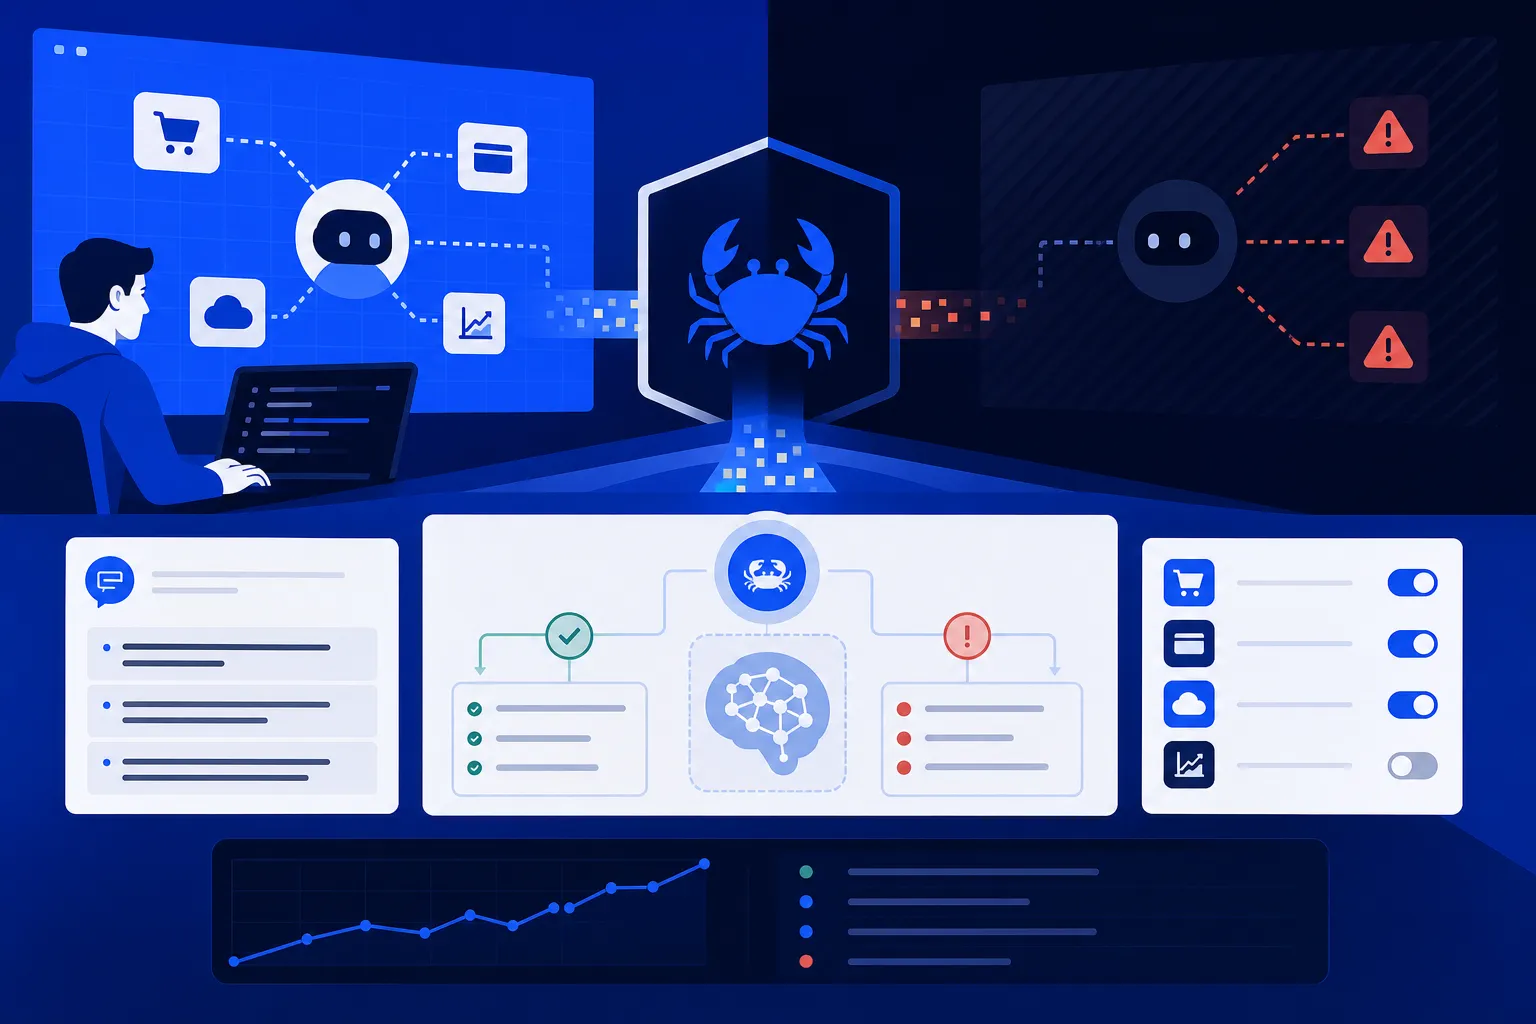
Brex wypuścił CrabTrapa, proxy na licencji MIT, które ustawiacie agentowi jako HTTP_PROXY i które sprawdza nie to, co model przeczytał, ale to, co próbuje wysłać na zewnątrz. Żądania nieobjęte żadną statyczną regułą trafiają do modelu-sędziego z polityką spisaną zwykłym językiem, a ten przepuszcza je albo odsyła 403. Odpowiedzi z zewnątrz wracają nietknięte, a bramka widzi nagłówki Authorization jawnym tekstem. Najwięcej wart jest więc rejestr w PostgreSQL-u: pokazuje, dokąd agent naprawdę dzwoni, i pozwala przetestować politykę na nagranym ruchu, zanim zaciśniecie ją na żywym agencie.
 Premiera / Narzędzie
Test przeszedł, bo agent sam wygenerował dane z tym samym błędem
5 min
W benchmarku NVIDII Claude Code napisał 45 skryptów do symulacji materiałów w pięciu wariantach promptu, a dłuższy prompt kupował głównie strukturę kodu, bo właściwy wzór agent dobierał już przy jednym zdaniu. Realną różnicę robiły dwie inne rzeczy: środowisko, w którym agent może odpalić własny kod, oraz jedno zdanie o fizyce, bez którego skrypty sięgały po termostat Langevina i zaniżały wynik od trzech do pięciu razy. Żadna konfiguracja ani razu nie zakwestionowała zadania bez fizycznego sensu, a 38 z 45 skryptów wybrało algorytm FIRE, bo tylko on stał w przykładach.
 Premiera / Narzędzie
DeepSeek oddaje za darmo przyrząd, na którym mierzył własnego flagowca
4 min
DeepSeek podaje, że model V4-Pro-0813 kończy 87,9 procent zadań w Terminal Bench 2.1, tyle że przy części testów agentowych pracował na własnym Harnessie, czyli warstwie, którą w połowie sierpnia oddał wszystkim na licencji MIT. Taki wynik ocenia parę, model i warstwę wokół niego, więc podpinając te same wagi pod swojego agenta, dostaniesz swoją własną liczbę. Za to razem z tabelką dostajesz stanowisko, na którym ona powstała, a model jest w nim wymienną wtyczką, więc sprawdzisz tam też Claude'a czy GPT. Ceną jest wczesna wersja, przy której DeepSeek zapowiada zmiany łamiące zgodność.
 Premiera / Narzędzie
Jedna zgoda OAuth otwiera agentowi także ustawienia projektu w Sanity
4 min
Serwer MCP Sanity daje agentowi 37 narzędzi, a jedna zgoda OAuth obejmuje je wszystkie naraz: obok edycji treści siedzą tam add_cors_origin, create_project i deploy_studio, więc model, który pogubił się w schemacie, ma czym dopisać obcą domenę do listy zaufanych. Po stronie treści przemyślano to lepiej, bo poprawki lądują w szkicu i wchodzą jedną transakcją, ale publikacja i kasowanie wersji roboczych to już pojedyncze wywołanie. Sam wpisałbym w konfiguracji osobny token API z węższą rolą niż własne konto i sprawdził, czy agent czyta ten schemat, na którym faktycznie pracuje.
 Premiera / Narzędzie
Harness decyduje o rachunku za agenta bardziej niż sam model
5 min
TrueFoundry wypuściło 19 sierpnia TrueForge, otwarty harness agentowy na licencji MIT, obiecując o połowę niższe koszty, choć takiej liczby nie ma w benchmarku opublikowanym razem z kodem. Na 14 zadaniach z Enterprise-Bench przy tym samym Opusie 4.8 TrueForge dorównał skutecznością Claude Managed Agents za 8,5 dolara na uruchomienie zamiast 11,8, bo przycina kontekst i zużył 4 miliony tokenów zamiast 10. Drugą oszczędność, do 2,9 dolara, zrobiła podmiana modelu na otwarty GLM-5.2, a nie sam harness, a obiecana kontrola kosztów i uprawnień działa dopiero przez komercyjny AI Gateway.
 Premiera / Narzędzie
OpenAI szuka nadużyć w waszych sesjach, nie zaglądając do treści
4 min
OpenAI ogłosiło 19 sierpnia Private Safety Processing: automat zestawia ze sobą powiązane sesje w API i wysyła do firmy samą etykietę ryzyka, bez ani jednego zdania z treści, więc zerowa retencja zaczyna znaczyć nie tyle "nic nie zostaje", co "nic nie zostaje dla ludzi". Anthropic poszedł w lipcu dokładnie odwrotnie i przy najmocniejszych modelach trzyma sesje przez 30 dni. Brak zapisu zamienia jednak problem dowodowy w problem zaufania, bo po fałszywym alarmie nie macie czym się wytłumaczyć, o ile sami nie prowadzicie własnego rejestru.
 Premiera / Narzędzie
Z 6% na 75% bez dotykania modelu: co AMD zmieniło w swoich agentach
4 min
AMD puściło agenty na zgłoszenia błędów z panelu sterowników Radeona w październiku 2025, domykały wtedy 6% z nich, a w czerwcu 2026 już ponad 75%, choć nikt po drodze nie tknął modelu. Zamiast dotrenowywać, zespół przestał tłumaczyć agentom, jak naprawić usterkę, i zaczął stawiać warunek końcowy, do którego drogę wybierają same, z prawem do kilku podejść i z pętlą wracających wniosków z nieudanych prób. Zgłoszenia z RSX są wąskie i powtarzalne, więc te 75% nic nie mówi o twoim repozytorium, ale sam mechanizm działa wszędzie tam, gdzie da się jasno zdefiniować kryterium sukcesu.
 Premiera / Narzędzie
BrowserCode wpuszcza agenta do twojej zalogowanej karty w Chrome
4 min
BrowserCode zespołu browser-use, wydany na licencji MIT, daje agentowi jeden prymityw browser_execute(code): pisze on własny JavaScript prosto w twojej zalogowanej karcie Chrome przez DevTools Protocol, zamiast uczyć się poleceń typu "kliknij element numer siedem". Pomysł jest trafiony, bo model widział miliony linii JavaScriptu i ani jednej funkcji click(index), ale zdjęta warstwa abstrakcji była jedynym miejscem, gdzie dało się postawić granicę. Zapewnienie z README o przewadze nad konkurencją stoi bez jednej liczby, a 15 405 commitów to w większości dorobek OpenCode, którego to fork.
 Premiera / Narzędzie
Claude robi teraz kilka ruchów na jedno wywołanie, zamiast pytać po każdym kliknięciu
4 min
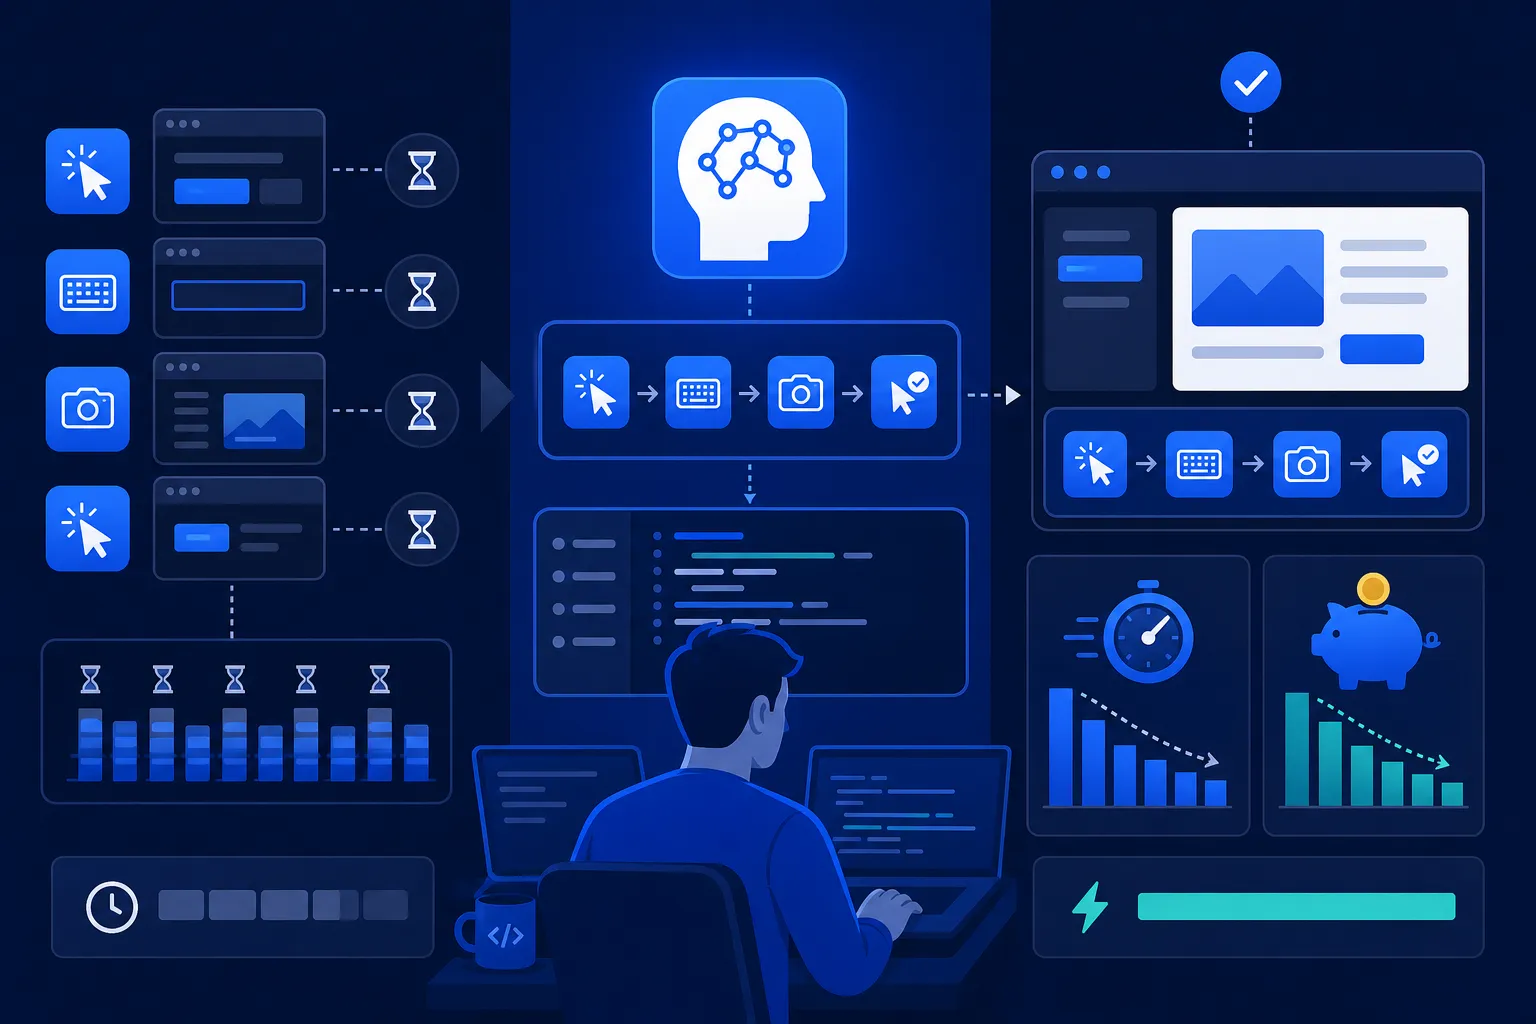
Anthropic wypuścił 21 sierpnia produkcyjne wersje obsługi komputera i narzędzia do przeglądarki, a nowy zestaw narzędzi pozwala modelowi wykonać kilka działań w jednej turze, zamiast prosić o zrzut ekranu po każdym kliknięciu. Klienci z wczesnego dostępu notują 20-40% mniej wywołań modelu, a David Mlcoch z Asteroid zbił koszt zadania o 25 do 32%. Ważniejsza wydaje mi się przeglądarka, która podaje modelowi strukturę strony, dzięki czemu automatyzacja nie sypie się po przebudowie układu. Każde wywołanie mniej to jednak jeden punkt kontrolny mniej tam, gdzie agent zatwierdza przelew.
 Premiera / Narzędzie
Slack wpuszcza agentów kodujących do wspólnego kanału, żeby zespół patrzył im na ręce
5 min
Slack Code, ogłoszony przez Salesforce 20 sierpnia, wpuszcza agentów kodujących pięciu dostawców, w tym Claude Code i Devina, do wspólnych kanałów, w których cały zespół widzi każdy krok i może agenta zawrócić, a on działa wyłącznie na uprawnieniach osoby, która go wezwała. Jawność ma być lekarstwem na słaby kod, tylko że dotyczy pisania, a nie sprawdzania. Cognition podaje dziesięciokrotny wzrost liczby zmergeowanych pull requestów przy wzroście zatrudnienia o 40%, a kontrola została w GitHubie i jest jej dokładnie tyle samo, co wcześniej.
 Premiera / Narzędzie
Agent do terminala, który ostrzega przed własnymi wtyczkami
4 min
OpenCode to agent open source odpalany jedną komendą w terminalu, który nie ma w środku własnego modelu, więc podłączasz dowolnego dostawcę i płacisz mu bezpośrednio za tokeny. Zamiast chwalić się długą listą integracji, dokumentacja otwiera stronę o MCP ostrzeżeniem: opisy narzędzi z każdego serwera jadą do modelu przy każdym zapytaniu, a ten od GitHuba potrafi rozsadzić okno kontekstowe. Tryb planu pod klawiszem Tab i komenda /undo trzymają agenta z dala od plików, dopóki plan się nie zgadza, choć w dokumentacji nie ma ani jednego wyniku benchmarku.
Model / Badania · 1
Bezpieczeństwo · 4
 Bezpieczeństwo
Dwa i pół roku danych zniknęło przez podmieniony plik stanu
4 min
Alexey Grigorev z DataTalks.Club przesiadł się na nowy komputer bez pliku stanu Terraform, więc gdy poprosił Claude Code o skasowanie duplikatów, agent rozpakował stare archiwum, podmienił ten plik i wziął działającą produkcję za swoje zasoby, po czym terraform destroy zabrał bazę RDS z dwuipółrocznym dorobkiem kursantów razem z nocnymi kopiami. Dane wróciły dobę później dzięki kopii, którą wsparcie AWS odnalazło poza panelem klienta. Nie zawiodło okienko z pytaniem o zgodę, bo destroy przepuścił człowiek, tylko plik decydujący o tym, czego ta komenda dotyczy.
 Bezpieczeństwo
Dwie linijki, jedna zatwierdzona komenda i klucz SSH wychodzi z komputera
6 min
Pillar Security opisało w Cursorze lukę CVE-2026-22708, w której dwie linijki wystarczą, żeby z komputera wyszedł prywatny klucz SSH: export PAGER przechodzi bez pytania, bo jest wbudowany w powłokę, a ręcznie zatwierdzone git branch posłusznie odpala podłożony ładunek. Atak działał nawet przy pustej liście dozwolonych komend, więc taka lista jest wygodą, a nie granicą bezpieczeństwa, i dopiero wersja 2.3 Cursora ją domknęła. Docker Sandboxes przycina zasięg szkód, ale katalog z kodem wciąż jest podpięty żywcem z hosta, więc pułapkę w skryptach gita można zostawić na potem.
 Bezpieczeństwo
Modele znajdują luki, których nie znalazł nikt, i same je zostawiają w kodzie
4 min
Modele wyłapują luki zero-day, których nikt wcześniej nie widział, a przy łataniu i pisaniu kodu potykają się o podstawy: 44% wygenerowanego kodu ma podatność z listy OWASP Top 10, a przez cztery pomiary rozłożone na rok średnia w ogóle nie drgnęła. W ponad 6000 przebiegów Off-By-1 Labs z 1Password tylko 26% łatek zamykało dziurę, nie psując przy tym działania aplikacji. Różnicę robi dopiero warstwa wokół modelu, bo w SIG przebiegi z obowiązkową bramką Sigrid Guardrails dały około 97% mniej poważnych znalezisk skanera.
 Bezpieczeństwo
Co naprawdę wychodzi z twojego katalogu, kiedy pracuje agent
4 min
Niezależny badacz publikujący jako cereblab podpiął Grok Build pod własne proxy i zobaczył, że terminalowe narzędzie xAI samo z siebie pakuje całe repozytorium razem z historią gita i wysyła je do chmury, a podłożone w pliku .env fałszywe hasło idzie tą samą drogą. Na repozytorium o rozmiarze 12 GB rozmową z modelem poszły 192 KB, a osobnym połączeniem 5,1 GB, czyli także pliki, których agent nigdy nie otworzył. Przełącznik "Improve the model" nic nie zmieniał, bo serwer xAI przy starcie sesji i tak odsyłał zgodę na wysyłkę, przez co poprawka przyszła od xAI, a nie z twojego dysku.
Poradnik / Praktyka · 3
 Poradnik / Praktyka
Wzorzec Karpathy'ego po czterech miesiącach: lista miejsc, w których się sypie
5 min
Po czterech miesiącach ze wzorcem wiki Andreja Karpathy'ego komentujący pod gistem zgłaszają te same pęknięcia: notatki zgadzają się z notatkami, a sprzeczność leży w linijce kodu, której wiki nigdy nie przeczytała. AbleVarghese wskazał, że w okolicach tysiąca plików model zaczyna cytować własne streszczenia na równi ze źródłami, a huachen-wang przy jednym zbiorczym wsadzie znalazł 38% stron będących bliźniakami. Poprawki, które przeszły, łączy to samo: rezerwacja nazwy w indeksie i twierdzenia zakotwiczone w pliku i zakresie linii, czyli kontrole wykonalne bez modelu.
 Poradnik / Praktyka
Pięć linijek, które piszesz, zanim odpalisz drugiego agenta
4 min
Poradnik Warpa o pracy z kilkoma agentami naraz sprowadza się do pięciu linijek wklejanych każdej sesji na start: kto odpowiada za które katalogi, na jakiej gałęzi pracuje i co ma zameldować na koniec. Warp rozpisuje to na osiem kroków, sadza każdego agenta we własnym worktree i wprost zabrania automatycznego scalania, bo cudzy błąd łapiesz tylko przy przeglądzie. Chmurowe polecenie /orchestrate zostawiłbym na migracje monorepo, bo poradnik nie podaje ani kosztu, ani oszczędności, a cztery agenty skracają czas pisania kodu i wydłużają czas jego czytania.
 Poradnik / Praktyka
Zestaw testów agenta potrafi wysłać prawdziwy przelew
4 min
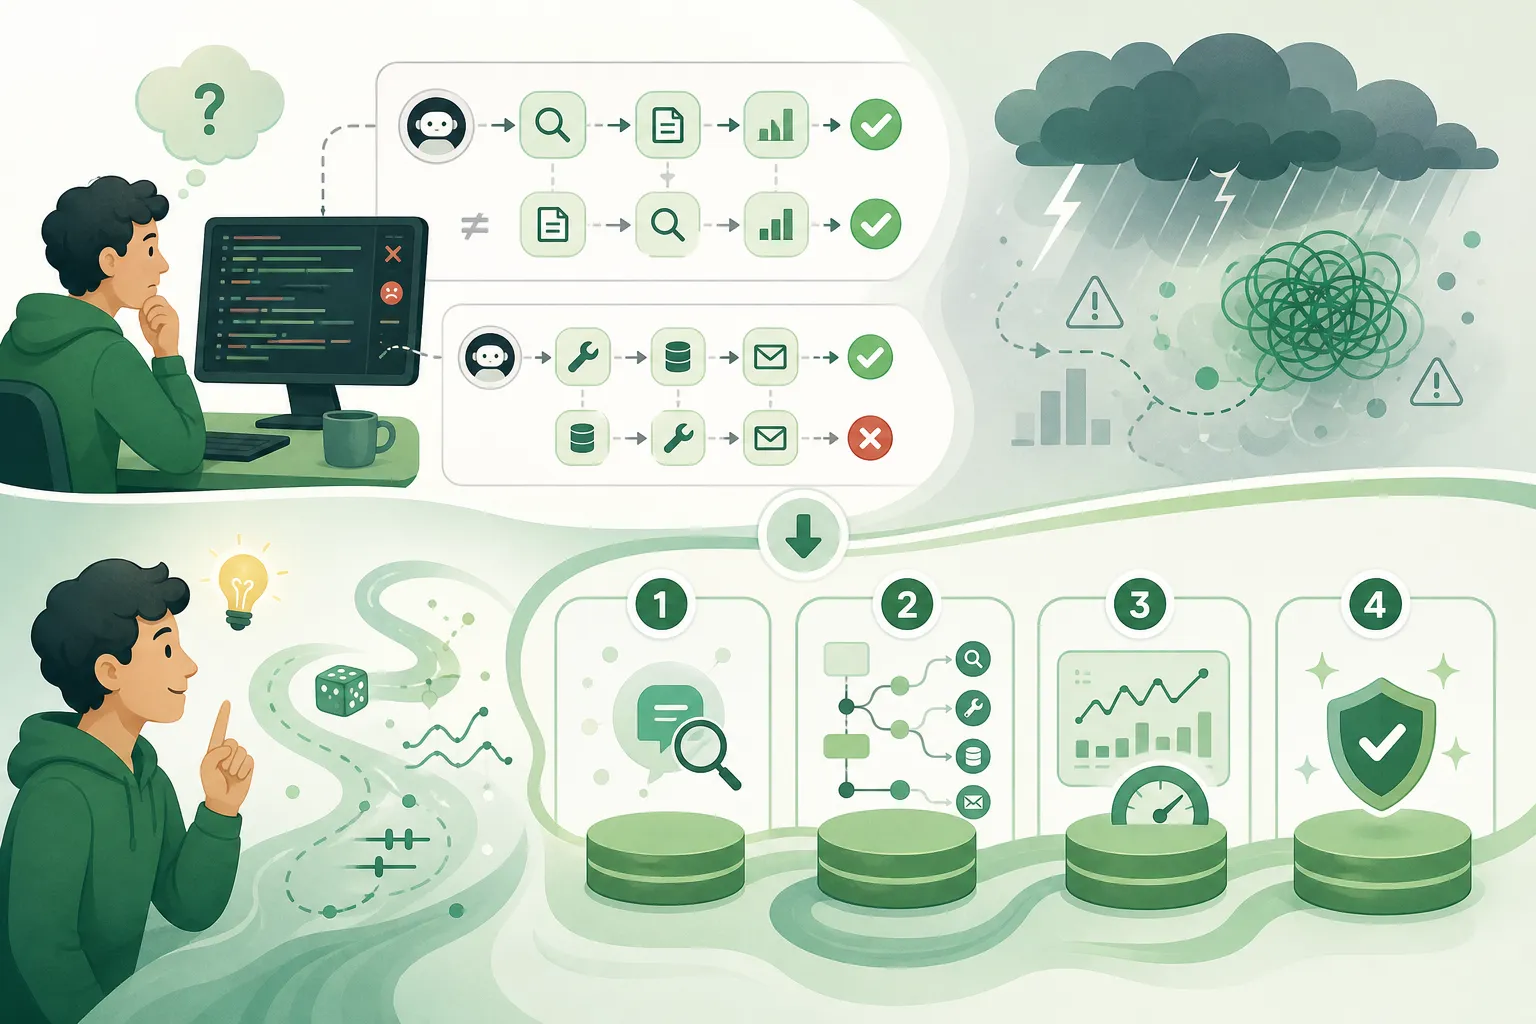
Braintrust tłumaczy, dlaczego test jednostkowy odrzuca poprawny przebieg agenta tylko za to, że sprawdził regulamin przed zamówieniem, i w miejsce asercji wstawia funkcję oceniającą cały zapis pracy w skali od 0 do 1, puszczaną kilka razy na to samo zgłoszenie. Zestaw wpięty w prawdziwe API płatnicze wysyłałby przy tym prawdziwe przelewy, więc usługi trzeba podstawić jako atrapy. Zapamiętałbym stąd liczbę kroków jako sygnał regresji, bo zapala się, zanim wynik zdąży się popsuć. Gorzej, że bramka w CI blokuje merge na ocenie modelu w roli sędziego, którego zgodności z ludźmi nikt nie podaje.
Analiza / Opinia · 4
 Analiza / Opinia
Dla 31% programistów Claude Code jest już narzędziem pierwszego wyboru
4 min
JetBrains przepytał ponad 15 tysięcy zawodowych programistów i wyszło mu, że po agenta do kodu sięga codziennie 68% z nich, a Claude Code używa w pracy 39%, wobec 18% w styczniu. Najciekawsza jest jednak inna liczba: dla 31% ankietowanych to narzędzie pierwszego wyboru, czyli jedyny wskaźnik mówiący o wyborze, a nie o wykupionej licencji. Copilot spadł z 29% do 21%, Cursor z 18% do 12%, i wygląda na to, że przegrywa forma, nie produkt: agenta w terminalu odpalasz obok tego, w czym pracujesz, a do nowego edytora trzeba się przeprowadzić.
 Analiza / Opinia
Recenzent trafił w linijkę z podatnością i jej nie nazwał
4 min
Agent recenzujący kod trafił w linijkę, w której adres od użytkownika szedł prosto do Kernel#open w Rubym, ale nie nazwał podatności, bo zabrakło mu wiedzy o jednej funkcji z biblioteki standardowej Ruby. Kodus wyciąga z tego, że o jakości przeglądu decyduje harness wokół modelu, i przyznaje, że własny graf wywołań doklejał do promptu, zamiast dać agentowi narzędzie getCallers w trakcie rozumowania. Firma zapisuje teraz pulę kandydatów sprzed filtrów, żeby widzieć, w którym z czterech miejsc ginie błąd, choć w całym wpisie nie pada ani jedna liczba z ewaluacji.
 Analiza / Opinia
Plik SKILL.md nie uczy agenta faktów, tylko pilnuje kolejności kroków
4 min
Zhiyuan Jiang i jego zespół zebrali 8135 kontrolowanych prób i ręcznie opisali 240 przebiegów, żeby sprawdzić, dlaczego pliki SKILL.md podnoszą skuteczność agentów: w 65,7% przypadków umiejętność działa jako kotwica proceduralna, a podanie faktu, którego model nie znał, tłumaczy raptem 4,5%. Trafność sięgnięcia po właściwy plik leci z 29,6% przy pięciu umiejętnościach do 3,3% przy stu, choć skuteczność w zadaniach zostaje stabilna, bo agentowi wystarcza sąsiedni plan. Wniosek jest taki, że robotę robi ponumerowana lista kroków, a nie opis kontekstu projektu.
 Analiza / Opinia
Kod przestał być drogi, utrzymanie nie
4 min
Avery Pennarun z Tailscale twierdzi, że narzędzia AI przesuwają drobne programy z kategorii "nie warto się za to brać" do "zrobię po obiedzie", i proponuje test trzech pytań: czy ktoś poza tobą już na tym polega, czy program rusza wrażliwe dane i czy jego awaria zatrzymałaby czyjąś pracę. Test jest dobry, tylko zadany o pół roku za wcześnie, bo narzędzie robi się ważne dopiero wtedy, gdy ktoś wpisze je do procedury. Pisanie kodu potaniało, ale drugi rachunek, czyli zmienione API, przegląd uprawnień i niezgodne liczby w panelu, wraca co miesiąc.