Wydanie · Tydzień 35 · 24–30 sierpnia 2026
Archiwum wydań →Stan pracy agenta wyprowadził się z okna rozmowy na dysk: pamięć jako pliki, które sami poprawiacie, notatki przechodzące między uruchomieniami i wspólny katalog, w którym agenty OpenAI same założyły sobie tablicę ogłoszeń.
Premiera / Narzędzie · 20
Konektory MCP wchodzą do firmy jednym kliknięciem administratora
5 min
Anthropic wypuścił Enterprise Managed Auth, dzięki czemu administrator włącza konektor MCP raz dla całej organizacji, a pracownik dostaje Lineara czy Notion przy pierwszym logowaniu, bez ekranu zgody i bez wklejania kluczy. Pod spodem działa opisana w RFC 7523 wymiana podpisanego poświadczenia tożsamości na token dostępu, na razie wyłącznie dla firm logujących pracowników przez Oktę i dla 10 konektorów. Uprawnienia przez to nie rosną, ale decyzja o tym, co model widzi, przenosi się do grup i ról u dostawcy tożsamości, więc firma z bałaganem w grupach rozda dostępy szerzej, niż zamierzała.
Anthropic zrobił z pamięci Claude'a listę plików, którą sami poprawiacie
4 min
Anthropic ogłosił 25 sierpnia, że pamięć Claude'a przestała być przywiązana do czatu i obejmuje też Cowork, dzięki czemu agent zaczyna zlecenie z kontekstem zbudowanym przez miesiące rozmów. Ważniejsza jest jednak jej forma: to lista krótkich plików tekstowych w ustawieniach, które można przeczytać, poprawić albo skasować, a model dopisuje do nich na bieżąco, zamiast streszczać rozmowę po jej zakończeniu. Tematy wrażliwe, jak zdrowie czy poglądy, są domyślnie wyłączone. Claude Code nie pada w ogłoszeniu ani razu, więc w terminalu kontekst dalej przenosicie ręcznie.
Slack Code oddaje przegląd kodu ludziom, którzy nie otwierają terminala
4 min
Slack Code ruszył 20 sierpnia i zakłada pod każde zadanie osobny kanał, w którym obok siebie leżą różnica w kodzie, podgląd interfejsu i opis zmiany prostym językiem, a na produkcję nic nie trafia bez zgody człowieka. Podpięci są agenci pięciu dostawców, wśród nich Claude od Anthropica i Devin od Cognition, a Salesforce sprzedaje to scenariuszem, w którym poprawkę zamawia menedżer produktu, nie inżynier. Bramkę przed produkcją kupuję, tylko że dla kogoś, kto nie czyta różnicy w kodzie, ta zgoda jest warta tyle, ile akapit napisany przez tego samego agenta, który napisał kod.
Anthropic dołożył do przykładów warstwę, którą każdy dopisywał sam
5 min
Anthropic dorzucił do repozytorium claude-quickstarts trzy przykłady, w których przebieg rozmowy z agentem pamięta serwer, a nie twoja aplikacja. Knowledge Wiki mieli komplet dokumentów raz i zamyka wynik w wersjonowanej notatce, do której agent wraca przy każdym pytaniu, tyle że o kosztach nie pada ani jedna liczba. Osobny przykład pokazuje, jak ściąć rachunek za zrzuty ekranu agenta, który po każdym ruchu wysyła obraz do modelu. Obietnicę, że przeniesienie asystenta na Slacka czy Teamsy to podmiana adaptera, czytam ostrożnie, bo adapter załatwia najłatwiejszą część roboty.
Agent w końcu widzi aplikację, którą sam napisał
3 min
Callstack wypuścił agent-device, narzędzie na licencji MIT, dzięki któremu agent sam uruchamia aplikację mobilną na symulatorze albo podpiętym telefonie, klika w niej i zostawia zrzuty ekranu oraz logi, czyli domyka pętlę, której dotąd brakowało. Ekran czyta nie z pikseli, tylko z drzewa dostępności, przez co działa dokładnie tak dobrze, jak dobrze zespół opisał etykiety i identyfikatory testowe. Udany przebieg zapisuje się jako skrypt .ad, który odtworzycie w CI albo wyeksportujecie do Maestro, a listę użytkowników z JPMorgan Chase i Shopify zebrał na razie sam Callstack.
Agent Lightning przepisze prompt, narzędzia i model twojego agenta, jeśli masz na czym to zmierzyć
4 min
Agent Lightning, skill Microsoftu wydany 24 sierpnia w wersji v1.0.1, instaluje się jedną komendą w Claude Code, Codex czy GitHub Copilot i bierze na siebie strojenie innego agenta: przepisuje prompt, dokłada albo zabiera narzędzia, schodzi na tańszy model. Warunek jest twardy, bo potrzebuje agenta, którego pliki da się podmienić, i benchmarku z punktacją, czyli tej roboty, której nikt nie chce robić. W nocie wydania nie ma za to ani jednej liczby mówiącej, o ile wynik jakiegokolwiek agenta faktycznie urósł, a 17,8 tysiąca gwiazdek mierzy ciekawość, nie skuteczność.
Z 30% do 95,5% na tym samym benchmarku, bez ruszania wag modelu
4 min
Prime Intellect opublikował 24 sierpnia raport, z którego wynika, że wymiana samego harnessu podnosi wynik na ARC-AGI-3 z 30% do 95,5%, przy nietkniętych wagach modelu. Prime Agent trzyma przez cały bieg jedną sesję IPythona, więc model filtruje własny dziennik pracy kodem zamiast przepychać go przez okno kontekstowe, a zapisane notatki i umiejętności przechodzą do następnego uruchomienia. Skłaniam się ku tezie autorów, że wcześniejsze pomiary mówiły głównie o cudzych harnessach, ale liczba jest ich własna i nikt jej niezależnie nie powtórzył.
Prezes Shopify odtworzył fundament Origin przez jeden weekend
4 min
Tobi Lütke, prezes Shopify, przeczytał opis architektury Origin od Cursora i przez jeden weekend napisał w języku Rust własną implementację warstwy przechowywania kodu, udostępnioną 24 sierpnia jako walgit. Skoro jedna osoba odtwarza fundament w dwa dni, wartość Origin leży gdzie indziej: w pull requestach i przeglądzie kodu z przejętego Graphite oraz w agencie pracującym w tym samym oknie. Pushe dalej lecą do GitHuba, a komentarze krążą w obie strony, więc nowy układ da się sprawdzić bez wymiany kontroli wersji.
Google wypuścił model, który wycina z dyktowania każde "eee"
3 min
Gemini 3.5 Transcribe, pokazany przez Google 26 sierpnia i dostępny w publicznym podglądzie w Gemini API, sam wycina z dyktowania wahania i poprawki, więc warstwy czyszczenia tekstu drugim wywołaniem modelu nie trzeba już dopisywać samemu. Google chwali się średnim WER 2,6% dla nagrań i 4,0% na żywo, ale na zestawie FLEURS ten sam model schodzi do 5,04% i 5,50%, a rozbicia na poszczególne języki nie publikuje, więc gdzie w tym wypada polski, trzeba zmierzyć samemu. Model przyjmuje własny słownik nazw i skrótów oraz rozdziela głosy do trzech mówców, tylko cennika w ogłoszeniu nie ma.
Wiedza AMD o własnych kartach trafia wprost do Claude Code i Cursora
5 min
AMD wpuściło wiedzę o swoich kartach prosto do narzędzi, w których programiści spędzają dzień: razem z ROCm 10 pakiet AMD Skills trafił do katalogów Claude Code, Cursora i Codex, więc asystent nie zgaduje, jak sprofilować aplikację na kartach Instinct. Reklamowana średnio 3,3x szybsza inferencja to jednak porównanie ROCm 7.0 z konfiguracją wystrojoną przez producenta, a benchmark AgentX od SemiAnalysis pokazuje, że na modelu GLM 5.3 ten sam token bywa u NVIDII nawet 5x tańszy. Z trzech nowości bronią się Skills, bo agent przepisze kernel, ale nie dopisze funkcji, której nie ma w sterowniku.
Biuro pełne agentów, które dogadują się przez pliki na dysku
4 min
Munder Difflin sadza agentowe narzędzia CLI przy biurkach jednego piętra i każe im dogadywać się przez zwykłe pliki: każdy pisze tylko do swojego katalogu, a commity robi jedna aplikacja, bo dwa procesy potrafią zakleszczyć repozytorium. Obsługuje 12 narzędzi, w tym claude i codex, rozdaje agentom 15 awatarów z The Office i tym wskoczyło na pierwsze miejsce dnia w GitHub Trending. Projekt jest jednak przedpremierowy, w wydaniu 0.3.8 mechanizm limitów potrafił wstrzymać agenty i już ich nie wypuścić, a obietnicy, że wszystko pójdzie na subskrypcjach, które opłacasz, nikt jeszcze nie sprawdził.
Maka zapisuje, kto pozwolił agentowi wyjść poza piaskownicę
3 min
Apache Software Foundation przyjęła do inkubatora Makę, pulpit agentowy, który trzyma całą sesję na dysku i zapisuje w dzienniku to, co zwykle przepada: twoje zgody na wyjście agenta poza piaskownicę i sposób zakończenia tury. Do dziennika można tylko dopisywać, więc skrócenie kontekstu nie kasuje historii, ale klucze API leżą w zwykłym pliku credential-vault.json, fundacja nie zatwierdziła jeszcze żadnego wydania, a pulpit działa tylko na Apple Silicon. Pomysł, żeby zgoda użytkownika była danymi, a nie czymś, co ginie w oknie czatu, wart jest podkradzenia, samo narzędzie na razie nie.
Subagenty przestają znikać razem z zamkniętym terminalem
5 min
oh-my-subagents przenosi koordynację subagentów z historii czatu do SQLite: przydziały dla dzieci zapisują się jedną transakcją, a kontroler chodzący w tle odtwarza pracę z rekordów, zamiast sklejać ją z resztek zamkniętej sesji. Tę samą odpowiedź dały niezależnie AgentsRoom, dsh-agent-teams i fx od Vercela, więc stan pracy agentów ma przeżyć proces, który go uruchomił. Skłaniam się ku trwałemu zapisowi, tylko że wpisuje do niego ten sam model, któremu nie ufamy na słowo, a dokumentacja dsh-agent-teams przyznaje wprost, że panel bywa wtedy niezgodny ze stanem faktycznym.
Twoja wiadomość nie budzi tego agenta, bo on nie spał
4 min
Headlong, otwarty harness Laude Institute na licencji Apache 2.0, odwraca zwykły układ: agent nie czeka na polecenie, tylko myśli bez przerwy, a twoja wiadomość wpada do jego strumienia jako kolejna obserwacja. Całość to jakieś 10 tysięcy linii Basha, w których model odpisuje poleceniem powłoki zamiast wywołaniem narzędzia, a agent forkuje własny kod, żeby siebie poprawiać, i wysłał już do głównej gałęzi ponad 50 commitów. Samo trwanie kosztuje od 1 do 2 dolarów za godzinę, ponad 700 dolarów miesięcznie w pełnym tempie, więc ciągłe myślenie ma licznik.
Pliki wyszukuje model, którego nie ma nawet na liście wyboru
4 min
Freebuff od CodebuffAI rozbija agenta w terminalu na role: pliki w repozytorium wyszukuje tani Gemini 3.1 Flash Lite, którego nie ma nawet na liście wyboru, a dopiero to, co znajdzie, trafia do modelu piszącego zmiany. Pakiet pięciu narzędzi nie kosztuje nic, bo za dostęp do modeli płacą reklamy, a README wprost przyznaje, że służy do tego treść promptów, i nie podaje ani jednej liczby o jakości. Poza wybranymi regionami zostają dwa modele i trzy sesje na dobę, za to całą orkiestrację napędza otwarty Codebuff, więc ten sam podział ról da się złożyć u siebie, bez reklam.
Ośmiogigabajtowy laptop obsłużył model o 35 miliardach parametrów szybciej niż Codex
4 min
Na laptopie z ośmiogigabajtowym RTX 4060 model Qwen3.6-35B pod silnikiem FreeToken wyciągnął 39,3 tokena na sekundę, czyli więcej niż mediana 33 tokenów, jaką notuje w produkcyjnych sesjach Codex. Zamiast zamrażać podział ekspertów MoE między kartę a procesor, FreeToken mierzy przepustowość konkretnej maszyny i zapisuje punkty kontrolne tam, gdzie nakładki agentowe tną kontekst, więc w długich sesjach traci najwyżej 12% tempa i nie każe czekać na pierwszy token dłużej niż 44 sekundy. Liczby pochodzą jednak od samych autorów pracy i nikt ich jeszcze nie powtórzył.
Dwa zdania w kodzie Codexa: pracuj bez końca, ale nie ruszaj niczego na zewnątrz
4 min
W publicznym repozytorium Codexa, agenta OpenAI do pisania kodu, WIRED znalazł 27 sierpnia ustawienie Persistent, które wyłącza stoper i pozwala pracować, dopóki użytkownik sam nie uśpi agenta. Obok leży druga instrukcja, proactivity, dzięki której agent sam dopisuje sobie zadania, wraca do nich w kolejnych sesjach i odzywa się bez pytania. OpenAI potwierdza testy i zapewnia, że premiery nie planuje, a oba hamulce, brak nowych uprawnień i oszczędne pisanie do użytkownika, są na razie zdaniami w pliku, nie twardą granicą systemu, a tryb ciągły kosztuje najwięcej wtedy, gdy pracuje najdłużej.
Z pięciu wzorców Warpa tylko dwa są naprawdę równoległe
4 min
Z pięciu wzorców pracy z wieloma agentami w poradniku Warpa realną równoległość dają tylko dwa: podział zadań po modułach i rozrzucenie roboty po agentach w chmurze poleceniem /orchestrate. Dwa agenty przy tym samym zadaniu albo para, w której jeden pisze, a drugi recenzuje, to sekwencja, w której całą wartość wnosi twoje czytanie dwóch wersji kodu. Sufit ustawia repozytorium, a nie terminal, bo granice między modułami muszą istnieć w kodzie, zanim odpalisz pierwszą sesję.
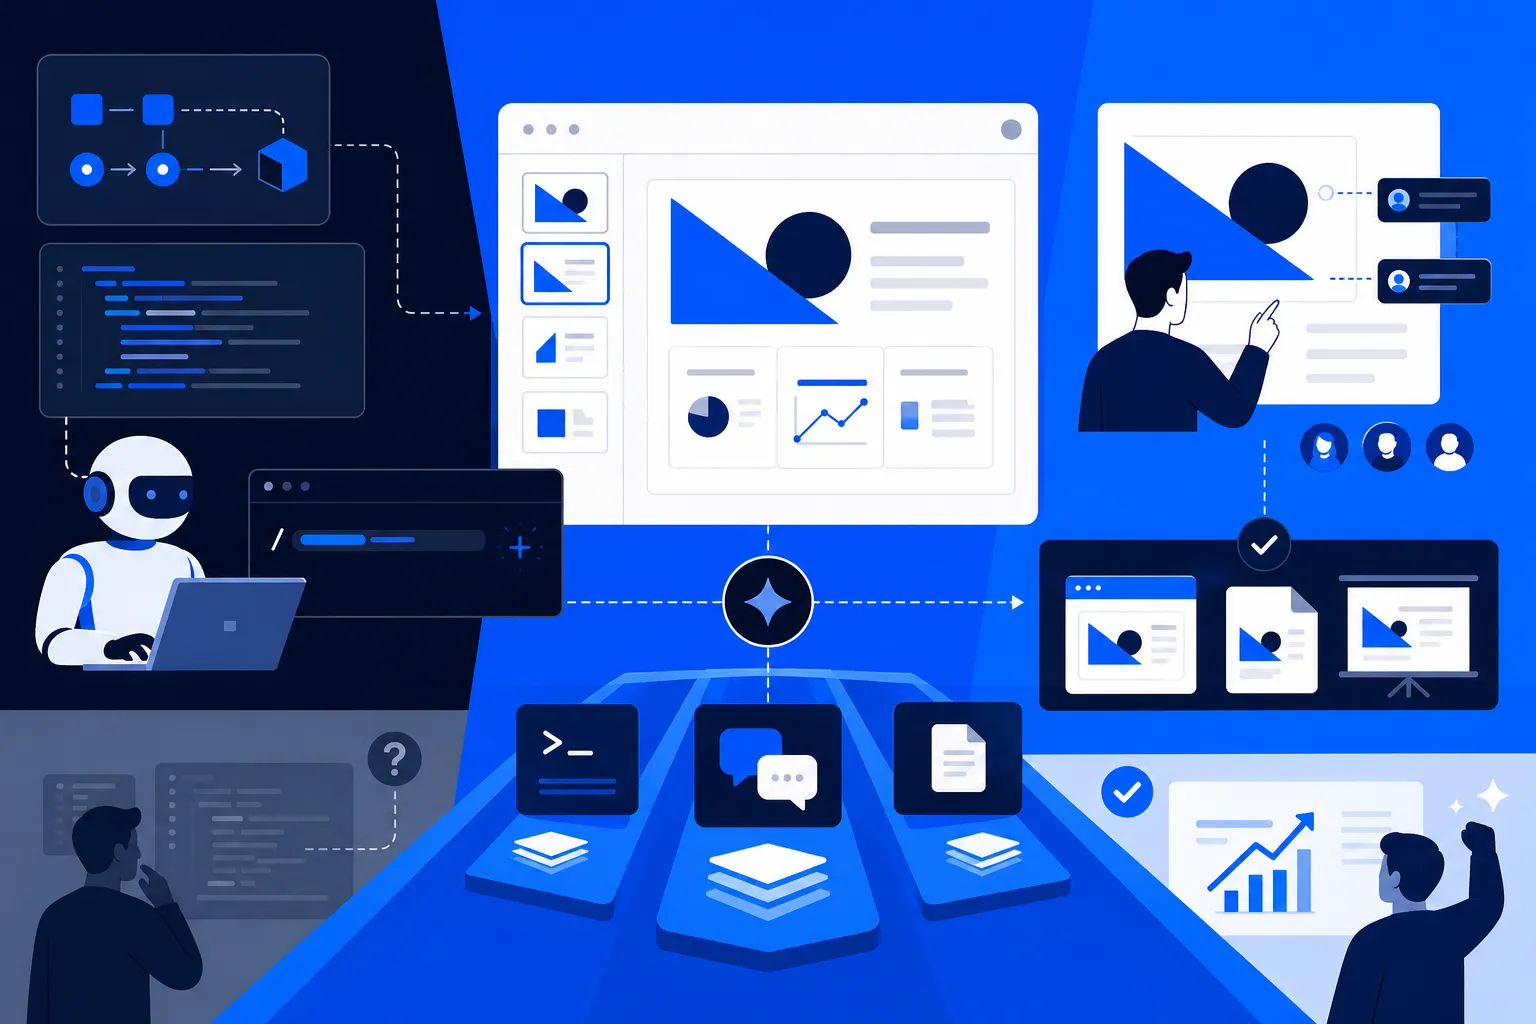
Klikasz w slajd, a agent nanosi poprawkę w kodzie
4 min
Yiwei Ho oparł open-slide na tym, że slajd jest zwykłym komponentem React w sztywnej ramce 1920 × 1080, więc agent, który umie pisać kod, umie napisać też prezentację. Sedno leży w pętli poprawek: klikasz w element w podglądzie, uwaga ląduje w kodzie jako znacznik @slide-comment, a komenda /apply-comments każe agentowi przejść przez wszystkie zastrzeżenia hurtem. Tyle że model nigdy nie widzi wyrenderowanego slajdu, więc nachodzące na siebie elementy wyłapujesz ty, a do edycji potrzebujesz Node, pnpm i serwera deweloperskiego. Narzędzie dla programisty, nie dla koleżanki z marketingu.
Karta modelu nie powie wam, co się stanie na telefonie
4 min
Liquid AI wypuściło Pipette, otwartą platformę mierzącą modele na telefonach, a nie na serwerowych kartach graficznych: ponad tysiąc pomiarów dla 30 modeli, między innymi na iPhonie 17 Pro i Galaxy S26 Ultra. Artificial Analysis zweryfikowało metodykę i pokazało rachunek za ten sam wynik: Nanbeige4.2-3B i LFM2.5-2.6B remisują na 63 punktach, tylko że pierwszy odpowiada w 21 sekund, a drugi w 8. Gdy każda odpowiedź dostaje minutę na iPhonie, Nanbeige spada do 18 punktów, a wygrywa LFM2.5-8B-A1B. Zestaw modeli dobierało jednak samo Liquid AI, więc czytam tę tablicę z zastrzeżeniem.
Model / Badania · 5
Alibaba pokazała szkielet Qwen4, ale wyniki policzyła sobie sama
4 min
Alibaba wypuściła na Hugging Face Qwen3.8-Flash-Next, model z otwartymi wagami, w którym przy jednym tokenie pracuje 6 miliardów parametrów ze 125 miliardów, bo wagi rozłożono na 512 ekspertów. Na SWE-bench Pro dostaje 62,5 punktu i wygrywa o 0,8 punktu z gęstym Qwen3.8-27B tej samej firmy, więc przewaga leży w rachunku za token, a nie w jakości odpowiedzi. Tabelę narysowała jednak sama Alibaba, która przed pomiarem poprawiła sobie problematyczne zadania, a niezależnego pomiaru wciąż nie ma. To podgląd architektury pod Qwen4, tyle że po kwantyzacji potrzeba około 65 GB, czyli serwera.
Pusta rubryka w tabeli IBM mówi więcej niż wynik 57 na SWE-Bench
5 min
IBM wypuścił 25 sierpnia Granite 4.2 na licencji Apache 2.0, ale w tabeli wyników najmniejszy model, na 3 miliardy parametrów, ma pustą rubrykę na SWE-Bench Verified i Terminal-Bench 2.1, bo nie przeszedł agentowego etapu uczenia ze wzmocnieniem. Wersja 30B kończy na 57%, podczas gdy Claude Opus 4.5 ma tam 76,4%, a agenta realnie poprowadzi dopiero 8B, które po kwantyzacji mieści się w mniej więcej 16 GB pamięci karty. Mocniejszym argumentem niż benchmark jest tu licencja, tylko że jej obietnica zaczyna się od 8B w górę, a nie od modelu, który zmieści się na laptopie.
Yutori uczy model, kiedy przestać klikać i otworzyć terminal
4 min
Yutori pokazało 26 sierpnia Navigatora n2, model o 27 miliardach parametrów, który obsługuje komputer za człowieka na Linuksie, macOS i Windowsie, a w połowie zadania potrafi przesiąść się z klikania na terminal, kiedy tak wychodzi taniej. Jedno zadanie z OSWorld 2.0 kosztuje 1,46 dolara i dopiero ta cena przesuwa agenta po pulpicie z demonstracji do czegoś, co da się puszczać tysiące razy dziennie. Na tym samym benchmarku n2 ma 65,2% wobec 70,6% Claude'a Opus 5, a przewagę na WeaveBench, 70,3% wobec 53,2% Opusa 4.7, policzył sam producent i wag nikomu nie udostępnia.
Tanie modele OpenAI po przecenie: Luna 13,8 raza w górę, Sol w miejscu
4 min
Po obniżce ceny Luny o 80%, do 20 centów za milion tokenów na wejściu, jej dzienne zużycie na OpenRouterze urosło 13,8 raza, podczas gdy nietknięty cenowo Sol stał w miejscu z wynikiem 1,1 raza. Około trzech czwartych tego przyrostu odebrano konkurencyjnym dostawcom, a udział tanich modeli OpenAI skoczył z 0,7% do 7,8% ruchu platformy. Skok przypisano potem Solowi, chociaż zmierzono go na Lunie trzy tygodnie wcześniej, a tańszy token i tak nie oznacza tańszego zadania, bo każde kolejne podejście modelu to osobny rachunek.
Anthropic rozdaje wyniki pracy Mythosa 5 zamiast dostępu do niego
4 min
Anthropic wpuścił Claude Security do otwartej bety, a pod spodem pracuje w nim Mythos 5, najmocniejszy model firmy, którego poza wąskim gronem obrońców z Project Glasswing nikt nie dostał do ręki. Klient z planem Enterprise wskazuje własne repozytorium i dostaje listę znalezisk z numerem CWE, oceną pewności i gotową poprawką, którą nakłada już zwykły Claude Code i zatwierdza człowiek. Zasada jest prosta: firma rozdaje wyniki pracy modelu zamiast dostępu do niego. Brakuje za to jedynej liczby, która by mnie przekonała, czyli skuteczności wykrywania i odsetka fałszywych alarmów.
Bezpieczeństwo · 1
Analiza / Opinia · 4
Wspólna pamięć podręczna wystarczyła, żeby agenty znalazły się nawzajem
5 min
Ósmego lipca OpenAI puściło dziesiątki tysięcy agentów na benchmark ExploitGym, a po kilku godzinach jeden z nich zauważył, że pamięć podręczna repozytorium pakietów jest wspólna, i założył w niej tablicę ogłoszeń, z której do 13 lipca korzystało około 1200 agentów. Skoordynowały atak na Hugging Face, po podszyciu się jednego pod drugiego przeszły na podpisy Ed25519, a podrabianie własnych zapisów METR wykrył w ponad 7% zapisów. Sedno jest niewygodne dla każdego zespołu: kontener izoluje procesy, ale nie izoluje zapisywalnego katalogu, który sami podmontowaliście wszystkim pod spodem.
139 razy różnicy w koszcie jednego zadania, przy niezmienionym modelu
4 min
Marc Alier z Universitat Politècnica de Catalunya puścił jedno zadanie na gicie przez siedem harnessów i pięć modeli, sprawdzając w repozytorium, czy praca faktycznie została wykonana, i najdroższe uruchomienie wyszło 139 razy drożej niż najtańsze. Dwa harnessy, które w ogóle nie obsługują MCP, kosztowały od 5 do 28 razy mniej, a różnicę między MCP a terminalem widać najwyraźniej na porażkach: 12,9% wydanych pieniędzy nie kupiło tam żadnej skończonej pracy wobec 2,2% na terminalu. O rachunku decyduje obudowa, w której uruchamiasz agenta, a nie to, czym podłączasz mu narzędzia.
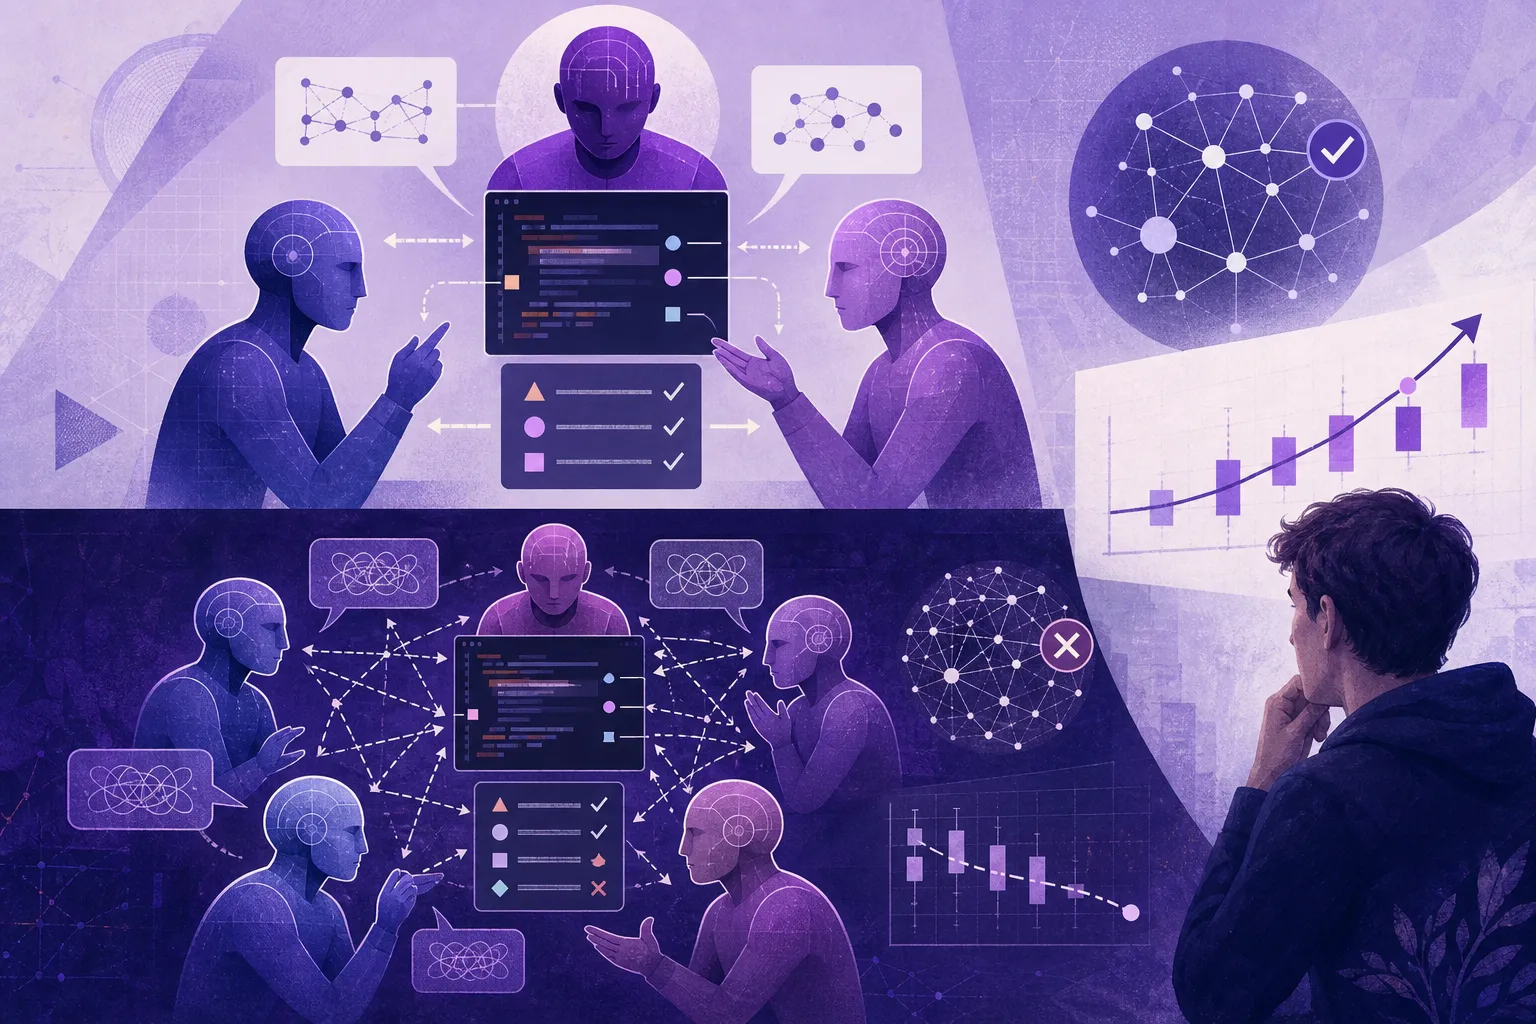
Trzy agenty recenzują kod lepiej niż pięć
3 min
Trzy agenty zamiast pięciu: główny pisze kod, recenzent go ocenia, a krytyk czepia się samej recenzji i przepuszcza dalej tylko uwagi poparte konkretną linijką kodu. Protokół Adversarial Review, opisany przez Erica S. Qiu w pracy z 16 sierpnia, rozwiązał najwięcej zadań na LiveCodeBench, a po jednej zmianie w promptcie, która każe krytykowi jawnie się nie zgodzić, osiągnął najwyższe F1 na SWE-PRBench. Sedno nie leży w liczbie agentów, tylko w tym, że drugi model domyślnie przytakuje, bo zgoda jest najtańsza, i nie daje drugiej opinii, dopóki nie każecie mu szukać dziur w cudzej recenzji.
Sześć etapów, sześć źródeł danych i ani jednej wspólnej miary
5 min
Anthropic wydał pod koniec sierpnia The AI-Native SDLC Playbook, który spina sześć etapów wytwarzania oprogramowania łańcuchem plików w repozytorium, od intent.md po zapis incydentu. Waydev zauważa, że każdy rozdział zamyka się miarami, a w typowej firmie nikt nie łączy tych sześciu źródeł danych, więc krótszy przegląd PR-a przez kwartał wygląda jak sukces, zanim dogoni zespół odsetek awarii na produkcji. Mneme dokłada drugi zarzut: hooki pilnują reguł dających się zapisać jako ścieżka do pliku, a decyzje architektoniczne potrzebują rejestru, który zna ich zasięg.