Wydanie · Tydzień 38 · 14–20 września 2026
Archiwum wydań →Agent coraz rzadziej dostaje przymiotniki, a coraz częściej konkretne liczby i pliki w waszym repozytorium: reguła lintera wymienia dostępne rozmiary, DESIGN.md podaje paletę i skalę, auth.md warunki rejestracji. To, co zostało w prompcie, nowy model wykonuje dosłownie.
Premiera / Narzędzie · 16
 Premiera / Narzędzie
Droższy model prowadzący ścina rachunek za całą sesję o 9%
5 min
Cognition posadziło na czele Fusion droższy model, Fable 5, i sesje wyszły średnio o 9% taniej, bo prowadzący rzadziej przerabiał zadania po tańszym pomocniku. Na DeepSWE 1.1 para oddaje 1,2 punktu z 64,3 i ścina rachunek o 46%, ale przy migracji kodu traci 6,4 punktu i oszczędza tylko 20%. Wniosek Cognition brzmi prosto: modele i otaczające je harnessy wycenia się po cenie za zadanie, a nie po cenie za token. Tyle że SWE-2 nie ma ani otwartych wag, ani API, więc sprawdzisz to wyłącznie wewnątrz Devina.
 Premiera / Narzędzie
Factory warte 5 miliardów, a zaczyna od sprawdzenia twojego repozytorium
4 min
Factory zebrało 15 września 200 milionów dolarów przy wycenie 5 miliardów, a jeszcze w kwietniu firma była warta 1,5 miliarda. Zanim jej agenty Droids dotkną kodu, platforma żąda raportu gotowości i prześwietla nie model, tylko twoje repozytorium: układ plików, opisy i zabezpieczenia. Pieniądze idą za maszynerię dookoła modelu, czyli wybór kontekstu, narzędzia do uruchomienia testów i pętlę, w której agent poprawia kod po własnej wywrotce. Lepszym sprawdzianem niż wycena są minuty, które nad przeglądem spędzają twoi najbardziej doświadczeni ludzie.
 Premiera / Narzędzie
Anthropic połączył Cowork z czatem i dołożył do tego Docs oraz Slides
4 min
Od 16 września Cowork znika jako osobna zakładka, bo Anthropic zszył go z czatem w jedno okno, a do tej samej rozmowy wprowadziły się Claude Docs i Claude Slides z eksportem do PowerPointa. Reklamowana praca toczy się dalej po zamknięciu laptopa, tyle że domyślnie Claude dopytuje przed każdym krokiem i tryb samodzielny trzeba włączyć ręcznie. Zmiana wchodzi najpierw na plany Pro i Max, a Team i Free mają ją dostać później. Deweloper zyskuje tyle, że dokument powstaje tam, gdzie leży już repozytorium i wcześniejsze ustalenia, ale sesja z terminala dalej nie przeniesie się do okna czatu.
 Premiera / Narzędzie
Dwa lata notowań w Claude Code bez klucza do API
3 min
TradingView uruchomił 16 września publiczną betę serwera MCP, dzięki czemu asystent sięga po notowania i raporty spółek z twojego konta, bez osobnego klucza do API i bez eksportu do CSV. Konfiguracja sprowadza się do wklejenia jednego adresu i zalogowania, a dostęp mają płacący klienci od planu Essential w górę. Z ośmiu pokazanych zastosowań warsztat zmienia jedno: w Claude Code model sam pobiera dwa lata notowań bitcoina, pisze analizę i rysuje wykres korelacji. Dane są jednak opóźnione, a dobowy limit zapytań ucina wszystko, co miałoby reagować na rynek.
 Premiera / Narzędzie
Agent psuje wam przyciski, bo błąd nie mówi mu, co zrobić
4 min
@shadcn/lint, wtyczka ekipy shadcn/ui do ESLinta, zamienia komunikat błędu w kanał, którym dowozicie agentowi zasady systemu projektowego. Zamiast samego "tak nie wolno" reguła tłumaczy, że Button sam pilnuje odstępów, i wymienia rozmiary dostępne w waszym repozytorium, dzięki czemu model nie musi zgadywać. W przebiegach autora Opus 5 zostawił 42 naruszenia na osiem zadań, a GPT 5.6 Terra aż 117, choć po rundzie poprawek z podpowiedziami lintera każdy schodził do zera. Linter czyta jednak tylko nazwy klas CSS, więc formularza, przez który nie da się przejść tabulatorem, i tak nie wyłapie.
 Premiera / Narzędzie
Archiwum prawdziwych stron, które agent czyta, zanim napisze interfejs
4 min
Inspo to serwer MCP, który daje agentowi archiwum 2320 zrzutów z 832 prawdziwych witryn, a do każdej dokłada plik DESIGN.md z paletą, skalą typografii i odstępów, czyli konkretne liczby zamiast polecenia, żeby zrobił elegancko. Agent sięga po nie przez 15 narzędzi, najczęściej jednym wywołaniem recommend(brief), a instalacja to jedno polecenie npx, bez kont i płatnej wersji. Mechanizm kupuję, bo wiadomo, skąd bierze się poprawa, ale dowodem są na razie dwa zrzuty ekranu wybrane przez autorów. Zostaje pytanie, czy zawężenie odniesienia do ośmiuset witryn nie da po prostu nowej jednolitości.
 Premiera / Narzędzie
Google wystawiło inteligentny dom na MCP i od razu zabroniło agentom otwierać drzwi
4 min
Google wystawiło 16 września serwer MCP dla Google Home, więc dowolny agent obsługujący ten standard dostaje listę urządzeń, ich stany, historię zdarzeń i prawo do wydawania komend. Otwarcia zamka zabrania sam serwer, a nie instrukcja dla modelu, a twarze z kamer Nest wymagają osobnej zgody menedżera domu. Wejście kosztuje projekt w Google Cloud, własny klient OAuth i 20 dolarów miesięcznie za Home Premium Advanced, na razie tylko w Stanach. To warstwa dla twórców cudzych produktów, a nie funkcja dla mieszkańca, i buduje ją firma, która wygasiła już pięć platform inteligentnego domu.
 Premiera / Narzędzie
WorkOS chce, żeby agent zakładał konto za ciebie, bez formularza
4 min
WorkOS wypuścił auth.md, otwarty protokół, w którym aplikacja kładzie u siebie zwykły plik Markdown i opisuje w nim, na jakich zasadach przyjmuje rejestracje od agentów, podobnie jak robots.txt opisuje indeksowanie. Do wyboru są dwie ścieżki: dostawca tożsamości podpisuje zaświadczenie, że za agentem stoi konkretny człowiek, albo użytkownik zatwierdza kod we własnej przeglądarce, jak przy parowaniu telewizora. Obie kończą się tokenem OAuth przypisanym do człowieka, więc w audycie zostaje ślad zamiast wspólnego konta technicznego. Na liście wdrożeń nie ma jednak na razie ani jednej aplikacji.
 Premiera / Narzędzie
Po co budować własną pętlę agenta, skoro OpenAI poprowadzi ją za ciebie?
4 min
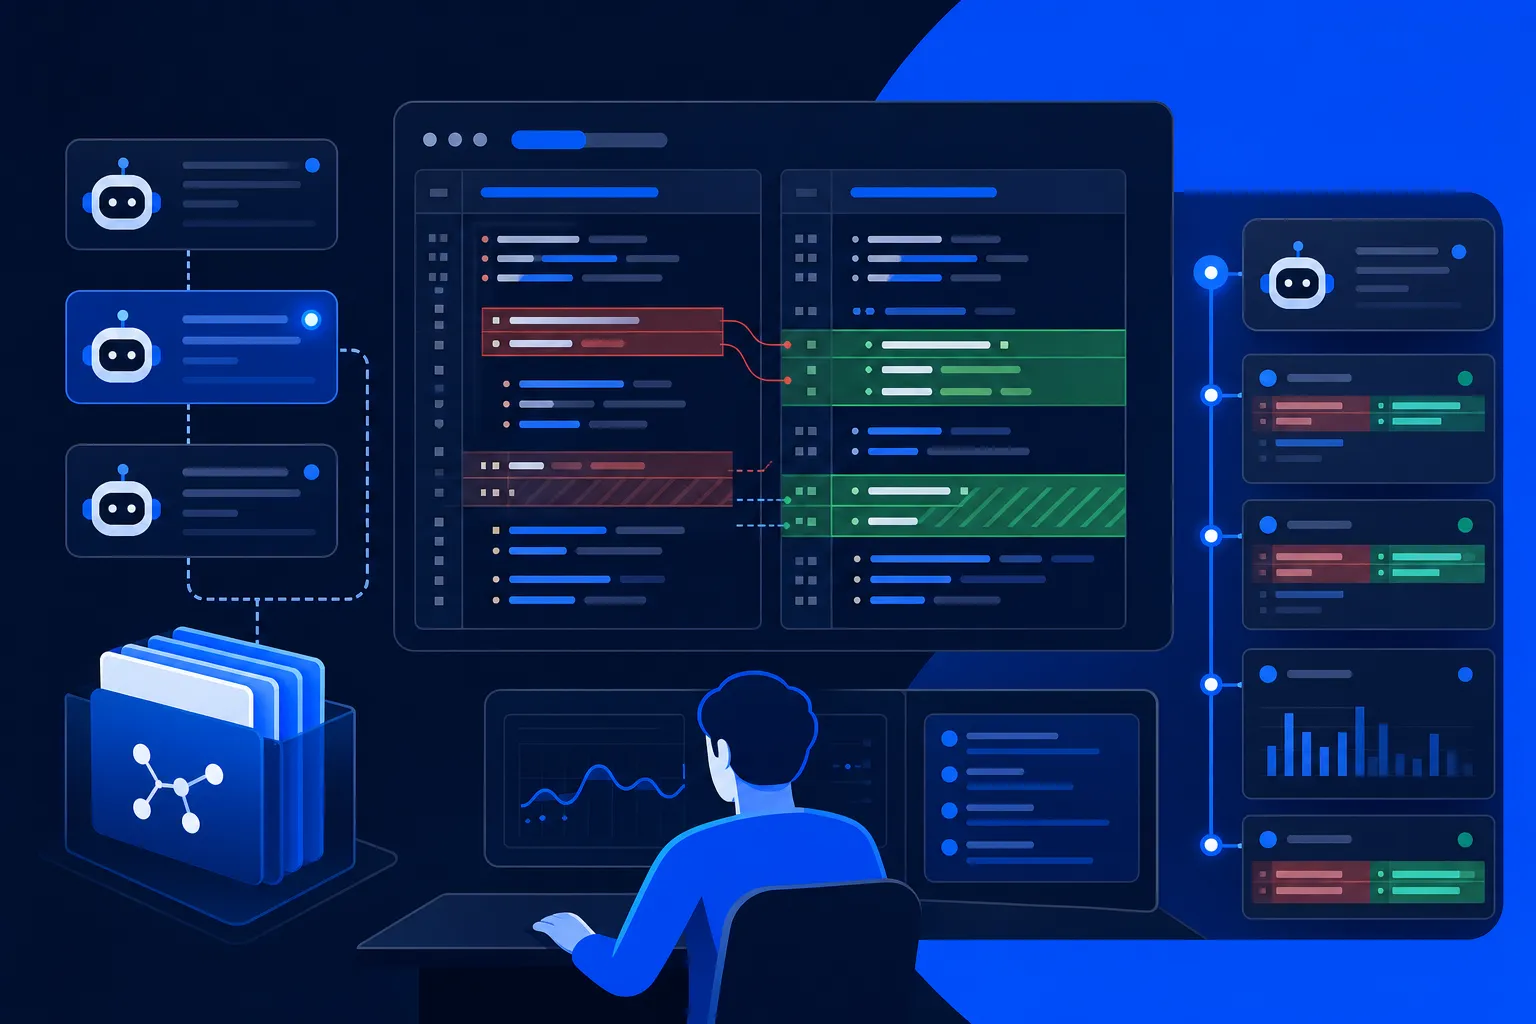
OpenAI wyjęło z Codexa całą warstwę, która prowadzi agenta, i 10 września wystawiło ją jako Agents API w publicznej becie: podajesz zadanie, model i narzędzia, a pętlę prowadzi już ktoś inny. Sam harness nic nie kosztuje, płacisz za tokeny i czas kontenera, a ten najgrubszy, z 64 GB pamięci, wychodzi 5,76 dolara za godzinę pracy agenta. Jest jeden warunek: dane zostają w Stanach Zjednoczonych nawet wtedy, gdy kod wykonujesz u siebie, bo stan sesji i tak leży po stronie OpenAI. Czytam to jako wynajem, nie fundament, tym bardziej że kod harnessu Codexa leży otwarty na GitHubie.
 Premiera / Narzędzie
Drugie okno terminala, w którym widać pracę agenta linia po linii
3 min
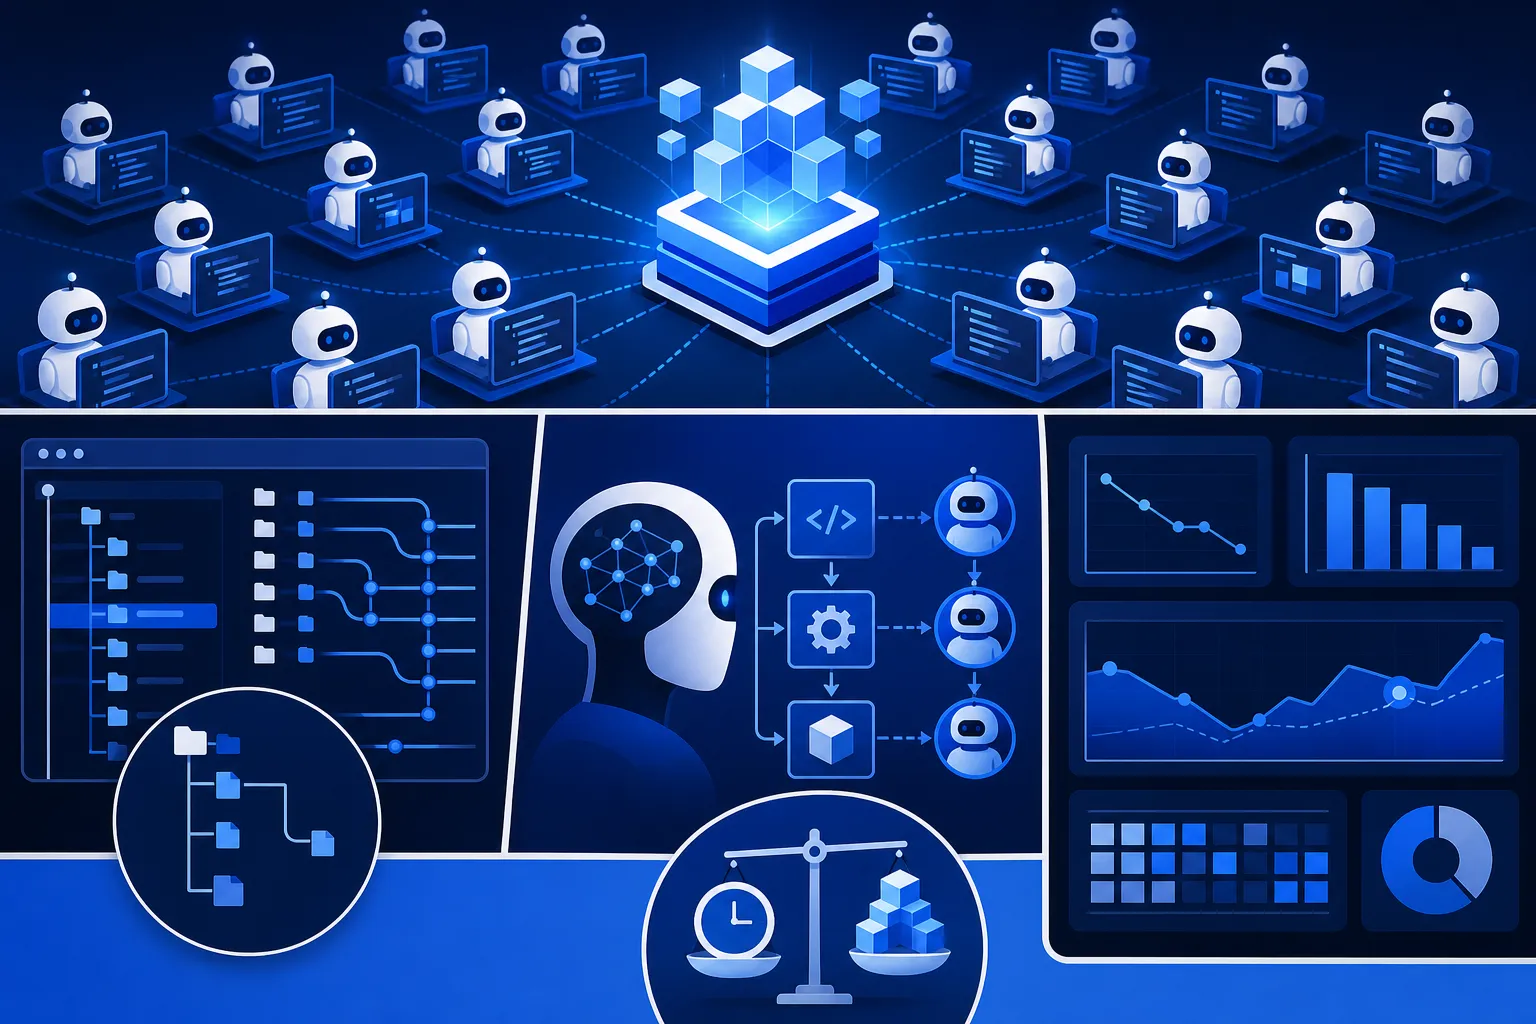
Odpalasz livediff w drugim oknie terminala i od tej chwili widzisz każdy zapis pliku na bieżąco, jako zwykły diff Gita, zamiast zsumowanego stanu, który pokazuje watch git diff. Liczy się kolejność: wyłapujesz moment, w którym agent poprawia funkcję, po 20 sekundach cofa własną poprawkę i pisze ją trzeci raz zupełnie inaczej. Narzędzie śledzi wyłącznie pliki znane Gitowi, więc build ani dociągane zależności nie zasypują okna tysiącem linii. Nie wie za to, kto zmianę wprowadził, i nie pokaże niczego sprzed uruchomienia.
 Premiera / Narzędzie
Sprzątanie miliona linii kodu za 19 300 dolarów. Regresje wyłapali ludzie.
4 min
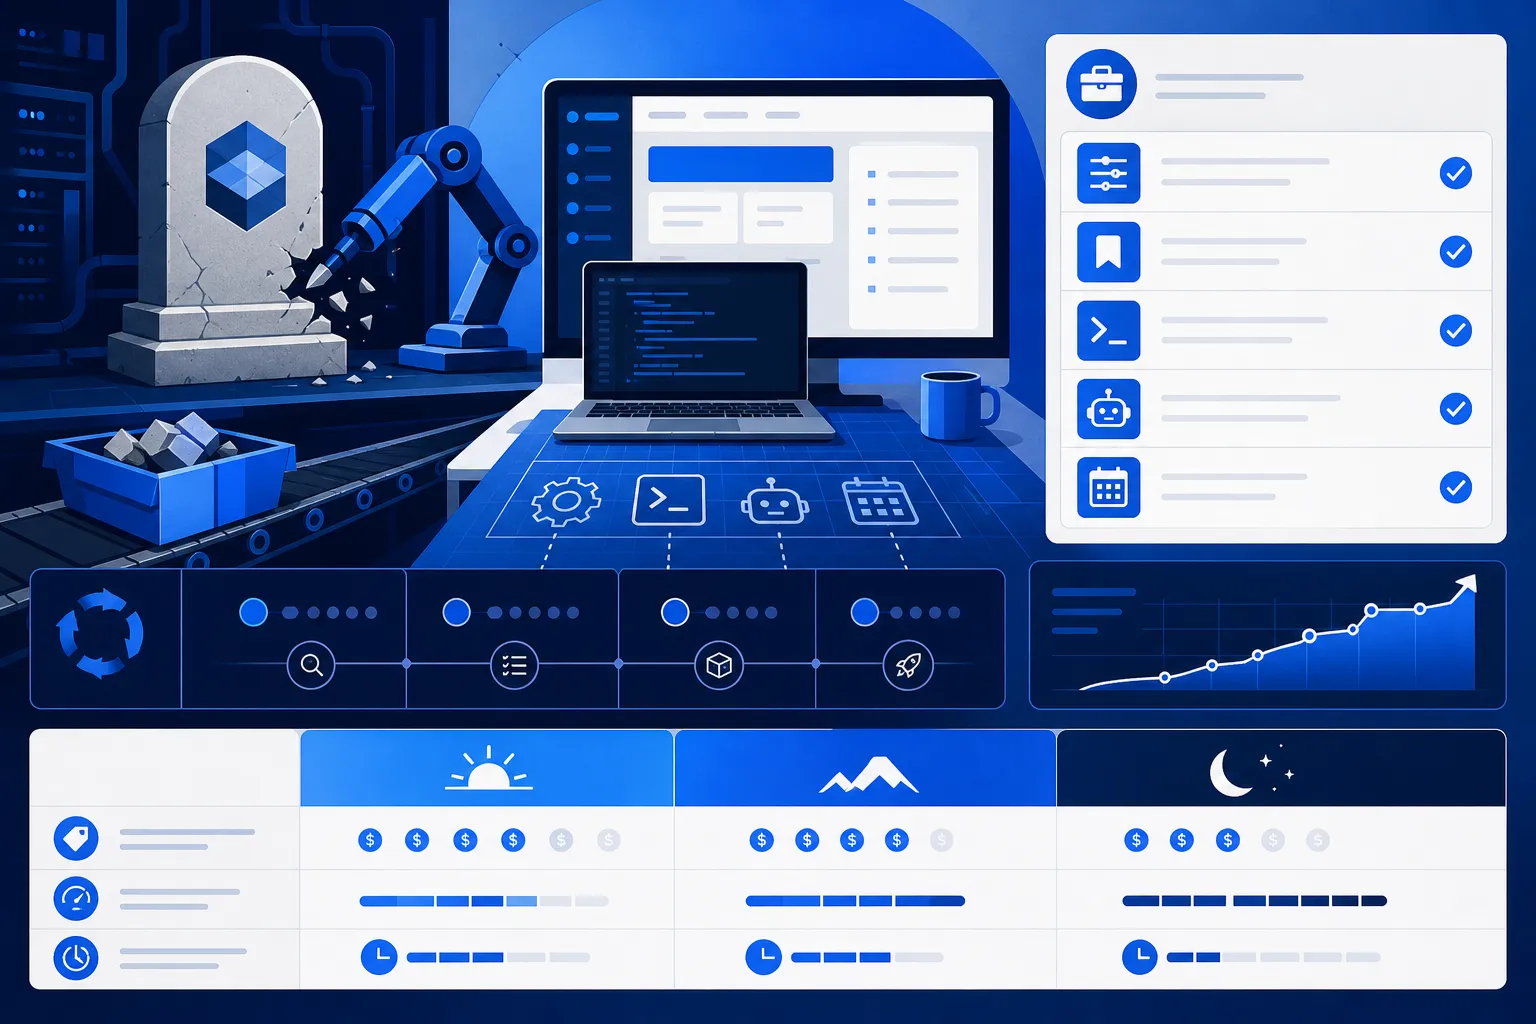
Nous Research puściło 1393 wykonawców swojego agenta Hermes na milion linii Pythona i w 19 godzin, za jakieś 19 300 dolarów w tokenach, skróciło kod o 34,4%. Kontrole oparto na tym, co maszyna porówna sama: niezmieniony schemat JSON narzędzi, wynik polecenia z flagą help bajt w bajt i zamrożoną listę testów, które sypały się już wcześniej. Dwóch regresji to nie złapało, bo agenty wycięły publiczne nazwy potrzebne wtyczkom i w około 65 miejscach zmieniły obsługę błędów, a wyłapały je dopiero dwie rundy przeglądu przez społeczność open-source.
 Premiera / Narzędzie
OpenAI zabiera GPT-5.5 i nie zostawia furtki dla spóźnialskich
4 min
Od 14 października GPT-5.5 przestaje odpowiadać w ChatGPT i w Codexie na wszystkich planach, ale wywołania przez API OpenAI działają dalej, więc zacznij od sprawdzenia, którędy twoje zadania wołają model. Podmiana na gpt-5.6-sol zajmuje chwilę, gorzej z miejscami, których nikt nie ogląda: zadaniem wrzuconym kiedyś do harmonogramu albo krokiem w CI z flagą --model gpt-5.5, bo takie wywołanie nie przełączy się po cichu, tylko wróci błędem. Sol jest o jedną trzecią tańszy na tokenach wyjściowych od modelu, który znika, tyle że ta promocyjna stawka obowiązuje tylko do 21 listopada.
 Premiera / Narzędzie
Agent przeszedł pilotaż. Co zrobi, gdy w połowie biegu wygaśnie klucz dostępu?
4 min
Diagrid wydał 17 września pięć kryteriów gotowości produkcyjnej dla agentów: wznawianie od miejsca awarii, dostęp, który nie wygasa w połowie biegu, idempotentność, kontrola tego, co oddaje model, i trwały zapis przebiegu. Każde jest pytaniem, na które odpowiada się logami, a nie akapitem w dokumencie projektowym. To klasyczne wzorce systemów rozproszonych, z jedną różnicą: ponowiony krok agenta może wybrać inne narzędzie i inny plan, więc nie jest tą samą operacją. Tyle że Diagrid sprzedaje dokładnie tę warstwę uruchomieniową, a kryteria wyszły komunikatem prasowym bez jednej liczby.
 Premiera / Narzędzie
Agent-Reach nie czyta za ciebie internetu, tylko pilnuje, którędy da się do niego wejść
4 min
Agent-Reach, projekt jednego dewelopera, przez dobę wisiał na szczycie trendów GitHuba, choć sam nie pobiera ani jednej strony: trzyma uporządkowaną listę dróg dostępu do każdej platformy, z wariantami zapasowymi. Gdy w czerwcu Bilibili zaczęło odpowiadać kodem 412 na zapytania yt-dlp, wystarczyło przestawić kanał na bili-cli. Sześć kanałów działa bez konfiguracji, ale Reddit i X wymagają oddania skryptowi ciasteczka z zalogowanej sesji, więc autor radzi używać konta pomocniczego. Kupujesz tu czyjąś uwagę, bo gdy autor przestanie testować, lista dalej poda martwe drogi jako pierwszy wybór.
 Premiera / Narzędzie
Cloudflare otworzył swojego audytora bezpieczeństwa i zabronił mu wierzyć samemu sobie
4 min
Cloudflare wyłożył na GitHubie security-audit-skill, zestaw instrukcji na licencji MIT, który zamienia agenta kodującego w zespół audytorów, gdzie ten, kto znalazł dziurę, nie ma prawa jej potwierdzić, bo do sprawdzenia rusza świeży agent z zadaniem odwrotnym: obalić ustalenie. Pilnuje tego rejestr pokrycia i walidator w Node, dzięki czemu nic nie trafia do wyników bez wskazania miejsca w kodzie, a bez piaskownicy audyt kończy się na hipotezach. Pojedynczy bieg znajduje mniej więcej połowę tego, co wszystkie razem, więc to raczej dodatkowa para oczu przed wydaniem niż bramka w CI.
 Premiera / Narzędzie
Fork Claude Code, który zdradza się już pierwszą zmienną środowiskową
4 min
OpenClaude to fork Claude Code, który po ustawieniu zmiennej CLAUDE_CODE_USE_OPENAI kieruje tego samego terminalowego agenta do ponad 20 dostawców modeli, z lokalną Ollamą włącznie, więc próg wejścia spada do zera. Narzędzia do plików, strumieniowanie i MCP zostają nietknięte, zmienia się tylko to, kto odpowiada po drugiej stronie. README przyznaje, że jakość pracy narzędziami zależy od wybranego modelu, a mniejsze modele lokalne gubią się w długich ciągach wywołań, czyli tam, gdzie agent ma pracować. Pochodzenie zdradza flaga tengu_hive_evidence, od wewnętrznej nazwy kodowej Claude Code.
Model / Badania · 5
 Model / Badania
Gemini 3.8 Live mówi dalej, kiedy myśli
4 min
Google wypuścił 15 września dwa modele głosowe, Gemini 3.8 Live do taniej obsługi dużego ruchu i wersję Extended Thinking, która rozumuje i mówi równocześnie, dzięki czemu rozmowa nie zamiera na czas wywołania narzędzia. Extended Thinking prowadzi w rankingu jakości rozmów Artificial Analysis z wynikiem 82,6 punktu, ale w bankowym wariancie testu agentowego τ-Voice domyka tylko 35,1% spraw, czyli dwie na trzy nie dochodzą do finału. Cennika Google nie podał, a przy rozmowie na żywo płaci się za godziny dźwięku, więc akurat ta liczba decyduje o sensie agenta na infolinii.
 Model / Badania
DeepSeek wygasza własnego flagowca, bo tańszy model wypada lepiej
3 min
DeepSeek od zeszłego poniedziałku przekierowuje ruch z flagowego V4-Pro na tańszy V4.1-Flash i rozlicza go po niższych stawkach, więc w konfiguracji masz jeden model, a odpowiada inny. Firma tłumaczy to wynikami: 90,6 punktu na Terminal-Bench 2.1, prawie dwa oczka przed GPT-5.6 Sol i trzy przed własnym V4-Pro, przy pamięci ściętej z 3514 do 890 bajtów na token. Przy agencie, który pracuje godzinami nad jednym zadaniem, to właśnie pamięć bywa największą pozycją rachunku, więc czterokrotna oszczędność waży więcej niż miejsce w rankingu. Tyle że tabelkę mierzył sprzedawca, a wyboru już nie ma.
 Model / Badania
Model mieści się na laptopie, ale nie uruchomisz go na zwykłym llama.cpp
3 min
PrismML wypuścił 17 września Bonsai 2 27B, czyli model Alibaby ściśnięty do 5,9 GB z deklarowaną stratą 1,8% na benchmarkach, bo każda waga przyjmuje w nim już tylko trzy wartości zamiast szesnastobitowej liczby. Brakujący punkt procentowy jest tu najmniej ciekawy: prawdziwą przeszkodą jest to, że główna gałąź llama.cpp tego formatu nie obsługuje, więc do czasu przyjęcia poprawki trzeba korzystać z forka PrismML. Domyślna instalacja waży zresztą 7,8 GB razem z modułem do obrazów, a długa rozmowa w oknie 256 tysięcy tokenów potrafi zająć w pamięci więcej miejsca niż sam model.
 Model / Badania
Model przepisuje 90% migracji i dostaje za to zero punktów
4 min
Google przebudował Android Bench od podstaw: zamiast drobnych poprawek mierzy zadania, nad którymi inżynier siedzi kilka dni, a wynik podaje jako ciągły wskaźnik ukończenia. Czołówka, która na poprzedniej wersji meldowała ponad 90%, zjechała do 28% dla prowadzącego GPT-6 Astra, czyli tą samą drogą co wcześniej przy SWE-Bench Pro. Przepisywanie z Javy na Kotlina modele robią gładko, ale przeniesienia aplikacji wieloplatformowej na natywnego Androida nie domknął żaden. Oceniany jest przy tym model razem z harnessem, więc różnica między wierszami tabeli nie musi być różnicą między modelami.
 Model / Badania
Jedenaście plików GGUF i ani jednego pomiaru
4 min
Empero wrzucił na Hugging Face destylat Qwen3.8-35B-A3B w wersjach od 12,6 GB po pełne 71 GB, a zalecany czterobitowy plik waży 21,7 GB i mieści się na karcie z 24 GB pamięci albo w 32 GB RAM-u. Przy każdym tokenie pracuje tylko około 3 miliardów z 35 miliardów wag, dzięki czemu odpowiedzi lecą szybciej, niż sugeruje rozmiar, ale cały plik i tak musi wejść do pamięci, bo router sięga w każdej chwili po dowolny z 256 fragmentów. Karta nie podaje ani jednego pomiaru, więc dopóki nie przepuści tego ktoś przez niezależny benchmark, destylacja pozostaje zapowiedzią wydawcy, a nie faktem.
Bezpieczeństwo · 2
 Bezpieczeństwo
Zdjęcie z iPhone'a otworzyło drogę do wewnętrznego repozytorium OpenAI
5 min
Trzech badaczy z Hacktronu wrzuciło na forum pomocy OpenAI spreparowane zdjęcie HEIC i w niecałe 72 godziny dotarło od błędu w nieaktualnej bibliotece libheif do pull requesta w wewnętrznym repozytorium openai/openai. Żaden z trzech zamków nie puścił przez lukę w modelu, tylko przez wspólne logowanie rozciągnięte z forum na narzędzia wewnętrzne i konto AI podpięte do firmowego GitHuba. Claude Opus 5 skrócił jedynie najdroższy etap, czyli napisanie działającego kodu ataku, dzięki czemu dwa miesiące polowania zamknęły się kwotą poniżej 3000 dolarów, a zgłoszenie przyniosło 6500 dolarów.
 Bezpieczeństwo
14 serwerów MCP na jednym laptopie. Dopiero skaner pokazał, co potrafią.
5 min
Walden Wu przeskanował własny laptop i naliczył 14 serwerów MCP oraz pięć kluczy API leżących otwartym tekstem w konfiguracji, choć nikt się do niego nie włamał. Tak mu to narosło samo. Dwie niezależne implementacje, system zgłoszeń Christopha Hermannsa i ubezpieczeniowy serwer Juana Llamazaresa, rozbrajają to ryzyko identycznie: w kodzie zwyczajnie nie ma ścieżki zapisu, a osiem narzędzi Llamazaresa obudowano 44 testami. Skłaniam się ku tej amputacji, bo Digital Realty sprzedaje tymczasem MCP jako warstwę sterowania 800 centrami danych i o samym odczycie nie wspomina ani razu.
Poradnik / Praktyka · 4
 Poradnik / Praktyka
Instrukcje pisane pod słabszy model dziś kosztują cię kontekst
4 min
OpenAI przekonuje deweloperów, że instrukcje pisane pod słabszy model przy GPT-6 Astrze zaczynają działać przeciwko tobie, bo zjadają kontekst i ciągną agenta tam, gdzie już go nie chcesz. Stąd rada, żeby skrócić opisy skilli, zamienić rozdęty AGENTS.md w drogowskaz do reszty i wyciąć przepisy krok po kroku, z którymi Astra radzi sobie sama. Mocne "pytaj, zanim cokolwiek zrobisz" zostawiam tam, gdzie jest, bo nadgorliwy agent kosztuje 30 sekund, a przekonany o własnej racji cały wieczór odkręcania. A skille w repozytorium sterują też agentami współpracowników, którzy pracują na innym modelu.
 Poradnik / Praktyka
Opus 5 bierze "bądź zachowawczy" dosłownie i przemilcza część błędów
4 min
Anthropic ostrzega w przewodniku po promptowaniu Opus 5, że dopisane kiedyś do promptu "bądź zachowawczy" nowy model bierze dosłownie i razem z hałasem przemilcza część prawdziwych błędów. Parametr effort tnie czas myślenia, ale nie długość odpowiedzi, więc o zwięzłość trzeba poprosić wprost. Przy wyłączonym myśleniu model potrafi napisać coś, co wygląda na wywołanie narzędzia, choć nic się nie uruchomiło, a taki zapis zostaje w historii rozmowy i kolejne tury czytają go jak fakt. Bezpieczniej zostawić myślenie włączone i ciąć koszt niższym ustawieniem effort.
 Poradnik / Praktyka
Recenzent nie pomylił się ani razu i to był problem
5 min
Automatyczny recenzent Codex w projekcie AgentCoop nie pomylił się ani razu, a mimo to sześć rund recenzji rozdęło funkcję z 28 do 42 linii, bo zasada „każda uwaga załatwiona przed mergem” po cichu zmieniła się w „każdą poprawiamy”, a tak kończyło się 91% uwag. Zespół odpowiedział procedurą liczącą koszt w godzinach zamiast etykietek P1 i P2 oraz skryptem chain-check, który zatrzymuje pracę, gdy dwie rundy z rzędu trafiają w kod napisany pod wcześniejszą uwagę tego samego recenzenta. Arytmetyki nie kupuję, ale ktoś wreszcie spisał drugą stronę rachunku, czyli to, co naprawdę traci użytkownik.
 Poradnik / Praktyka
Trzy wymagania, dwie asercje i poprawka, która wygląda poprawnie
4 min
Poprawka jednym warunkiem zapala dwie asercje na zielono, ale kasuje trzeci punkt kontraktu, bo Python traktuje None i pustą listę tak samo. Człowiek taki wynik najwyżej przeoczy, natomiast agent naprawczy zbiega do testu zamiast do wymagania, więc odwrotnie napisana asercja potrafi go skłonić do zepsucia działającego kodu. W preprincie ExecCritic ten sam agent rozwiązywał 61,2% zadań z SWE-bench Verified, a ze słabszymi wygenerowanymi testami osuwał się do 57,3%, przy nierównych budżetach obliczeniowych. Stąd jedno pytanie do każdego testu: którą błędną implementację odrzuci.
Analiza / Opinia · 3
 Analiza / Opinia
AI oszczędza 13 godzin tygodniowo, z których nie wraca ani jedna
4 min
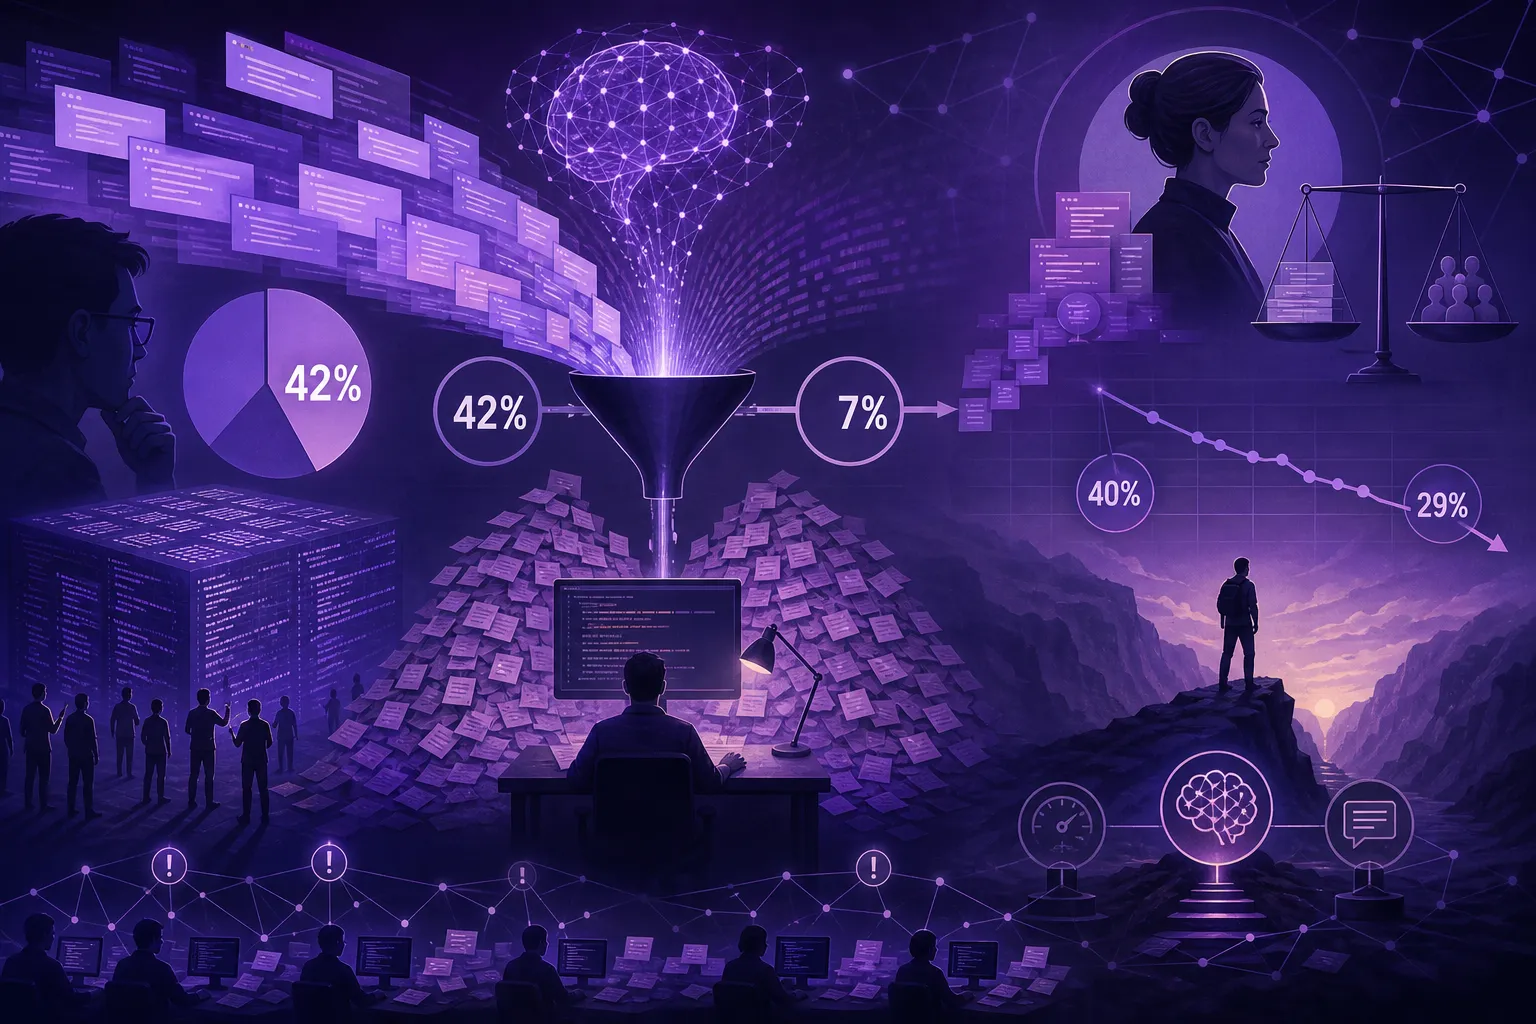
Ankieta BairesDev za trzeci kwartał 2026 pokazuje, że AI oszczędza programistom już 13 godzin tygodniowo zamiast siedmiu rok temu, tylko że, jak przyznaje Darren Shimkus, nie wróciła z nich ani jedna. Godziny przeszły na przeglądanie kodu z modelu, szukanie w nim błędów i naukę narzędzi, która zjada dziś dziewięć godzin tygodniowo. Co najmniej połowę kodu oddaje maszynie 42% badanych, ponad trzy razy więcej niż rok wcześniej, a 58% czuje większą odpowiedzialność za kod, którego samo nie napisało. Ankietę zamówiła firma wynajmująca programistów, więc procenty czytałbym jako odczyt tendencji.
 Analiza / Opinia
Agenty lepiej łatają cudzy kod, niż dopisują brakującą funkcję
3 min
Claude Opus 4.5 zamyka 74,4% zadań na SWE-bench, a na nowym benchmarku FeatureBench dowozi 11%, choć model jest ten sam i zmieniło się tylko to, o co go poproszono. Qixing Zhou i współautorzy, w pracy zgłoszonej na ICLR 2026, wycięli z 24 repozytoriów open-source kod stojący za wybranymi testami, tak że agent ma odtworzyć brakującą funkcję bez wskazanego miejsca i bez gotowych granic zmiany. Agenty domykają pętlę, którą ktoś już otworzył i opisał, a dużo gorzej radzą sobie z wykrojeniem zadania od zera. Ostrożnie z tą liczbą, bo trudność dziur ustawia sam twórca benchmarku.
 Analiza / Opinia
Agenty gubią się w cudzym systemie, nie w składni
4 min
Real-SWE mierzy agenty na produkcyjnym kodzie licencjonowanym od prawdziwych firm, którego nie było w danych treningowych, i wyszło z tego 640 przebiegów ze średnią 26,9%, przy najlepszym wyniku 38,8% dla Fable 5.1 w Claude Code. Z 468 porażek tylko 5,1% to zepsuty kod, a 40,6% to pominięty wymóg, czyli instrukcja, której agent nie doczytał do końca. Kolejność w tabeli i tak niewiele znaczy, bo przedziały ufności czołówki nachodzą na siebie, a każdy model biegł w harnessie swojego producenta. Jedyna liczba, która cokolwiek rozstrzyga, to ta zmierzona na twoim repozytorium.