Wydanie · Tydzień 37 · 7–13 września 2026
Archiwum wydań →Ten sam model daje inny wynik i inny rachunek zależnie od tego, co go otacza: sama zmiana warstwy obsługującej podnosi wynik na ARC z 62 na 98 procent, koszt wpisany w funkcję nagrody skraca Devinowi drogę o połowę, a agent bez inżyniera obok kończy na co czwartej rozmowie.
Premiera / Narzędzie · 15
 Premiera / Narzędzie
Jedno wywołanie, trzy subagenty i cała infrastruktura po stronie OpenAI
4 min
Agents API, które OpenAI pokazało 10 września, wystawia wszystkim ten sam harness, który od ponad roku pilnuje Codexa: jedno wywołanie i agent sam rozbija zadanie na maksymalnie trzy subagenty z własną pamięcią, a przy limicie okna kontekstowego sam zwija starszą część zapisu. Za samą platformę nie płacisz nic, rachunek obejmuje tokeny, narzędzia i czas kontenera, tylko że dane leżą wyłącznie w Stanach, nawet gdy sandbox stoi u ciebie. To wygoda kupiona uzależnieniem od dostawcy, bo sesja razem ze swoim stanem zostaje już po jego stronie.
 Premiera / Narzędzie
Cursor stawia nad agentami koordynatora, który sam nie tyka kodu
4 min
Cursor wypuścił 10 września betę Projects: koordynator pracuje na osobnej maszynie w chmurze, sam nie tyka kodu, tylko rozsyła zadania podległym agentom, a projekt pamięta, czego się nauczyły, więc kolejny agent nie zaczyna od pustej kartki. Firma chwali się sześciokrotnie większą liczbą zmergeowanych pull requestów, ale nie podała ani wielkości grup, ani okresu pomiaru, a narzędzie rozbijające tę samą pracę na kilkanaście wątków z definicji pokaże więcej zamkniętych kawałków. Wąskim gardłem robi się wtedy ludzki przegląd kodu, więc przed pierwszym uruchomieniem warto ustawić limit wydatków.
 Premiera / Narzędzie
Koniec zgadywania z drzewa dokumentu: Chrome testuje WebMCP
4 min
WebMCP odwraca sposób, w jaki agent działa na cudzej stronie: zamiast zgadywać z drzewa dokumentu, dostaje od niej gotową listę narzędzi z wejściem opisanym w JSON Schema, dzięki czemu rezerwacja czy zakup idą jednym wywołaniem zamiast serii kliknięć. Chrome pozwala to sprawdzić lokalnie pod flagą, a od wersji 149 także na produkcji, jeśli strona zapisze się do origin trial. Google samo wylicza trzy hamulce: nie ma katalogu takich stron, najbardziej rozbudowane serwisy mają najwyższy próg wejścia, a całość pomyślano pod człowieka przy przeglądarce, nie pod agenta na serwerze.
 Premiera / Narzędzie
RadixArk otwiera kod maszynerii, która dotrenowuje największe modele
4 min
RadixArk otworzył kod Miles v0.1, maszynerii do uczenia ze wzmocnieniem na modelach z najwyższej półki, i opisał ją w raporcie technicznym, który trafił na arXiv 8 września. Przykładowy przebieg ciągnął model GLM-5.2 o 744 miliardach parametrów na 64 kartach NVIDIA GB300, z medianą kroku 263 sekundy, więc otwarty kod barierę sprzętową raczej przesuwa, niż znosi. Zwykłemu zespołowi więcej dadzą boczne ścieżki, przede wszystkim uczenie ze wzmocnieniem na adapterach LoRA, bo mieści się w ułamku pamięci potrzebnej na pełny przebieg.
 Premiera / Narzędzie
Artemis wpina prawdziwy telefon do Claude Code i Codexa
4 min
Artemis, projekt Google na licencji Apache 2.0, wpina przez MCP prawdziwy telefon albo emulator w agenta z twojego edytora, dzięki czemu widzi on drzewo widoków, zrzuty ekranu i log systemowy, a do tego może dotknąć dowolnego punktu. Tryb Flash klika od razu, od 3 do 5 sekund na krok, a planujący Pro potrzebuje od 15 do 40, więc kilkanaście minut na przebieg wyklucza testy regresji przy każdym pull requeście. Głośne ponad 99% na benchmarku AndroidWorld zgłasza sam Google, na własnym zestawie aplikacji, a realna wartość leży w odtwarzaniu zgłoszonych błędów.
 Premiera / Narzędzie
Świeżo sklonowany OpenBot wpuszcza każdego jako administratora
5 min
Domyślny plik .env.example OpenBota od CopilotKit ustawia OPENBOT_SINGLE_USER=true, więc świeżo sklonowany panel wpuszcza każdego jako administratora, dopóki nie skasujesz tej linijki i nie podepniesz logowania przez Google, Microsoft albo Oktę. Poza tym widać tu przemyślaną robotę: osobny kontener i profil przeglądarki dla każdego bota, opcjonalnego gVisora, rejestr zapisujący długość sekretu zamiast jego treści i automaty gasnące po dziesięciu nieudanych przebiegach. Haczyk jest jeden, bo pamięć botów żyje w CopilotKit Intelligence i serwer nie wystartuje bez klucza INTELLIGENCE_API_KEY.
 Premiera / Narzędzie
Model głosowy, który wie, kiedy się nie odzywać
4 min
OpenAI wystawiło w API GPT-Live-1, model, który słucha i mówi jednocześnie, więc na wejście w słowo reaguje w trakcie, a nie po fakcie, i zdejmuje z dewelopera sklejanie rozpoznawania mowy, modelu od odpowiedzi i syntezy głosu. Cięższe myślenie oddaje modelowi zaplecza, dzięki czemu rozmowa toczy się dalej, kiedy w tle trwa robota. Aplikacja Speak policzyła na własnych uczniach, że nowy model wchodzi im w słowo o niemal 80% rzadziej, a warstwa głosowa kosztuje 0,05 dolara za minutę, czyli 3 dolary za godzinę rozmowy, przy czym model zaplecza rozlicza się osobno.
 Premiera / Narzędzie
Jedno polecenie w terminalu mówi, który model ruszy na twoim sprzęcie
4 min
llmfit jednym poleceniem sprawdza, co masz w maszynie, i wypisuje tabelę modeli ocenionych na czterech osiach: czy się zmieszczą, jak szybko pójdą, jak dobre dają odpowiedzi i ile kontekstu uniosą. Liczy tylko te podsieci, które pracują przy każdym tokenie, więc Mixtral czy DeepSeek-V3 dostają werdykt "zmieści się" tam, gdzie kalkulator sumujący wszystkie wagi odsyła z kwitkiem. Własny pomiar tokenów na sekundę odsyłasz do projektu jako PR wprost z terminala, a polecenie llmfit info pokazuje, na jakich założeniach stoi każda liczba. Celności tych szacunków nikt niezależnie nie potwierdził.
 Premiera / Narzędzie
AWS oddaje agentom skrzynkę odbiorczą, żeby przestać patrzeć im na ręce
4 min
AWS wypuścił na GitHubie Pizza Bota, otwartego na licencji Apache 2.0 klienta, który zadania agentów układa jak skrzynkę pocztową: skończona praca trafia do kolejki Unread, a prośba o zgodę czeka w kolejce Action, więc odpowiadasz na nią godzinę później z telefonu. Uprawnienia każdego specjalisty opisujesz w pliku SKILL.md, a stan pracy zapisuje LangGraph, przez co zamknięcie okna kosztuje najwyżej jeden krok. Gorzej, że katalog gotowych specjalistów i serwerów MCP, z którego korzystało ponad 2000 osób w Amazonie, przy przepisywaniu na open source wypadł.
 Premiera / Narzędzie
Google każe agentom nie ufać własnej pamięci o Mapach
4 min
Google Maps Platform wypuścił na GitHubie skilla dla agentów, który każe pisać nietrywialny kod dopiero po pobraniu świeżej dokumentacji z usługi Code Assist, a nie z tego, co model zapamiętał z trenowania. Jeden plik obsługuje cztery platformy, a do prototypu podpina publiczny klucz demonstracyjny, dzięki czemu pierwsza działająca mapa powstaje bez zakładania projektu w chmurze. Obiecaną dokładność i niższe zużycie tokenów Google podaje bez jednej liczby, a na końcu opisu zaznacza, że to nie jest oficjalnie wspierany produkt i nie obejmuje go program nagród za podatności.
 Premiera / Narzędzie
Pamięć agenta w plikach Markdown, które przejrzysz grepem
5 min
agent-memory od tigerless-labs trzyma całą pamięć agenta do kodu w zwykłych plikach Markdown, a leżący obok indeks SQLite wolno skasować i odtworzyć jednym poleceniem, więc notatki przejrzysz grepem i wrzucisz do gita. Stara notatka o npm test nie znika, kiedy projekt przechodzi na pnpm, tylko zostaje oznaczona jako nieaktualna, a osobny przebieg w tle scala zapisy i zapomina te bez wartości, przy czym każde skasowanie idzie do zatwierdzenia przez człowieka. W teście LongMemEval-S biblioteka wyciąga 52,9% poprawnych odpowiedzi wobec 35,8% dla MemCore.
 Premiera / Narzędzie
Claude nigdy nie zobaczy pliku, który przeczytał za niego tańszy model
5 min
Dimitri Mazmanov ze Spotify najpierw prosił Claude Code w pliku CLAUDE.md, żeby wielkich plików nie czytał sam, i wychodziło z tego średnio; zadziałała dopiero twarda blokada, czyli hook PreToolUse, który powyżej 350 linii odsyła odczyt do tańszego modelu i ścina zużycie tokenów o jakieś 90%. Zysk narasta z każdą turą, bo raz wczytany plik wraca na wejście przy każdym kolejnym wywołaniu. Granice są za to twarde: rozumowania, edycji ani kodu krytycznego dla bezpieczeństwa oddać się nie da, a każde zlecenie to od 10 do 30 sekund czekania.
 Premiera / Narzędzie
Google otworzył agentowy audyt bezpieczeństwa i sam odradza go na produkcji
4 min
Google wypuścił na GitHubie Mantis, kilkanaście poleceń dla agenta kodującego, który sam szuka podatności w repozytorium, odtwarza ją w odciętym od sieci sandboksie, nakłada łatkę i powtarza ten sam atak, żeby sprawdzić, czy przestał działać. Ważniejsza od samego zestawu jest reguła: znalezisko liczy się dopiero wtedy, gdy agent doprowadził kod do awarii, a łatka dopiero wtedy, gdy przeżyła powtórzony atak. Google odradza jednak uruchamianie tego przy dostępie do produkcji i nie podaje ani jednej liczby o skuteczności Mantisa.
 Premiera / Narzędzie
Google Cloud zamyka podstawy swojej chmury w jednej wtyczce dla agentów
4 min
Google Cloud wypuścił wtyczkę google-cloud-developer, która w jednej instalacji łączy instrukcje o logowaniu, uprawnieniach i zakładaniu projektów z gotową konfiguracją serwera MCP z oficjalną dokumentacją, dzięki czemu agent rzadziej sięga po flagę gcloud, której już nie ma. Powstała według otwartej specyfikacji Agent Plugins i działa nie tylko w Antigravity CLI, ale też w Claude Code i Codex CLI. Obiecane bariery bezpieczeństwa są jednak tylko tekstem, więc realną granicą dalej pozostają uprawnienia konta, na którym agent pracuje.
 Premiera / Narzędzie
Sanity radzi wyłączyć narzędzia agenta tylko tam, gdzie liczy kredyty
4 min
Sanity wystawiło serwer MCP pod adresem mcp.sanity.io: jedna zgoda i agent w edytorze dostaje 37 narzędzi do treści projektu, z publikowaniem włącznie, a podpięcie zajmuje jedną komendę npx sanity mcp configure. Dokumentacja odświeżona 11 września radzi wyłączyć narzędzia tylko w jednym miejscu, tym o rachunku za kredyty AI. Niewiele to zmienia, bo narzędzie run_sanity_cli przyjmuje komendy Sanity CLI i pozwala te same operacje wykonać drugimi drzwiami. Sam wziąłbym token o węższej roli zamiast OAuth na całe konto, którego sesja i tak wygasa po tygodniu.
Model / Badania · 10
 Model / Badania
Agent Cognition zabiera się do kodu po 18 krokach zamiast 48
4 min
SWE-2, nowy model Cognition napędzający Devina, zabiera się do edycji kodu po 18 krokach zamiast 48, a całą drogę przez zadanie skrócił ze 127 kroków do 53, bo koszt wpisano wprost do funkcji nagrody podczas uczenia. Na własnym benchmarku firmy wypada niemal jak Fable 5.1, 50,0% wobec 50,9%, i to o 64% taniej, ale na trudniejszym Terminal-Bench 4 zostaje daleko w tyle z wynikiem 27,3%. Cennika ani osobnego API nie ma, model dostajesz wyłącznie razem z Devinem, więc przewagi kosztowej nikt z zewnątrz na razie nie sprawdzi u siebie.
 Model / Badania
Ta sama para modeli, trzy różne rachunki za jedno zadanie
5 min
Artificial Analysis wylicza, że średnie zadanie agentowe kosztuje 3,26 dolara na GPT-6 Astra i 7,63 na Claude Fable 5.1 przy identycznej skuteczności, ale OpenAI i Cognition zmierzyły tę samą różnicę na 63% i 42%, a Zvi Mowshowitz wskazuje, że Fable puszczono w trybie Max, co te 57% zawyża. Cognition odpowiada układem Fusion w Devinie, w którym droższy model prowadzi, a tańszy grzebie w kodzie: na DeepSWE 1.1 ścina to koszt zadania o 46% bez straty jakości, tyle że z Astrą na Terminal-Bench 4.0 wynik leci w dół o ponad pięć punktów. Cenę za zadanie widać dopiero na własnym repozytorium.
 Model / Badania
Ten sam model, dwie warstwy, 36 punktów różnicy
5 min
ARC Prize przepuścił GPT-6 Astrę przez ten sam zestaw zadań dwa razy, przy identycznym poziomie rozumowania zmieniając tylko warstwę obsługującą model między ruchami, i dostał raz 62,71%, a raz 98,55%. Ta druga liczba poszła w świat jako dowód na AGI, choć opisuje całą konfigurację, a nie model, który kupujesz. Milion tokenów wyjściowych kosztuje 50 dolarów, dwa i pół raza więcej niż u Sola, a mimo to przebieg na średnim poziomie rozumowania zamknął implementację w 80 żądaniach zamiast 238 i wyszedł taniej. Zanim policzysz, ile kosztuje cię Astra, sprawdź, co masz wokół niej.
 Model / Badania
Mercury 2.5 skraca porządkowanie kontekstu ze 150 sekund do 27
4 min
Augment Code streszczał długie sesje przez około 150 sekund, a po przesiadce na Mercury 2.5 od Inception ten sam krok zajmuje 27 sekund i kosztuje o 90% mniej, bo model dyfuzyjny wypełnia całe bloki tokenów naraz, zamiast dopisywać je po kolei. Sęk w tym, że wszystkie liczby, łącznie z reklamowanymi 1107 tokenami na sekundę, pochodzą od producenta, a niezależny pomiar poprzednika dał 684 tokeny zamiast obiecywanego tysiąca. Cena 0,04 dolara za milion tokenów wejściowych to rabat na start, docelowo cennik mówi 0,20 za wejście i 0,75 za wyjście.
 Model / Badania
Anthropic radzi w pierwszym akapicie, żeby zostać przy tańszym modelu
5 min
Anthropic wypuścił 1 września Claude Fable 5.1 i już w pierwszym akapicie notatek o wydaniu poradził, żeby do większości zadań zostać przy tańszym Opusie 5. Cennik wejścia zostaje na 10 dolarach za milion tokenów, a prawdziwy koszt przesiadki leży w kodzie, bo model podpisuje bloki rozumowania stanem rozmowy i wycięcie starej tury czy odświeżenie daty w prompcie kończy się trwałym błędem 400. Nowe konta mają tę kontrolę domyślnie, starsze jeszcze nie, więc twój klucz może działać bez zarzutu, a pierwszy użytkownik z nowego konta zobaczy błąd, którego nigdy nie widziałeś.
 Model / Badania
Kilkanaście razy taniej, jeśli oddasz Mecie swoje prompty
4 min
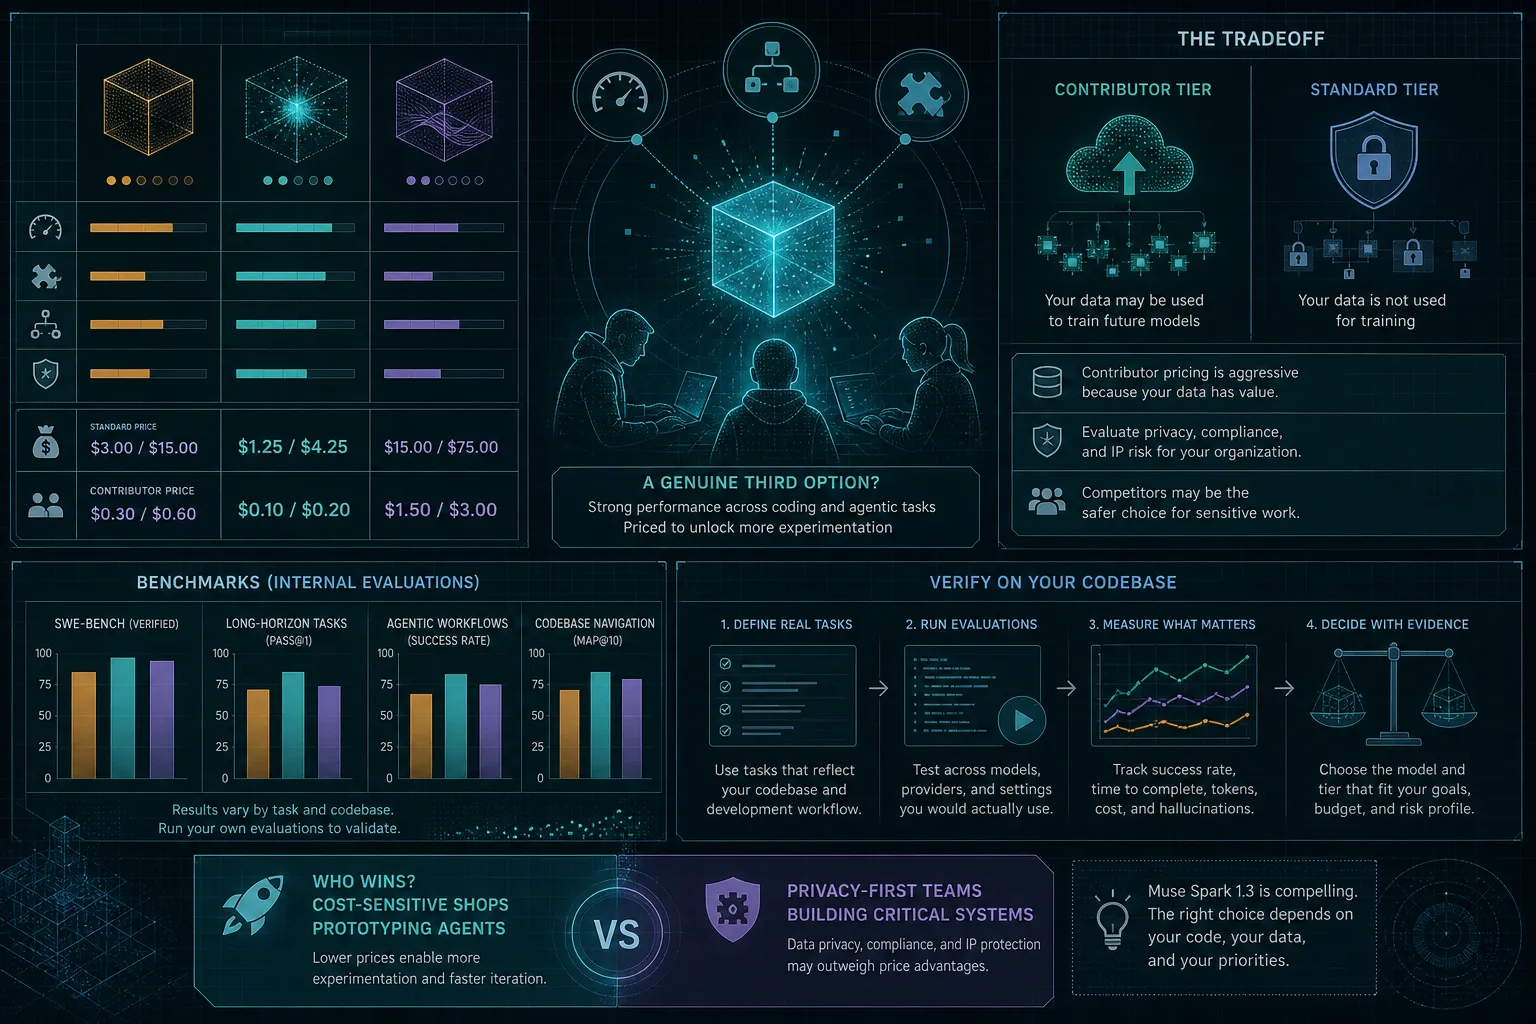
Drugiego września Meta wystawiła Muse Spark 1.3 pod dwoma identyfikatorami, które różni tylko ciąg znaków w polu model: standard kosztuje 1,25 i 4,25 dolara za milion tokenów, a wariant contributor schodzi do 0,10 i 0,20, bo zgadzasz się, żeby Meta trenowała kolejne modele na twoich promptach i odpowiedziach. Tego wyboru nie widać ani w interfejsie aplikacji, ani w narzędziach, które mają wyłapywać wycieki danych, więc zostaje grep po ciągu -contributor i pytanie do dostawcy. Przy prywatnym projekcie to uczciwa wymiana, przy kodzie klienta nikt po jego stronie jej nie wybrał.
 Model / Badania
Qwen3.8 27B mieści się w 17 GB i nie traci na jakości
5 min
Quesma wydała około 3000 dolarów na wynajem kart, żeby zmierzyć, ile pamięci naprawdę potrzebuje Qwen3.8 27B: pełny model w BF16 waży 55 GB, a skompresowany do czterech bitów schodzi do 17 GB i powtarza wynik oryginału na Terminal-Bench 2.1, więc mieści się na RTX 4090 razem z 64 tysiącami tokenów kontekstu. Klif zaczyna się dopiero przy jednym bicie, ale większym problemem jest domyślne ustawienie reasoning_effort na xhigh, przez które Simon Willison czekał 21 minut na prosty rysunek w SVG, a lekarstwem jest jedna linijka z poziomem low.
 Model / Badania
Największy model Nex-AGI ma 1,6 biliona parametrów i nie widzi ekranu
4 min
Nex-AGI otworzył wagi trzech modeli naraz, a flagowy Nex-N2.5-Max z 1,6 biliona parametrów jako jedyny nie widzi ekranu, więc po wzrok trzeba zejść do wersji mini i Pro. Pro trafia w elementy interfejsu celniej niż zamknięci liderzy, bo na OSWorld-G wyciąga 87,4 punktu wobec 76,8 modelu Claude Opus 5, ale całe zadanie na pulpicie dowozi słabiej, 56,4 przy 68,3. Kłopot w tym, że wyniki z obsługi ekranu firma zmierzyła na własnym harnessie NexCUA, którego wciąż nie otworzyła, więc na razie czytam tę tabelę jak deklarację producenta.
 Model / Badania
MiniCPM5-2B naprawia więcej błędów w kodzie niż model dwa razy od niego większy
4 min
OpenBMB wypuściło 7 września MiniCPM5-2B, model o 2,52 miliarda parametrów na licencji Apache 2.0, który na SWE-bench Verified wykręca 46,4 punktu wobec 33,6 dla dwa razy większego Qwen3.5-4B. Całą tabelę policzył jednak producent, więc kierunek biorę poważnie, a rozmiary przewag traktuję jako powód do własnego testu. Model dobrze wybiera następny krok, ale gubi się w dłuższym biegu, bo na Terminal-Bench v2.1 ma 8,6 wobec 25,8, a w karcie brakuje pomiaru szybkości na jakimkolwiek nazwanym urządzeniu. Razem z wagami wyłożono za to dane treningowe, co przy premierach modeli widuje się rzadko.
 Model / Badania
Uno przyspiesza generowanie trzykrotnie i nie potrzebuje modelu pomocniczego
3 min
Uno rozbija sekwencyjne generowanie wewnątrz jednego modelu: obok wag autoregresyjnych trzyma lekki zestaw dyfuzyjny, dorobiony w krótkiej destylacji, który dopisuje kilka tokenów naraz i daje do trzech razy szybsze odpowiedzi bez drugiego modelu, jakiego wymaga dekodowanie spekulatywne. Wersja z ośmioma miliardami parametrów ma wypadać lepiej niż 26-miliardowa DiffusionGemma i zamknięty Mercury 2. To wciąż deklaracja z abstraktu z 3 września, bez recenzji, ale kod i wagi leżą na stronie projektu, więc sprawdzić ją da się od ręki.
Poradnik / Praktyka · 2
 Poradnik / Praktyka
Anthropic radzi opisać zadanie raz i zostawić Opusa 5 w spokoju
3 min
Anthropic radzi dawać Opusowi 5 całą specyfikację naraz i nie przerywać mu w trakcie, bo milionowe okno kontekstowe nie zmusza już do cięcia zadania na tury. Druga połowa tych porad jest o pieniądzach: przegląd kodu ma trzymać skuteczność także na niższych poziomach parametru effort, a model domyślnie startuje z high, więc konfiguracja nieruszana od czasów Opusa 4.8 kupuje dziś myślenie, które niczego już w wyniku nie zmienia. To jedyna rada z własnym sposobem sprawdzenia, bo reszta, łącznie ze zdaniem o przeglądach, to deklaracja producenta o własnym modelu.
 Poradnik / Praktyka
Jury Google'a zajrzało w kod i znalazło jeden model z imionami agentów
4 min
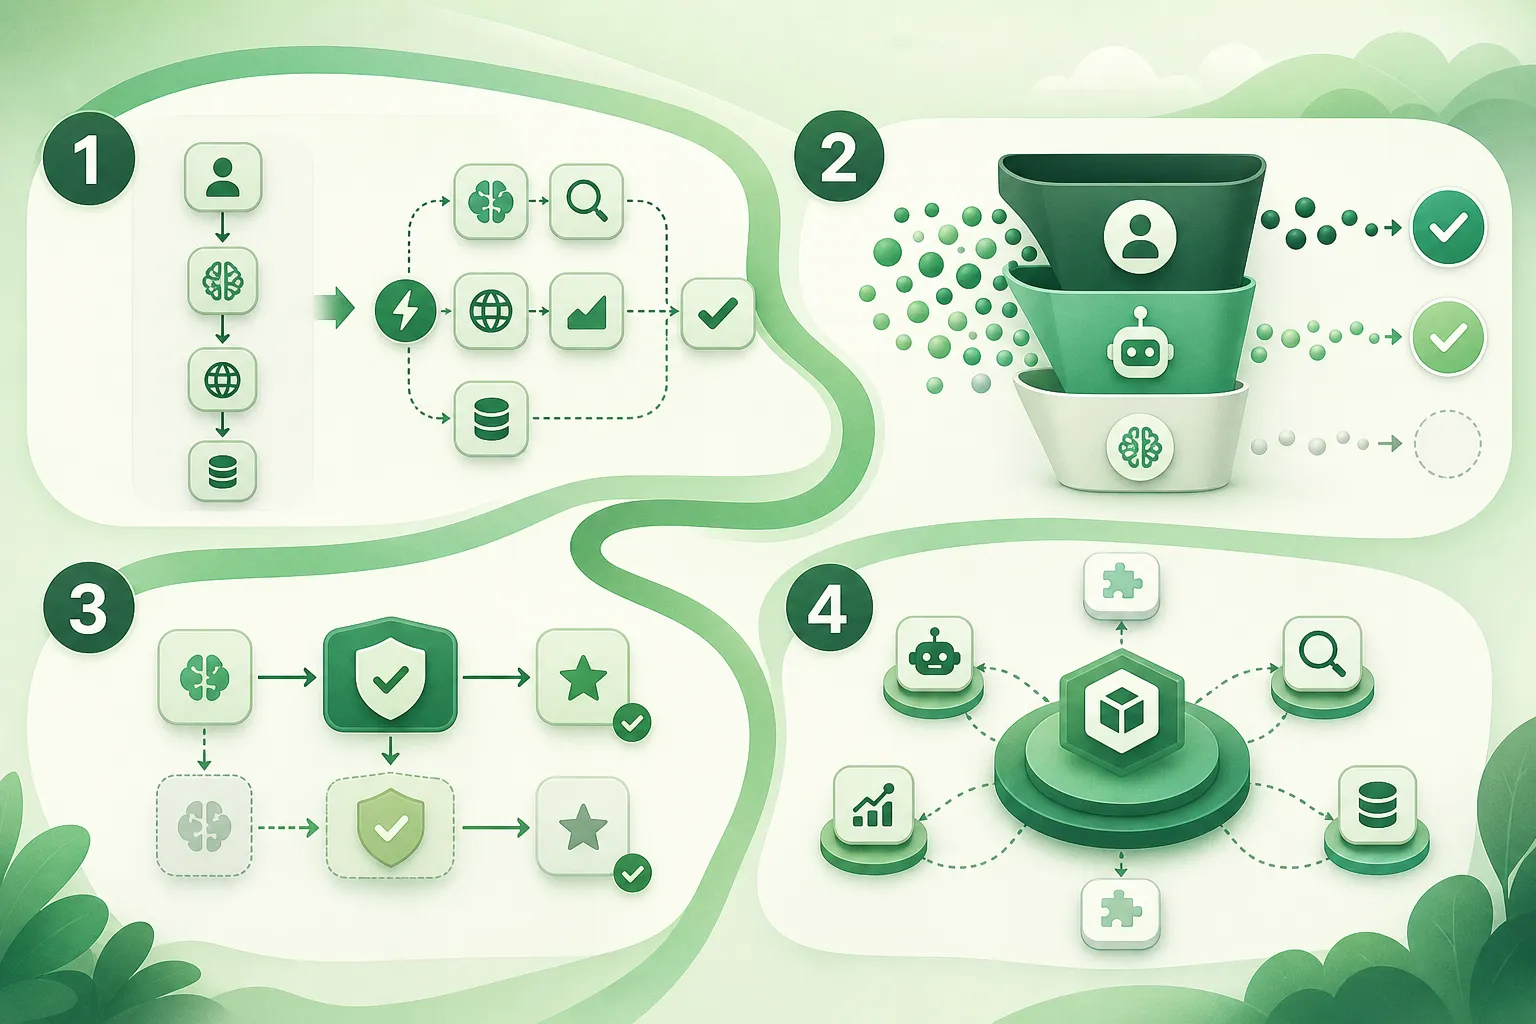
Google przejrzał kod tysięcy zgłoszeń na AI Agents Challenge i opisał cztery wzorce, które powtarzały się u najlepszych, choć żaden nie dotyczy agentów jako takich. Zamiast łańcucha wywołań jeden zespół postawił cztery kolejki asyncio.Queue, inny wstawił przed model lokalny regex, który odsiał ponad 40% wiadomości, zanim cokolwiek trafiło na rachunek za inferencję, a kolejny wystawił własnego agenta jako serwer MCP. Liczby są pomiarami samych zespołów, a konkurs oceniało jury firmy, która go zorganizowała, więc to obserwacja, nie dowód.
Analiza / Opinia · 3
 Analiza / Opinia
Czy model zbuduje agenta bez inżyniera? Na razie co czwarte zadanie.
4 min
Sierra otworzyła hyper-tau-bench: 53 zadania, w których agent ma sam zbudować działającego agenta obsługi klienta. Najlepiej wypadł Claude Opus 5 z maksymalnym rozumowaniem, ale zaliczył 23,9% rozmów testowych, podczas gdy ten sam model prowadzony przez inżyniera dochodzi na tych samych zadaniach do 82,2%. Przepaść nie bierze się z pisania kodu: w zadaniach bankowych agent zaglądał do mniej niż 80 z około 1700 plików i zadawał symulowanemu klientowi najwyżej cztery pytania, choć już dwa podnosiły skuteczność z 5% do 25%. Ta różnica to po prostu cena braku nadzoru.
 Analiza / Opinia
Kolumna z ceną w rankingu Cursora mówi więcej niż kolejność miejsc
4 min
Fable 5.1 Max zamyka 51,8% zadań w CursorBench 4.0 i wygrywa ranking, ale sąsiednia kolumna mówi więcej: to pierwsze miejsce kosztuje 17,28 dolara od zadania, a Muse Spark 1.3 Max dochodzi do 41,6% za 2,64 dolara. Poziom wysiłku waży tu więcej niż sama nazwa modelu, bo Fable 5.1 Low z wynikiem 45,1% wypada lepiej niż droższy o dwie trzecie Opus 5 High. Cursor układa zadania, sam je ocenia i w tej samej tabeli wystawia własnego Composera 2.5, który ląduje dopiero na 36. pozycji, więc czytam tę listę jak pomiar z jednego stanowiska.
 Analiza / Opinia
OpenAI opublikowało własny rachunek za agenty do kodu
4 min
OpenAI pokazało własny rachunek za pisanie kodu z agentami: w połowie sierpnia badacz ze środka stawki zużywał tokeny za ponad 600 dolarów dziennie, a najbardziej rozpędzona dziesiąta część działu za ponad 7 tysięcy, choć wyliczono to po cenniku API, którego sama firma nie płaci. Więcej o samych agentach mówi inna liczba, bo wśród udanych zadań na cztery do ośmiu godzin ponad połowa wymagała po drodze poprawki człowieka. Tokeny zwracają się tam, gdzie ktoś grzęźnie w infrastrukturze, a nie tam, gdzie trzeba wymyślić, co w ogóle budować.