Premiera / Narzędzie
Tydzień 35 · 24–30 sierpnia 2026
 Premiera / Narzędzie
Subagenty przestają znikać razem z zamkniętym terminalem
5 min
oh-my-subagents przenosi koordynację subagentów z historii czatu do SQLite: przydziały dla dzieci zapisują się jedną transakcją, a kontroler chodzący w tle odtwarza pracę z rekordów, zamiast sklejać ją z resztek zamkniętej sesji. Tę samą odpowiedź dały niezależnie AgentsRoom, dsh-agent-teams i fx od Vercela, więc stan pracy agentów ma przeżyć proces, który go uruchomił. Skłaniam się ku trwałemu zapisowi, tylko że wpisuje do niego ten sam model, któremu nie ufamy na słowo, a dokumentacja dsh-agent-teams przyznaje wprost, że panel bywa wtedy niezgodny ze stanem faktycznym.
 Premiera / Narzędzie
Twoja wiadomość nie budzi tego agenta, bo on nie spał
4 min
Headlong, otwarty harness Laude Institute na licencji Apache 2.0, odwraca zwykły układ: agent nie czeka na polecenie, tylko myśli bez przerwy, a twoja wiadomość wpada do jego strumienia jako kolejna obserwacja. Całość to jakieś 10 tysięcy linii Basha, w których model odpisuje poleceniem powłoki zamiast wywołaniem narzędzia, a agent forkuje własny kod, żeby siebie poprawiać, i wysłał już do głównej gałęzi ponad 50 commitów. Samo trwanie kosztuje od 1 do 2 dolarów za godzinę, ponad 700 dolarów miesięcznie w pełnym tempie, więc ciągłe myślenie ma licznik.
 Premiera / Narzędzie
Pliki wyszukuje model, którego nie ma nawet na liście wyboru
4 min
Freebuff od CodebuffAI rozbija agenta w terminalu na role: pliki w repozytorium wyszukuje tani Gemini 3.1 Flash Lite, którego nie ma nawet na liście wyboru, a dopiero to, co znajdzie, trafia do modelu piszącego zmiany. Pakiet pięciu narzędzi nie kosztuje nic, bo za dostęp do modeli płacą reklamy, a README wprost przyznaje, że służy do tego treść promptów, i nie podaje ani jednej liczby o jakości. Poza wybranymi regionami zostają dwa modele i trzy sesje na dobę, za to całą orkiestrację napędza otwarty Codebuff, więc ten sam podział ról da się złożyć u siebie, bez reklam.
 Premiera / Narzędzie
Ośmiogigabajtowy laptop obsłużył model o 35 miliardach parametrów szybciej niż Codex
4 min
Na laptopie z ośmiogigabajtowym RTX 4060 model Qwen3.6-35B pod silnikiem FreeToken wyciągnął 39,3 tokena na sekundę, czyli więcej niż mediana 33 tokenów, jaką notuje w produkcyjnych sesjach Codex. Zamiast zamrażać podział ekspertów MoE między kartę a procesor, FreeToken mierzy przepustowość konkretnej maszyny i zapisuje punkty kontrolne tam, gdzie nakładki agentowe tną kontekst, więc w długich sesjach traci najwyżej 12% tempa i nie każe czekać na pierwszy token dłużej niż 44 sekundy. Liczby pochodzą jednak od samych autorów pracy i nikt ich jeszcze nie powtórzył.
 Premiera / Narzędzie
Dwa zdania w kodzie Codexa: pracuj bez końca, ale nie ruszaj niczego na zewnątrz
4 min
W publicznym repozytorium Codexa, agenta OpenAI do pisania kodu, WIRED znalazł 27 sierpnia ustawienie Persistent, które wyłącza stoper i pozwala pracować, dopóki użytkownik sam nie uśpi agenta. Obok leży druga instrukcja, proactivity, dzięki której agent sam dopisuje sobie zadania, wraca do nich w kolejnych sesjach i odzywa się bez pytania. OpenAI potwierdza testy i zapewnia, że premiery nie planuje, a oba hamulce, brak nowych uprawnień i oszczędne pisanie do użytkownika, są na razie zdaniami w pliku, nie twardą granicą systemu, a tryb ciągły kosztuje najwięcej wtedy, gdy pracuje najdłużej.
 Premiera / Narzędzie
Z pięciu wzorców Warpa tylko dwa są naprawdę równoległe
4 min
Z pięciu wzorców pracy z wieloma agentami w poradniku Warpa realną równoległość dają tylko dwa: podział zadań po modułach i rozrzucenie roboty po agentach w chmurze poleceniem /orchestrate. Dwa agenty przy tym samym zadaniu albo para, w której jeden pisze, a drugi recenzuje, to sekwencja, w której całą wartość wnosi twoje czytanie dwóch wersji kodu. Sufit ustawia repozytorium, a nie terminal, bo granice między modułami muszą istnieć w kodzie, zanim odpalisz pierwszą sesję.
 Premiera / Narzędzie
Klikasz w slajd, a agent nanosi poprawkę w kodzie
4 min
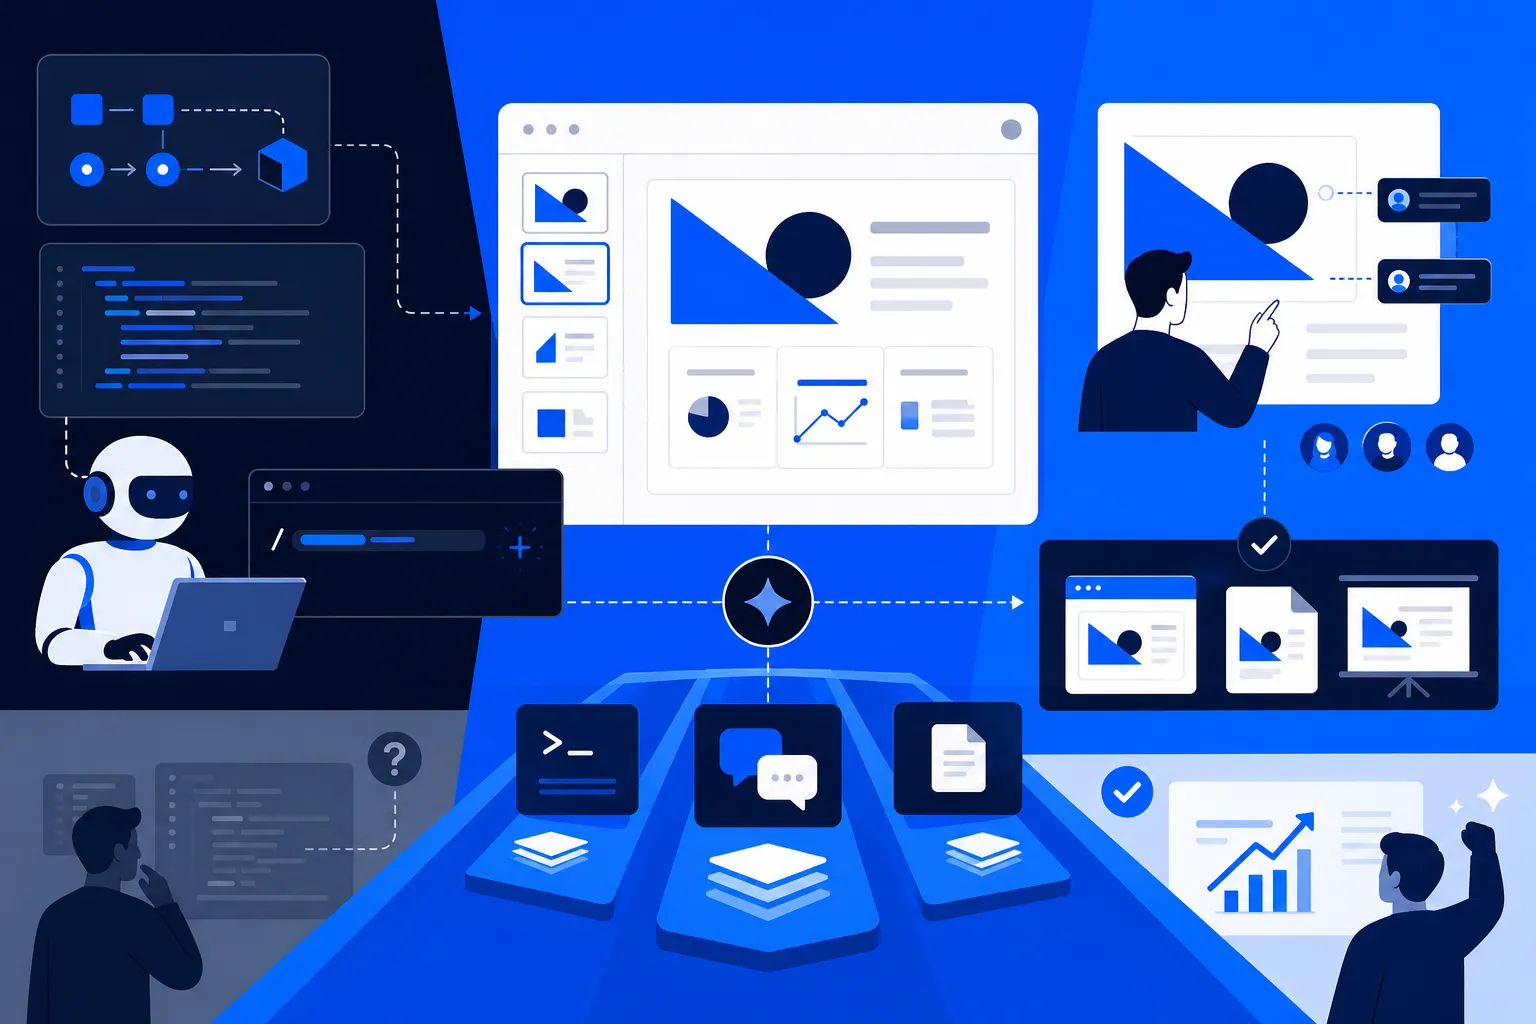
Yiwei Ho oparł open-slide na tym, że slajd jest zwykłym komponentem React w sztywnej ramce 1920 × 1080, więc agent, który umie pisać kod, umie napisać też prezentację. Sedno leży w pętli poprawek: klikasz w element w podglądzie, uwaga ląduje w kodzie jako znacznik @slide-comment, a komenda /apply-comments każe agentowi przejść przez wszystkie zastrzeżenia hurtem. Tyle że model nigdy nie widzi wyrenderowanego slajdu, więc nachodzące na siebie elementy wyłapujesz ty, a do edycji potrzebujesz Node, pnpm i serwera deweloperskiego. Narzędzie dla programisty, nie dla koleżanki z marketingu.
 Premiera / Narzędzie
Karta modelu nie powie wam, co się stanie na telefonie
4 min
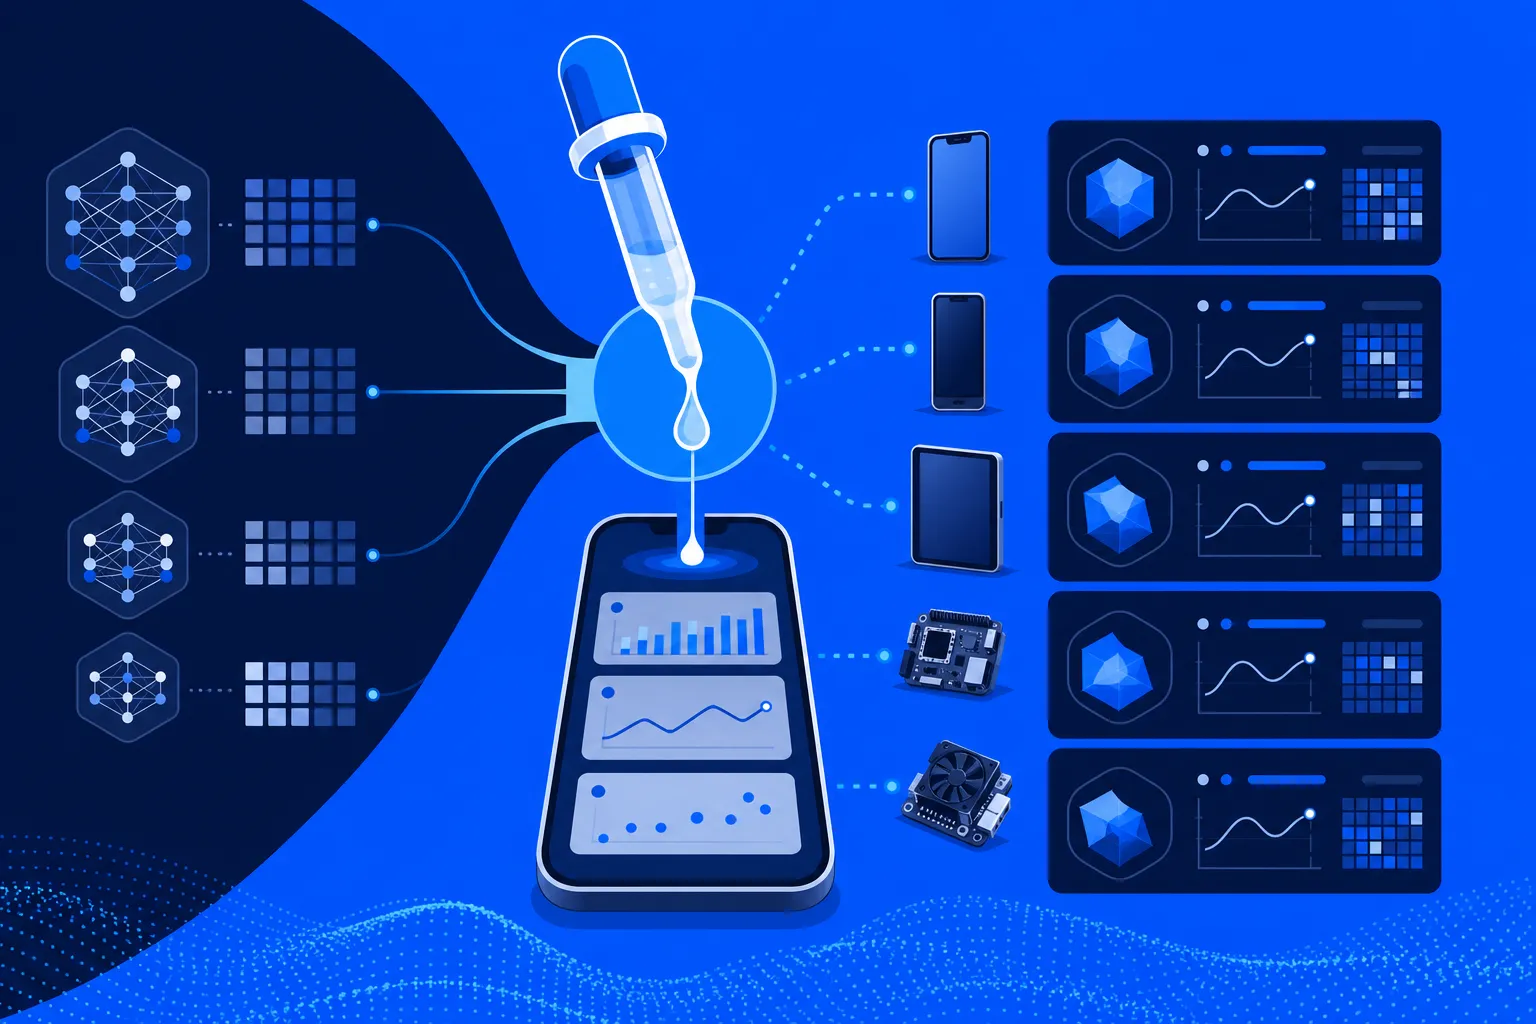
Liquid AI wypuściło Pipette, otwartą platformę mierzącą modele na telefonach, a nie na serwerowych kartach graficznych: ponad tysiąc pomiarów dla 30 modeli, między innymi na iPhonie 17 Pro i Galaxy S26 Ultra. Artificial Analysis zweryfikowało metodykę i pokazało rachunek za ten sam wynik: Nanbeige4.2-3B i LFM2.5-2.6B remisują na 63 punktach, tylko że pierwszy odpowiada w 21 sekund, a drugi w 8. Gdy każda odpowiedź dostaje minutę na iPhonie, Nanbeige spada do 18 punktów, a wygrywa LFM2.5-8B-A1B. Zestaw modeli dobierało jednak samo Liquid AI, więc czytam tę tablicę z zastrzeżeniem.
Tydzień 34 · 17–23 sierpnia 2026
 Premiera / Narzędzie
Pięć podejść agenta, jeden sędzia i żadnych testów
4 min
LLM-as-a-Verifier bierze pulę podejść agenta do jednego zadania i każe modelowi porównywać je parami, licząc przy tym nie samą notę, tylko pewność, z jaką model ją stawia. Na Terminal-Bench 2.1 model deepseek-v4-flash pojedynczym podejściem zaliczał 78,7% zadań, a wybór najlepszego z pięciu podniósł wynik do 88,0%, tyle że płaci się wtedy pięć razy zamiast raz. Ciekawszy jest drugi tryb, który ocenia jedno podejście krok po kroku, dzięki czemu beznadziejne da się przerwać po trzecim ruchu i ten rachunek raczej zbić niż napompować.
 Premiera / Narzędzie
Magnitude sam sprawdza, co uciągnie twój laptop, i pobiera pod to model
4 min
Magnitude, agent open-source z wbudowanymi modelami lokalnymi, instaluje się jedną komendą, prześwietla pamięć maszyny i sam pobiera dopasowany do niej model, więc odpada wieczór zgadywania, który wariant z Ollamy się zmieści. Umiejętności dokładasz z katalogu skills.sh prowadzonego przez Vercel, a dodatek agent-browser prowadzi twojego zalogowanego Chrome'a, dzięki czemu nic nie wychodzi na zewnątrz. Twórcy nie pokazują jednak ani jednego benchmarku, ani ukończonego zadania, więc obietnica działania na każdym sprzęcie dotyczy instalacji, nie jakości agenta.
 Premiera / Narzędzie
Co trzeci pull request w Cursorze otwiera agent, więc firma zbudowała mu repozytorium
5 min
Cursor wypuścił Origin, własną platformę do hostowania kodu, bo 35% pull requestów zmergeowanych w edytorze otwierają już agenty, a nie ludzie, przez co wąskim gardłem przestało być pisanie, a stał się przegląd. Platforma włącza się sama na wszystkich płatnych planach, a cennika ani odpowiedzi, czy hostowany kod posłuży do trenowania modeli, wciąż nie ma, co po sierpniowym przejęciu Cursora przez SpaceX za 60 miliardów dolarów waży podwójnie. Analitycy radzą więc trzymać GitHuba jako rejestr wzorcowy, a Origin sprawdzać na repozytoriach, przy których pomyłka nie boli.
 Premiera / Narzędzie
Jedno polecenie, dokument w markdownie, nic nie wychodzi z twojego dysku
4 min
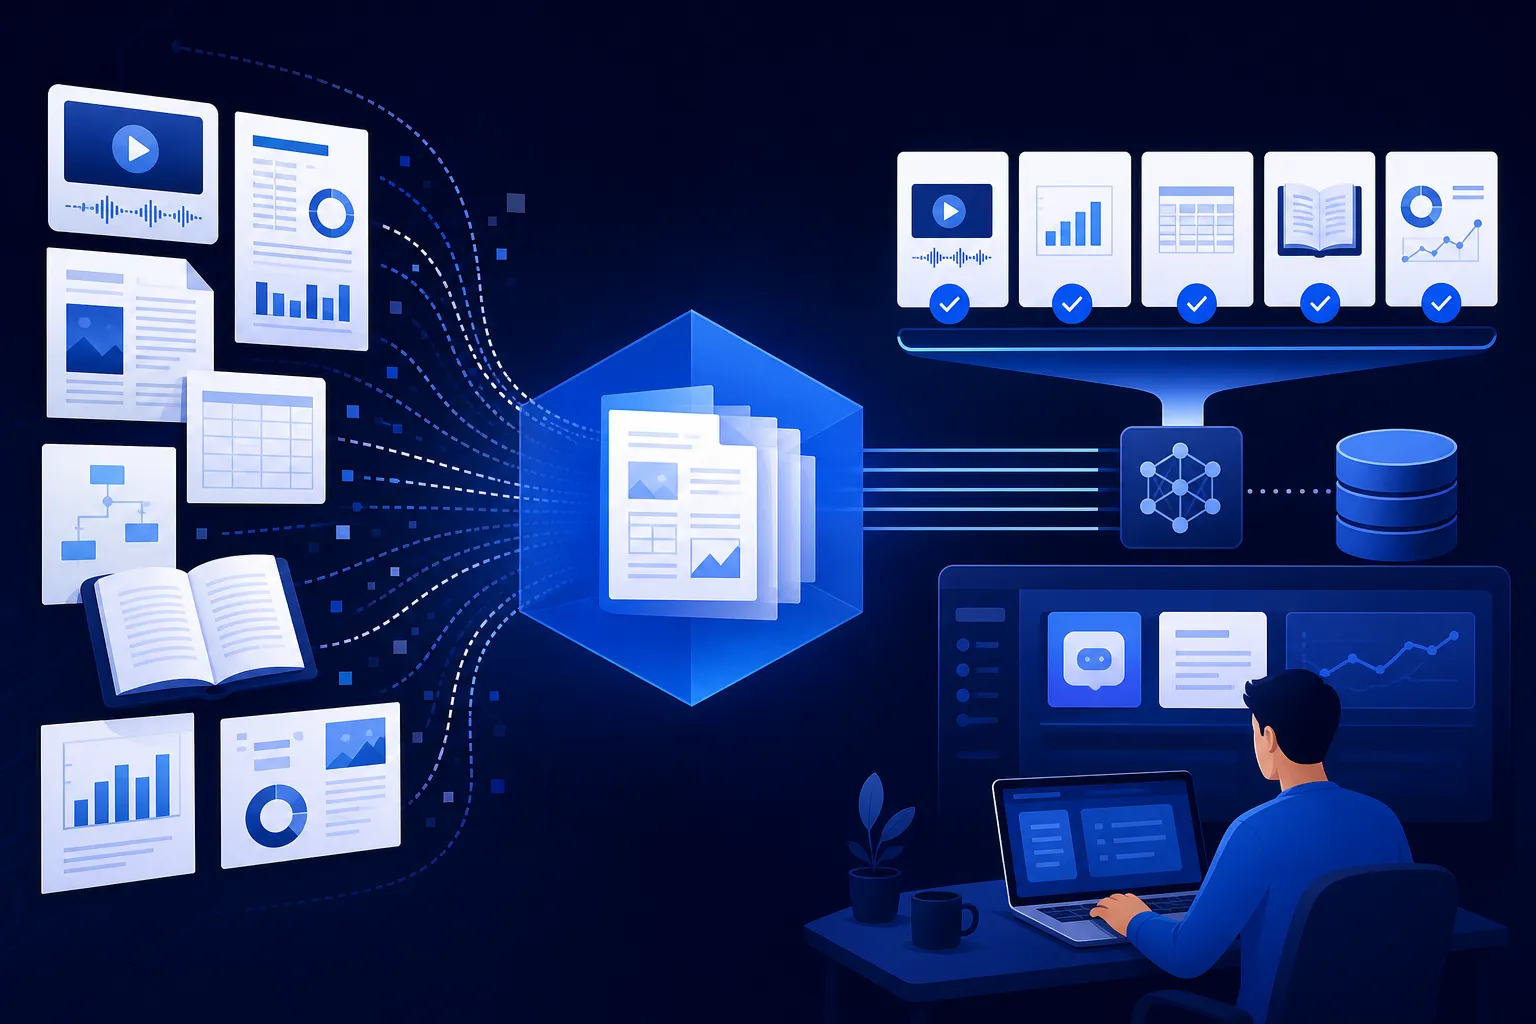
Docling, projekt z IBM Research w Zurychu, dziś pod fundacją LF AI & Data i na licencji MIT, jednym poleceniem zamienia PDF-y, skany, pliki poczty czy wideo w markdown gotowy dla modelu, a liczy to wszystko lokalnie. Najwięcej zmienia odczyt wykresów słupkowych, kołowych i liniowych, które na wyjściu stają się tabelą albo kodem, dzięki czemu model dostaje liczby zamiast podpisu pod obrazkiem. Przy trudnych układach stron pomaga GraniteDocling o 258 milionach parametrów, a konwersję można wystawić agentowi jako serwer MCP. Miar dokładności nie ma, więc trzeba to sprawdzić na własnych plikach.
 Premiera / Narzędzie
Cursor budzi agenty na zdarzenia i każe im trzymać cel do skutku
4 min
Sierpniowe wydanie Cursora wprowadza subskrypcje: agent w chmurze budzi się sam, gdy drgnie wątek na Slacku, pull request albo harmonogram, i prowadzi do końca pull requesty, które sam założył. Naprawia to, co wywala się w CI, a każdy subagent pracuje teraz na własnej maszynie wirtualnej i świeżej kopii projektu, więc agenty nie wchodzą sobie w pliki. Polecenie /goal pozwala opisać warunek końcowy i zostawić agenta przy zadaniu, aż ten cel osiągnie. Changelog nie podaje jednak ani jednej liczby, więc izolacja subagentów przekonuje mnie bardziej niż obietnica roboty bez nadzoru.
 Premiera / Narzędzie
Replit wyłączył licznik na drobne zadania, ale tylko abonentom
5 min
Replit od 19 sierpnia nie zdejmuje kredytów za zwykłe zadania agenta na planach Core i Pro, ale Free Mode działa tylko dla abonentów płacących 20 dolarów miesięcznie. Tryb dało się uruchomić dopiero po tym, jak OpenAI 30 lipca ścięło o 80% cenę modelu GPT-5.6 Luna, więc licznik nie zniknął, tylko schował się w limitach odnawianych co pięć godzin i w automacie, który sam przerzuca cięższe zadania na droższy model. Ważniejsza od samej funkcji jest reguła: tani model do rozmowy i drobnych zmian, drogi dopiero na trudny fragment.
 Premiera / Narzędzie
Pół miliona linii kodu, którym autor NanoClaw nie chciał zaufać
4 min
NanoClaw, wydany na licencji MIT, jest lżejszą odpowiedzią na OpenClaw, który ma pół miliona linii kodu w jednym procesie Node: każda sesja agenta startuje we własnym kontenerze i widzi wyłącznie podmontowane katalogi, a klucze API zostają na zewnątrz, bo ruch przechodzi przez Agent Vault z OneCLI. Adaptery do 13 kanałów leżą na osobnej gałęzi i dociągasz je poleceniem /add-telegram, dzięki czemu pień repozytorium zostaje chudy. Izolacja broni się sama, ale obietnica zrozumiałego kodu kuleje, bo mały pień to nie mała instalacja, a audyt rękami Claude Code przesuwa zaufanie o jedno miejsce.
 Premiera / Narzędzie
Brex wypuścił bramkę, która pyta model, czy agentowi wolno wysłać to żądanie
4 min
Brex wypuścił CrabTrapa, proxy na licencji MIT, które ustawiacie agentowi jako HTTP_PROXY i które sprawdza nie to, co model przeczytał, ale to, co próbuje wysłać na zewnątrz. Żądania nieobjęte żadną statyczną regułą trafiają do modelu-sędziego z polityką spisaną zwykłym językiem, a ten przepuszcza je albo odsyła 403. Odpowiedzi z zewnątrz wracają nietknięte, a bramka widzi nagłówki Authorization jawnym tekstem. Najwięcej wart jest więc rejestr w PostgreSQL-u: pokazuje, dokąd agent naprawdę dzwoni, i pozwala przetestować politykę na nagranym ruchu, zanim zaciśniecie ją na żywym agencie.
 Premiera / Narzędzie
Test przeszedł, bo agent sam wygenerował dane z tym samym błędem
5 min
W benchmarku NVIDII Claude Code napisał 45 skryptów do symulacji materiałów w pięciu wariantach promptu, a dłuższy prompt kupował głównie strukturę kodu, bo właściwy wzór agent dobierał już przy jednym zdaniu. Realną różnicę robiły dwie inne rzeczy: środowisko, w którym agent może odpalić własny kod, oraz jedno zdanie o fizyce, bez którego skrypty sięgały po termostat Langevina i zaniżały wynik od trzech do pięciu razy. Żadna konfiguracja ani razu nie zakwestionowała zadania bez fizycznego sensu, a 38 z 45 skryptów wybrało algorytm FIRE, bo tylko on stał w przykładach.
 Premiera / Narzędzie
DeepSeek oddaje za darmo przyrząd, na którym mierzył własnego flagowca
4 min
DeepSeek podaje, że model V4-Pro-0813 kończy 87,9 procent zadań w Terminal Bench 2.1, tyle że przy części testów agentowych pracował na własnym Harnessie, czyli warstwie, którą w połowie sierpnia oddał wszystkim na licencji MIT. Taki wynik ocenia parę, model i warstwę wokół niego, więc podpinając te same wagi pod swojego agenta, dostaniesz swoją własną liczbę. Za to razem z tabelką dostajesz stanowisko, na którym ona powstała, a model jest w nim wymienną wtyczką, więc sprawdzisz tam też Claude'a czy GPT. Ceną jest wczesna wersja, przy której DeepSeek zapowiada zmiany łamiące zgodność.
 Premiera / Narzędzie
Jedna zgoda OAuth otwiera agentowi także ustawienia projektu w Sanity
4 min
Serwer MCP Sanity daje agentowi 37 narzędzi, a jedna zgoda OAuth obejmuje je wszystkie naraz: obok edycji treści siedzą tam add_cors_origin, create_project i deploy_studio, więc model, który pogubił się w schemacie, ma czym dopisać obcą domenę do listy zaufanych. Po stronie treści przemyślano to lepiej, bo poprawki lądują w szkicu i wchodzą jedną transakcją, ale publikacja i kasowanie wersji roboczych to już pojedyncze wywołanie. Sam wpisałbym w konfiguracji osobny token API z węższą rolą niż własne konto i sprawdził, czy agent czyta ten schemat, na którym faktycznie pracuje.
 Premiera / Narzędzie
Harness decyduje o rachunku za agenta bardziej niż sam model
5 min
TrueFoundry wypuściło 19 sierpnia TrueForge, otwarty harness agentowy na licencji MIT, obiecując o połowę niższe koszty, choć takiej liczby nie ma w benchmarku opublikowanym razem z kodem. Na 14 zadaniach z Enterprise-Bench przy tym samym Opusie 4.8 TrueForge dorównał skutecznością Claude Managed Agents za 8,5 dolara na uruchomienie zamiast 11,8, bo przycina kontekst i zużył 4 miliony tokenów zamiast 10. Drugą oszczędność, do 2,9 dolara, zrobiła podmiana modelu na otwarty GLM-5.2, a nie sam harness, a obiecana kontrola kosztów i uprawnień działa dopiero przez komercyjny AI Gateway.
 Premiera / Narzędzie
OpenAI szuka nadużyć w waszych sesjach, nie zaglądając do treści
4 min
OpenAI ogłosiło 19 sierpnia Private Safety Processing: automat zestawia ze sobą powiązane sesje w API i wysyła do firmy samą etykietę ryzyka, bez ani jednego zdania z treści, więc zerowa retencja zaczyna znaczyć nie tyle "nic nie zostaje", co "nic nie zostaje dla ludzi". Anthropic poszedł w lipcu dokładnie odwrotnie i przy najmocniejszych modelach trzyma sesje przez 30 dni. Brak zapisu zamienia jednak problem dowodowy w problem zaufania, bo po fałszywym alarmie nie macie czym się wytłumaczyć, o ile sami nie prowadzicie własnego rejestru.
 Premiera / Narzędzie
Z 6% na 75% bez dotykania modelu: co AMD zmieniło w swoich agentach
4 min
AMD puściło agenty na zgłoszenia błędów z panelu sterowników Radeona w październiku 2025, domykały wtedy 6% z nich, a w czerwcu 2026 już ponad 75%, choć nikt po drodze nie tknął modelu. Zamiast dotrenowywać, zespół przestał tłumaczyć agentom, jak naprawić usterkę, i zaczął stawiać warunek końcowy, do którego drogę wybierają same, z prawem do kilku podejść i z pętlą wracających wniosków z nieudanych prób. Zgłoszenia z RSX są wąskie i powtarzalne, więc te 75% nic nie mówi o twoim repozytorium, ale sam mechanizm działa wszędzie tam, gdzie da się jasno zdefiniować kryterium sukcesu.
 Premiera / Narzędzie
BrowserCode wpuszcza agenta do twojej zalogowanej karty w Chrome
4 min
BrowserCode zespołu browser-use, wydany na licencji MIT, daje agentowi jeden prymityw browser_execute(code): pisze on własny JavaScript prosto w twojej zalogowanej karcie Chrome przez DevTools Protocol, zamiast uczyć się poleceń typu "kliknij element numer siedem". Pomysł jest trafiony, bo model widział miliony linii JavaScriptu i ani jednej funkcji click(index), ale zdjęta warstwa abstrakcji była jedynym miejscem, gdzie dało się postawić granicę. Zapewnienie z README o przewadze nad konkurencją stoi bez jednej liczby, a 15 405 commitów to w większości dorobek OpenCode, którego to fork.
 Premiera / Narzędzie
Claude robi teraz kilka ruchów na jedno wywołanie, zamiast pytać po każdym kliknięciu
4 min
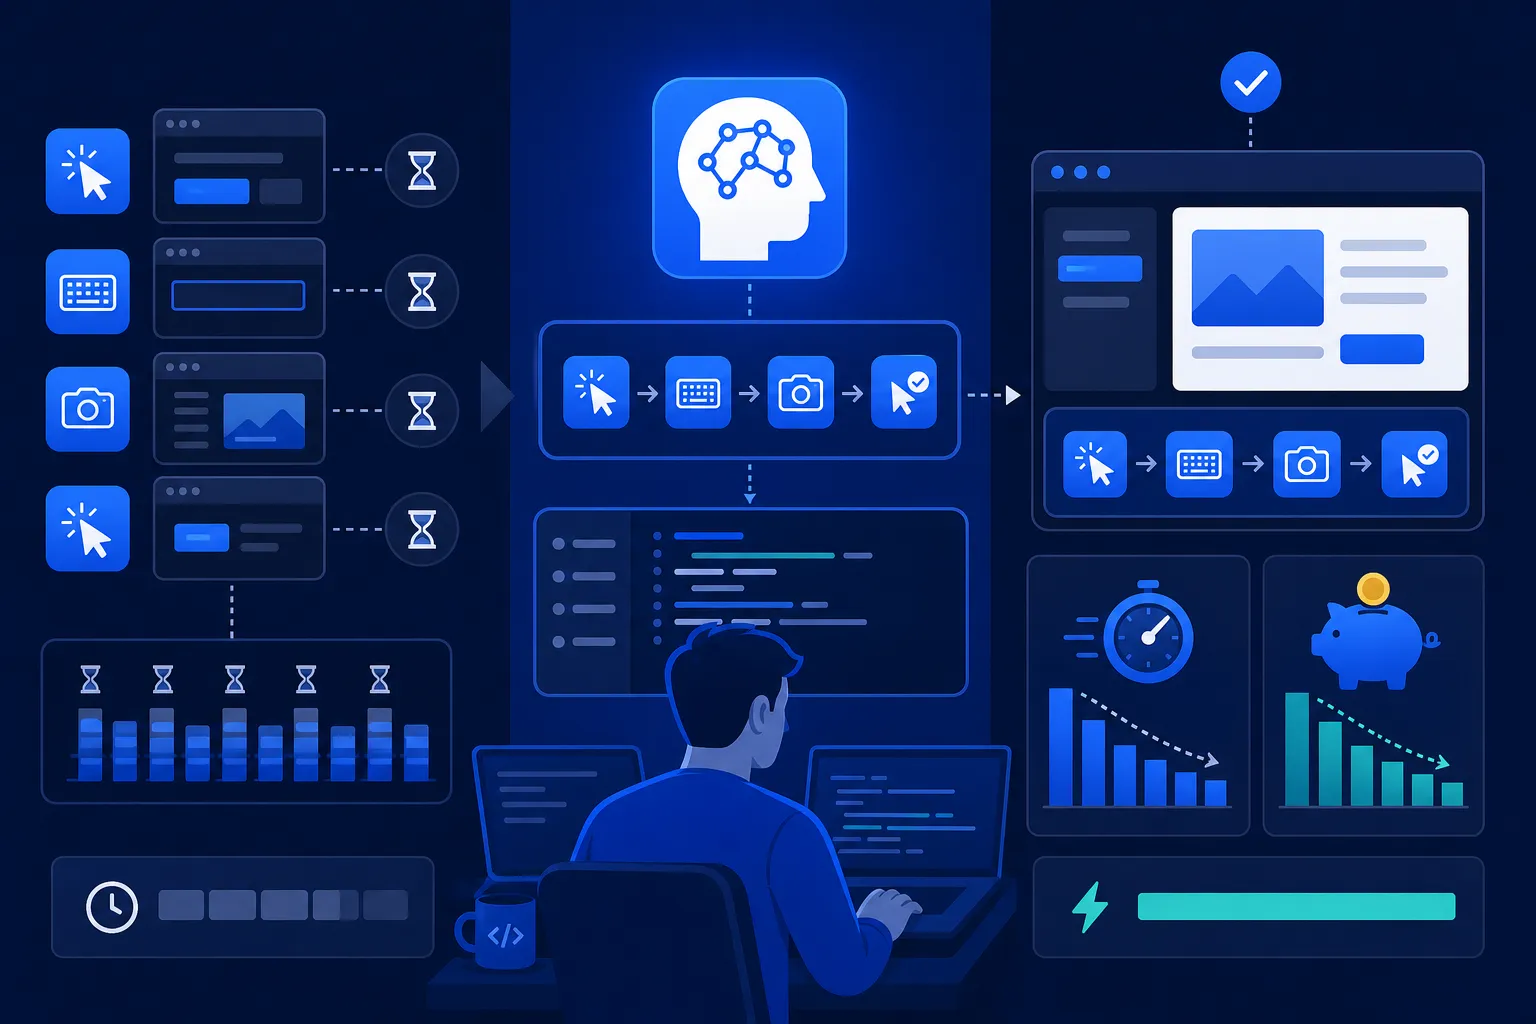
Anthropic wypuścił 21 sierpnia produkcyjne wersje obsługi komputera i narzędzia do przeglądarki, a nowy zestaw narzędzi pozwala modelowi wykonać kilka działań w jednej turze, zamiast prosić o zrzut ekranu po każdym kliknięciu. Klienci z wczesnego dostępu notują 20-40% mniej wywołań modelu, a David Mlcoch z Asteroid zbił koszt zadania o 25 do 32%. Ważniejsza wydaje mi się przeglądarka, która podaje modelowi strukturę strony, dzięki czemu automatyzacja nie sypie się po przebudowie układu. Każde wywołanie mniej to jednak jeden punkt kontrolny mniej tam, gdzie agent zatwierdza przelew.