Premiera / Narzędzie
Tydzień 32 · 3–9 sierpnia 2026
 Premiera / Narzędzie
Czy agent sam rozszerzy opublikowaną pracę badawczą? W teście RExBench udaje się to co trzeci raz
3 min
RExBench, benchmark z konferencji ACL z lipca 2026, bierze 12 prawdziwych prac naukowych z kodem i każe agentowi kodującemu samodzielnie rozszerzyć je o nową hipotezę, więc sprawdza coś trudniejszego niż łatanie zgłoszonych błędów. Autorzy przetestowali 12 konfiguracji agentów na frameworkach aider i OpenHands, a najlepszy dowiózł zaledwie 33% zadań. Nawet gdy dołożono wskazówki napisane przez człowieka, wynik nie przekroczył 44%, co pokazuje, że bariera nie leży w zrozumieniu polecenia. Im bardziej zadanie jest otwarte i badawcze, tym mocniej skuteczność agenta bez nadzoru spada.
 Premiera / Narzędzie
Cloudflare OS: firmowy agent zaczyna od zera uprawnień i prosi o każdy dostęp z osobna
5 min
5 sierpnia Cloudflare udostępnił na licencji Apache 2.0 Cloudflare OS, platformę, w której każdy agent startuje bez uprawnień i o każdy dostęp prosi osobno. Wygenerowany kod nie dostaje klucza, tylko typowany obiekt uprawnień, a sekret zostaje w usłudze zwanej Gatekeeperem, która pilnuje reguł nawet przy prompt injection i sprawdza, czy odbiorca ma dostęp do danych przeczytanych po drodze przez agenta. Prawdziwą wartością jest nie świeżość pomysłu, bo uprawnienia zamiast kluczy i zero trust są dużo starsze, lecz kompletny, działający wzorzec na problem, który reszta branży łata politykami.
 Premiera / Narzędzie
Cloudflare wystawia agentom narzędzia jednym przełącznikiem, bez linijki kodu
4 min
Cloudflare uruchomił 8 sierpnia wczesny podgląd WebMCP: jeden przełącznik w panelu sprawia, że strona wystawia agentom AI gotowe narzędzia zamiast układu skrojonego pod człowieka, bez zmian w kodzie serwera. Na brzegu sieci firma wstrzykuje mostek do nowego, eksperymentalnego w Chrome 146 standardu przeglądarkowego. W podglądzie są dwie paczki: Content Credentials czyta metadane pochodzenia zdjęć w C2PA, ale ich kryptograficznie nie weryfikuje, a mocniejszy Site MCP Server łączy agenta z twoim własnym serwerem MCP, który i tak musisz zbudować sam.
 Premiera / Narzędzie
Czternaście formatów dokumentów, jeden markdown na wyjściu
4 min
Firecrawl wypuścił AnyDoc, otwartą bibliotekę na licencji MIT, która zamienia 14 formatów dokumentów, od Worda i Excela po PDF, na jednolity markdown. Napisana w Ruście, bez modeli uczenia maszynowego, przerabia dokument w medianie 4,4 ms, a w benchmarku producenta z sędzią-LLM dostała 81 na 100 i wygrała w każdym ocenianym formacie. Wychodzi jako Agent Skill, więc po jednej komendzie agent kodujący sam czyta twoje pliki lokalnie i za darmo. Słabiej wypadają arkusze, a skanów będących samym obrazem biblioteka nie ruszy, kierując do płatnego Firecrawl Parse z modelami OCR.
 Premiera / Narzędzie
Microsoft pozwala AI napisać test tylko raz, resztę robi już zwykły skrypt
3 min
Zespół Commerce Platforms w Microsofcie obszedł konflikt między probabilistyczną naturą AI a wymogiem, by test zgodności za każdym razem przebiegał identycznie: agent tylko raz układa przypadki testowe z istniejącej dokumentacji, człowiek je zatwierdza, a wynik zostaje zamrożony w deterministyczny skrypt, którego AI już nie dotyka. Drugi agent podważa to, co stworzył pierwszy, zanim cokolwiek zostanie zatwierdzone. Cotygodniowe testy regresji przy migracji Global Trade Services na SAP S/4HANA spadły z trzech dni do niespełna godziny, choć liczby pochodzą wyłącznie z firmowego bloga Microsoftu.
 Premiera / Narzędzie
MCP zrzuca stan i wychodzi z fazy eksperymentu
4 min
Specyfikacja z 28 lipca 2026 czyni protokół MCP w pełni bezstanowym: żądanie niesie wszystko, czego potrzebuje, więc serwer nie musi pamiętać sesji i obsłuży je dowolna wolna instancja, nawet pojedyncza funkcja na brzegu sieci Cloudflare. Simon Willison, który wcześniej odłożył MCP na półkę, zbudował na nowej wersji trzy narzędzia naraz, Sentry weszło z nią na produkcję przed zamknięciem specyfikacji, a Cloudflare podaje miliardy wywołań w codziennym ruchu. Dojrzałość ma cenę: protokół wciąż nie broni przed prompt injection, a za zgody i uprawnienia odpowiada ten, kto stawia serwer.
 Premiera / Narzędzie
Serwer MCP zamiast dokumentacji, której model i tak nie doczytał
3 min
Sinch, szwedzki dostawca infrastruktury komunikacyjnej, ogłosił 4 sierpnia Agent Tools: serwer MCP, który podsuwa asystentom takim jak Claude Code czy Cursor aktualne definicje ośmiu swoich usług, zamiast pozwolić modelowi zgadywać wywołania z pamięci. Tryb Simulator pozwala przetestować integrację z poziomu edytora, bez zakładania konta. Moim zdaniem to mniej historia o Sinchu, a bardziej zapowiedź tego, co każdy dostawca API będzie musiał robić. Otwarte pozostaje, czy aktualne definicje wycinają zmyślanie, czy tylko przesuwają je piętro wyżej.
Tydzień 31 · 27 lipca – 2 sierpnia 2026
 Premiera / Narzędzie
MCP staje się bezstanowy i zaczyna skalować się jak zwykłe HTTP
5 min
Specyfikacja MCP z 28 lipca 2026 wyrzuca mechanizm sesji, wymianę initialize i nagłówek Mcp-Session-Id, dzięki czemu każde żądanie niesie w sobie wszystko, czego potrzebuje, i trafia na dowolną instancję serwera za zwykłym load balancerem. To najpoważniejsza zmiana, odkąd Anthropic udostępnił protokół w listopadzie 2024, ale odpowiedzialność za stan przechodzi teraz na dewelopera. Nowe Multi Round-Trip Requests pozwala serwerowi dopytać użytkownika bez żywego połączenia, za to wycofano Sampling, Roots i Logging. Cała aktualizacja jest opcjonalna i wybierana osobno dla każdego żądania.
 Premiera / Narzędzie
OptMem daje agentom pamięć, która przeżywa koniec sesji
4 min
Agent do kodu zaczyna każdą sesję od zera, bo harness ucina starą historię, gdy zapełni się okno kontekstowe. OptMem Victora Taelina odpowiada na tę amnezję jednym plikiem Pythona bez zależności i promptem na 426 tokenów wklejanym do CLAUDE.md: notatki lądują w bezstratnym, wiecznie rosnącym dzienniku, nad którym drzewo binarne streszczeń trzyma odczyt na stałym budżecie około 16 tysięcy tokenów. Cały ciężar spada jednak na model, bo to on musi konsekwentnie zapisywać i sięgać po pamięć we właściwym momencie, czego żaden świeżo wydany projekt jeszcze nie udowodnił.
 Premiera / Narzędzie
Silnik sandboxów, na którym trenowano Kimi K3, jest już otwarty
5 min
kvcache-ai otworzyło AgentENV, platformę do stawiania tysięcy odizolowanych sandboxów, na której trenowano agentową część Kimi K3, flagowego modelu Moonshot AI. Silnik stoi na mikromaszynach Firecracker ze snapshotami, więc sandbox wstaje w mniej niż 50 milisekund, a bezczynny oddaje pamięć hostowi i można go rozszczepić na kilka równoległych kopii. Wystawia API zgodne z E2B, więc kod z chmurowej usługi przenosisz na własny serwer bez zmiany linijki, ale liczby to na razie deklaracja producenta, a sam AgentENV nie ma autoryzacji, więc nie wolno wystawiać go do publicznej sieci.
 Premiera / Narzędzie
25% na testach w C++: nowy benchmark pokazuje, gdzie agenty się sypią
3 min
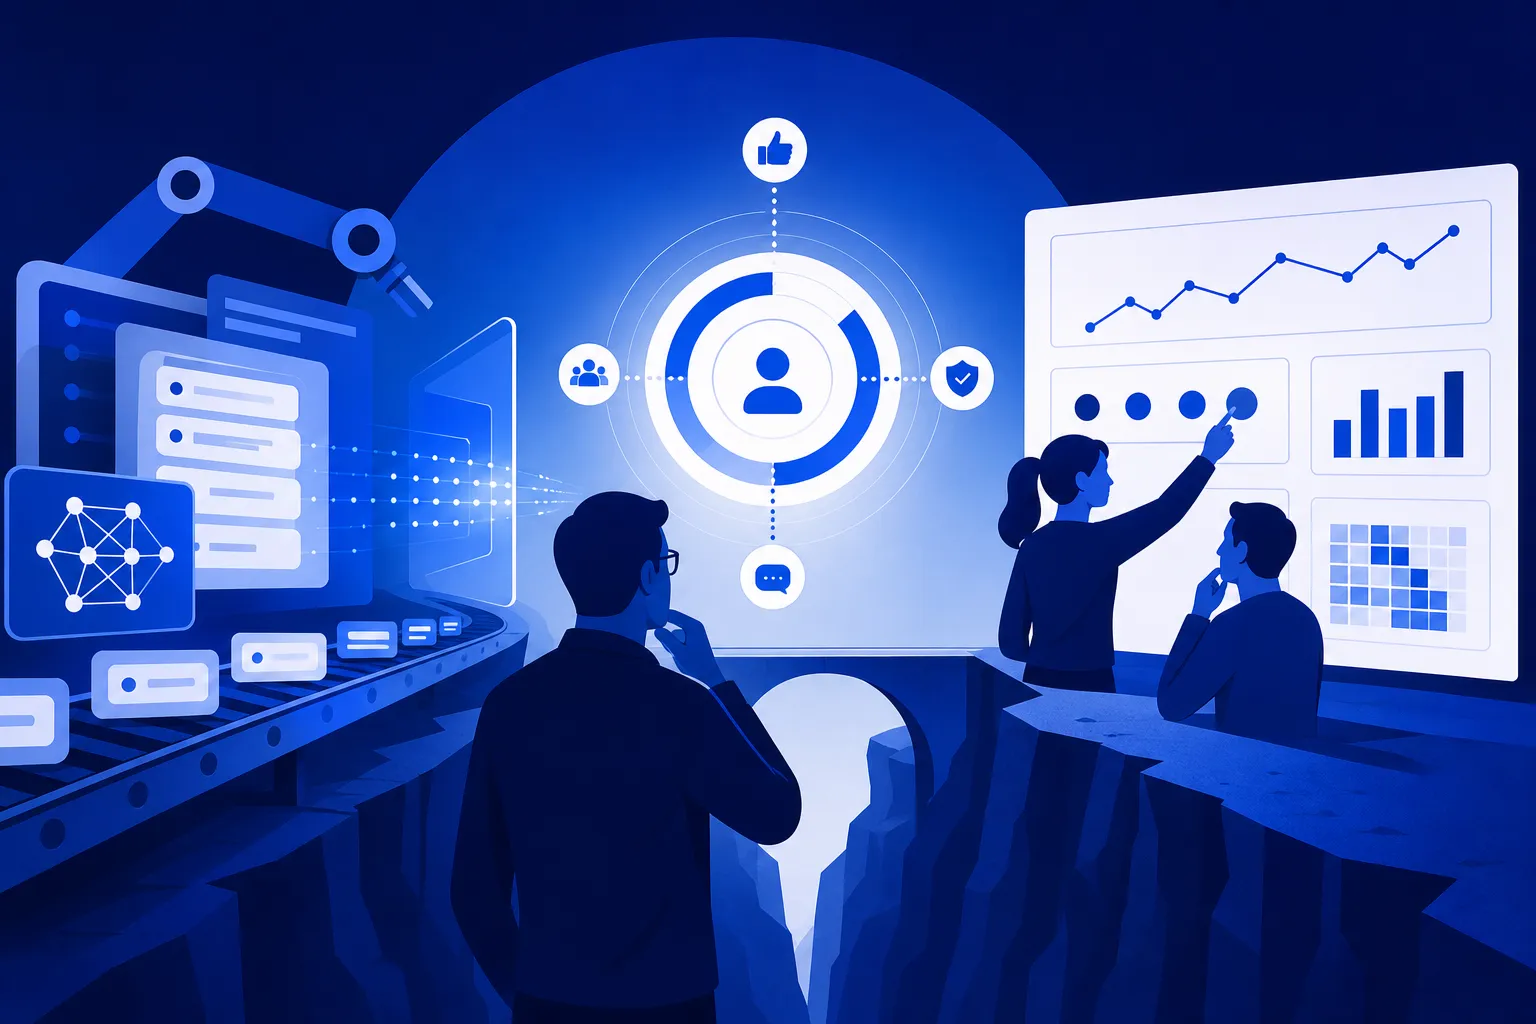
OmniCode, benchmark zespołu Atharvy Sonwane'a i Saikata Dutty przedstawiony na ACL 2026, sprawdza agenty programistyczne na 1794 zadaniach w Pythonie, Javie i C++, w czterech kategoriach: łatanie błędów, pisanie testów, poprawki z recenzji i porządkowanie stylu. Popularny SWE-Agent z modelem DeepSeek-V3.1 radzi sobie nieźle głównie z błędami w Pythonie, a na pisaniu testów w C++ wyciąga najwyżej 25%, i to w najlepszym przebiegu. Agenty są mocne tam, gdzie trenowano je najintensywniej, więc jeśli piszesz w Javie czy C++ albo oddajesz im testy, sprawdź je na własnym kodzie.
 Premiera / Narzędzie
Bedrock przepisze twój prompt, metrykę wciąż musisz napisać sam
3 min
Amazon Bedrock dostał Advanced Prompt Optimization, które przy migracji na nowszy model samo przepisuje prompt i w pętli sprawdza, czy nowa wersja wypada lepiej, celując naraz w maksymalnie pięć modeli i porównując jakość, koszt oraz czas do pierwszego tokenu. Sukces definiujesz na trzy sposoby: własną metryką, drugim modelem w roli sędziego albo opisem słowami. AWS chwali się skokami jakości od 35% do 143%, ale to pojedyncze przebiegi po pięć próbek, a optymalizator wspina się dokładnie po metryce, którą mu dasz, więc tę metrykę wciąż musisz napisać sam.
 Premiera / Narzędzie
Numbat widzi, jak agent przekracza granice, ale zatrzyma go dopiero na rozkaz
4 min
Perplexity udostępniło jako open-source Numbat, niewielki program w Go, który pilnuje agentów programistycznych na urządzeniach pracowników nie przed napastnikiem z zewnątrz, tylko przed nimi samymi: przed agentem, który natrafia na przeszkodę i sam wymyśla obejście przechodzące przez kolejne zabezpieczenia. Kluczowe są hooki wstrzymujące akcję tuż przed jej wykonaniem, a na start dostajemy 52 reguły w 11 kategoriach. Haczyk w tym, że domyślnie wszystkie tylko obserwują: dopóki administrator ręcznie nie przełączy reguły na egzekwowanie, Numbat widzi ryzyko i nie robi z nim nic.
 Premiera / Narzędzie
GitKraken Desktop 12 pokazuje na żywo, co zmienia agent w kodzie
3 min
GitKraken Desktop 12, ogłoszony 28 lipca 2026, sam wykrywa, że agent kodujący (choćby Claude Code) grzebie w plikach repozytorium, i podsuwa gotowy podgląd zmian, zanim o niego poprosisz. Sesje agenta odpalasz wprost z lewego panelu, obok grafu commitów, a poza Claude Code działają tu Codex, Gemini i Copilot przez wspólny Agent Client Protocol. Trafia to w realny ból, bo agent pisze kod szybciej, niż jesteś w stanie za nim nadążyć. Tyle że zobaczyć zmianę to nie to samo, co ją ocenić i wziąć na siebie decyzję o mergu, więc wąskiego gardła recenzji ta premiera nie rusza.
 Premiera / Narzędzie
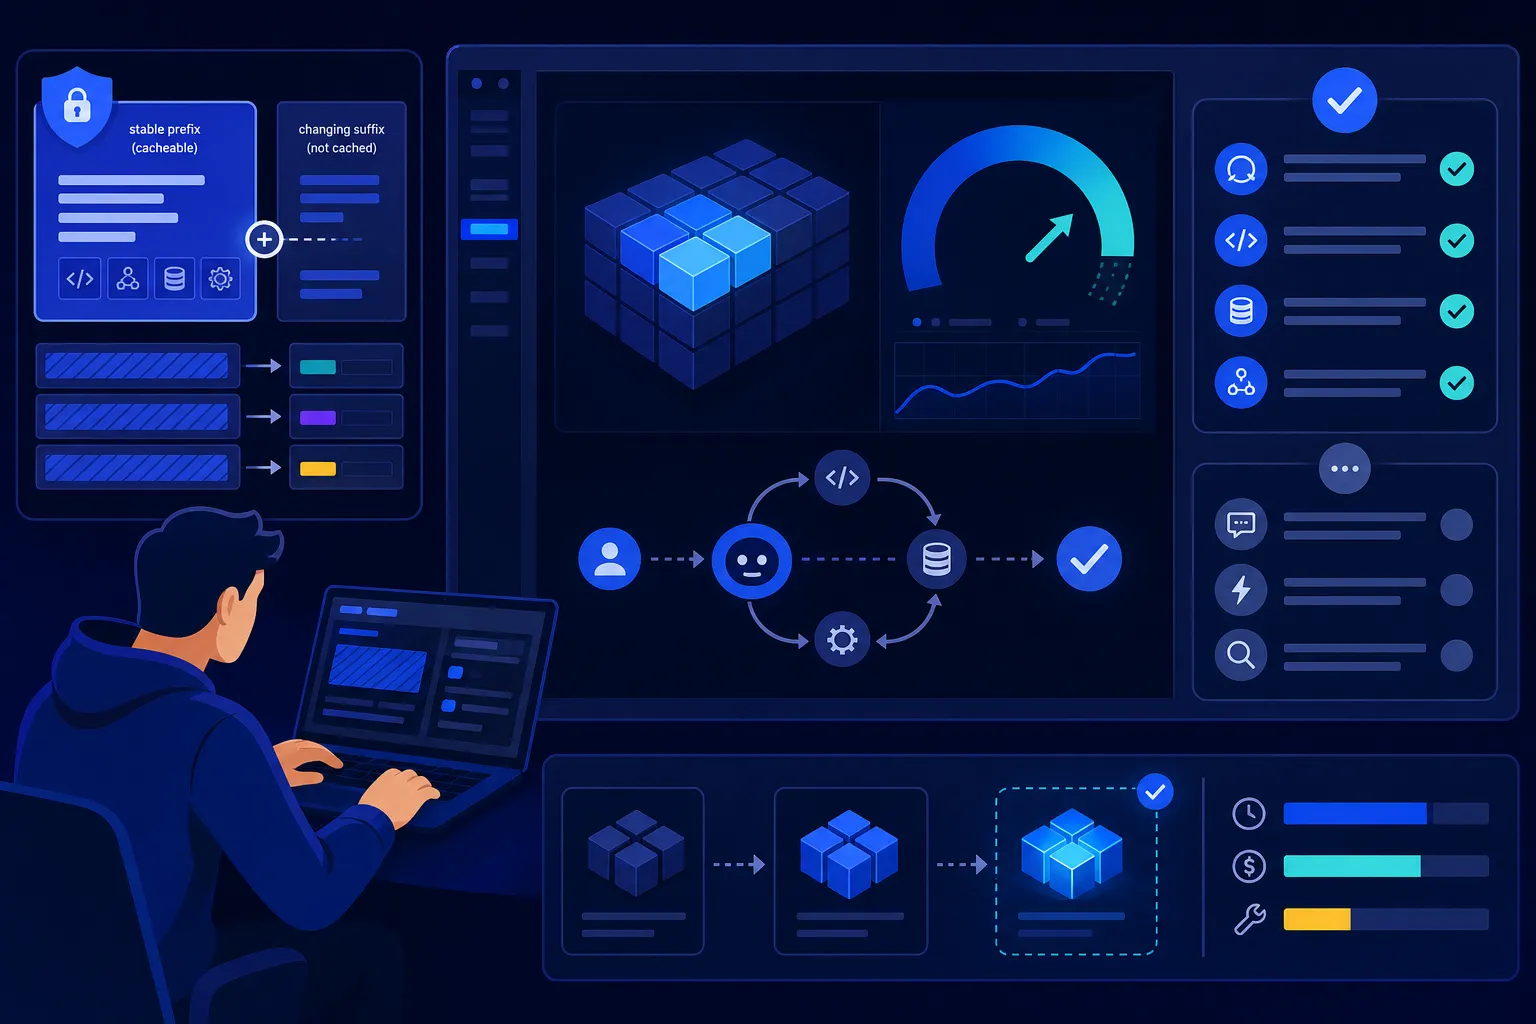
Ręczny bufor promptu w GPT-5.6: kiedy naprawdę tnie rachunek?
4 min
GPT-5.6 trafił do ogólnej dostępności na Amazon Bedrock, a AWS dołożył ręczne sterowanie buforem promptu: sam wyznaczasz koniec powtarzalnego prefiksu, który potem czytasz z pamięci o 90% taniej przez 30 minut. Nowość ma drugą stronę, bo zapis do bufora, dotąd darmowy na GPT-5.5 i 5.4, kosztuje teraz 1,25 raza więcej niż zwykły token wejściowy, więc realnie oszczędzasz dopiero, gdy odczyty stanowią około 20% ruchu. To wygrana dla pętli agenta, gdzie ten sam prompt systemowy wraca dziesiątki razy, a przy pojedynczych zapytaniach najwięcej zyskujesz, zostając przy trybie automatycznym.
 Premiera / Narzędzie
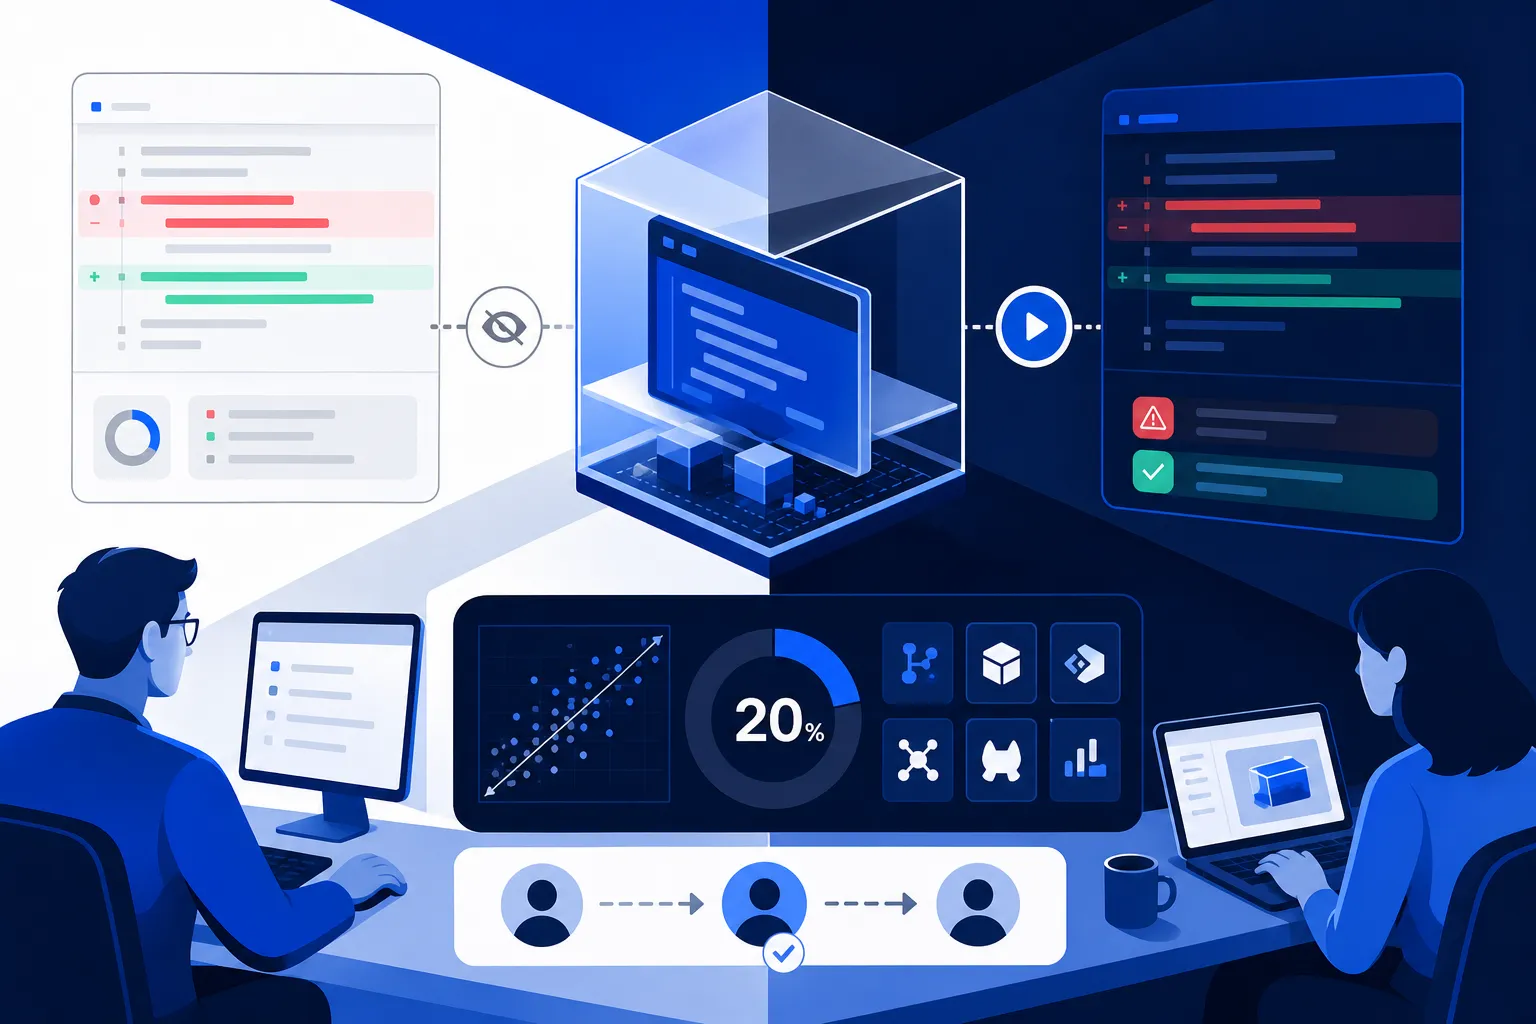
Greptile uczy swojego bota odpalać kod pull requesta, nie tylko go czytać
3 min
Greptile wypuściło w becie TREX, funkcję przeglądu kodu, która pull requesta nie tylko czyta, ale faktycznie odpala go w sandboksie i wyłapuje błędy widoczne dopiero przy uruchomieniu, jak wyścigi między żądaniami czy wycieki sekretów. Zamiast tekstowego ostrzeżenia zostawia dowód pod pull requestem, log z przebiegu albo nagranie klikania po interfejsie, czego trudniej zignorować niż zwykłą adnotację bota. Chwaloną liczbę, około 20% więcej złapanych błędów, Greptile podaje jednak bez opisu metody, więc sam pomysł kupuję, tej liczby nie, dopóki nie zobaczę jej na cudzym repozytorium.
 Premiera / Narzędzie
Nowy benchmark Supabase pokazuje, czego agenty nie doczytują
4 min
Supabase 31 lipca udostępnił Evals, otwarty benchmark, który uruchamia agenty AI na żywej bazie i sprawdza, jak stawiają schemat i reguły bezpieczeństwa, a nie tylko czy piszą poprawny kod. Powód jest konkretny: ponad 60% nowych baz zakłada u firmy narzędzie AI, a nie człowiek. Najciekawsze okazały się nawyki agentów, czyli ręczne migracje mimo deklaratywnego schematu i rozjazd w czytaniu dokumentacji, gdzie Codex zaglądał średnio do ośmiu stron na scenariusz, a Claude Code do dwóch. Test projektuje jednak sam Supabase, który na każdym agencie zarabia, więc nie jest neutralny.
 Premiera / Narzędzie
MiniMax sprzedaje już agenta, nie tylko tani model, ale dowodem są głównie dema
3 min
MiniMax wychodzi poza tani model i sprzedaje agenta pod hasłem "Code is cheap, show me the requirement", ale ogłoszenie to dobrane przez firmę dema, bez benchmarku i wyniku na SWE-Bench. Dla programisty konkretem jest natywna integracja z MCP, dzięki której agent sam sięga do GitHuba, GitLaba, Slacka czy Figmy zamiast ręcznego wklejania. Sam żongluje kilkoma modelami naraz, co, jak przyznaje firma, kosztuje i obniża wydajność, więc hasło o tanim kodzie na razie się nie broni. Jedyny twardy sygnał to fakt, że po niecałych 60 dniach stał się codziennym narzędziem ponad połowy zespołu MiniMaxa.
 Premiera / Narzędzie
Kiedy naprawdę warto zbudować graf wiedzy zamiast zwykłego RAG-u?
3 min
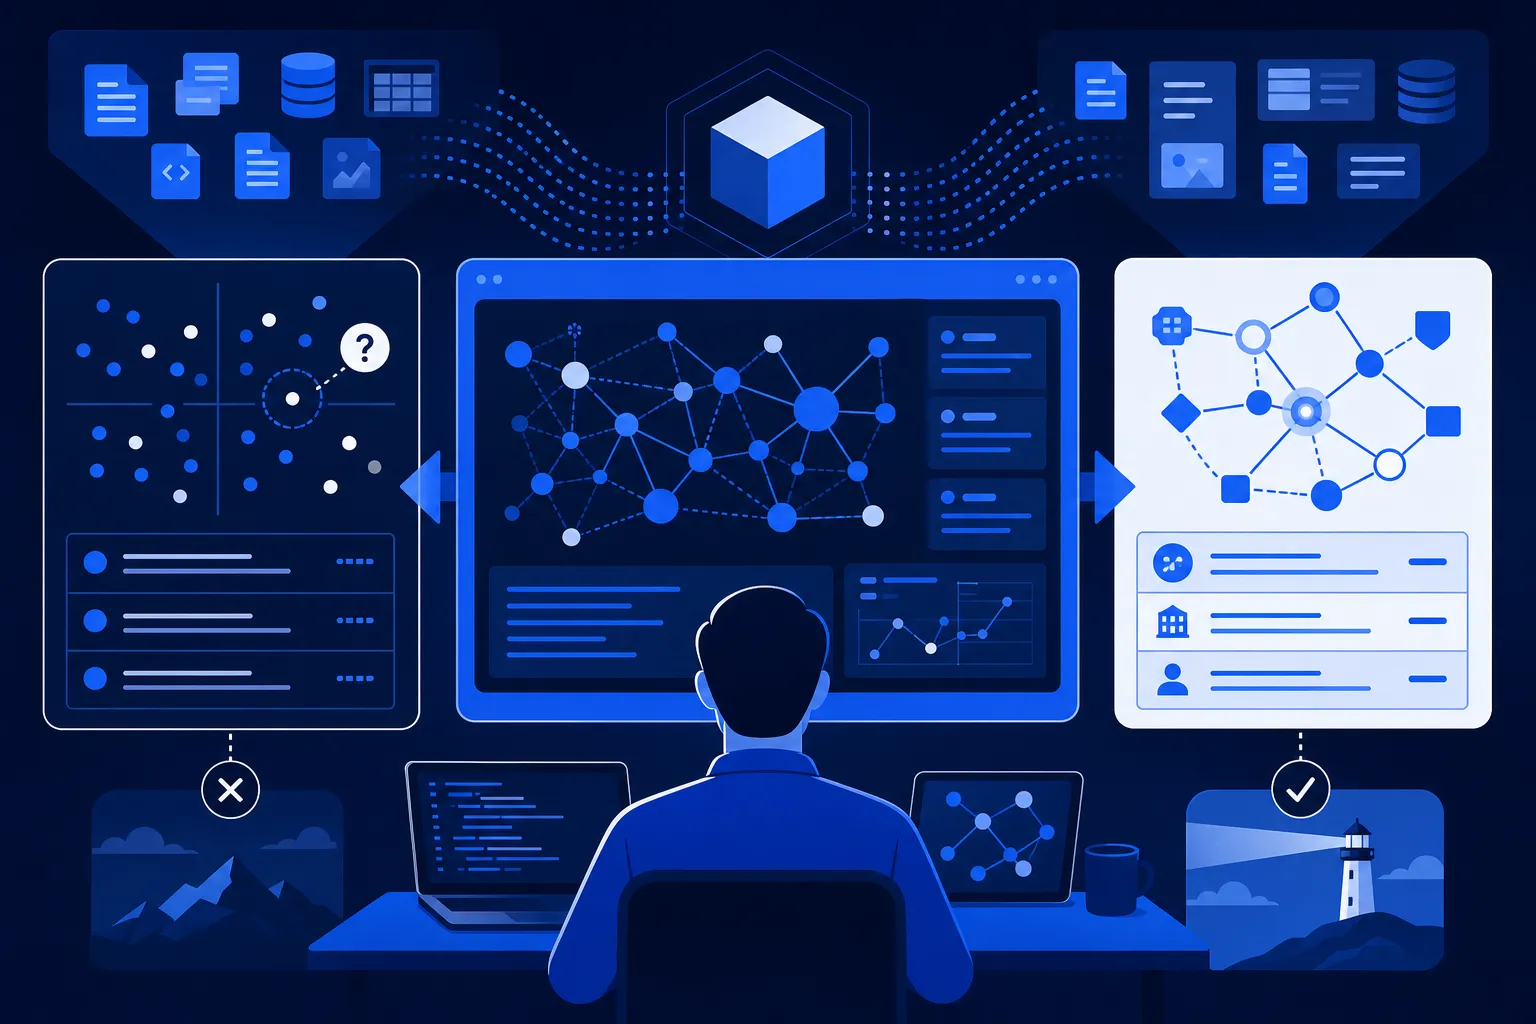
GraphRAG od Microsoftu znów zbiera rozgłos i 35,1 tysiąca gwiazdek na GitHubie, ale to nie darmowe ulepszenie zwykłego RAG-u. Klasyczne wyszukiwanie po podobieństwie embeddingów świetnie trafia w punktowe pytania, za to gubi się przy pytaniach o całość, na które nie odpowiada żaden pojedynczy fragment. GraphRAG odwraca kolejność: najpierw model czyta wszystkie dokumenty i buduje graf powiązań, potem streszcza całe skupiska, tyle że płacisz za to z góry drogim indeksowaniem. Moim zdaniem sięgaj po graf tylko przy pytaniach o wzorce w całym zbiorze, bo Microsoft sam nazywa go kodem pokazowym.
 Premiera / Narzędzie
JetBrains otwiera KotlinLLM: model dopisuje kod, który zostaje w repo jak każdy inny
3 min
JetBrains Research udostępnił na licencji Apache 2.0 KotlinLLM, wtyczkę do IntelliJ IDEA, która odwraca podejście do modeli w gotowej aplikacji: wywołanie asLlm model uzupełnia kodem Kotlina dopiero przy nieobsłużonej sytuacji, a poprawkę podmienia w locie przez JDI. Gotowy kod ląduje w repozytorium jak każdy inny plik, więc na produkcji modelu już nie ma, a wywołanie LLM staje się jednorazowym kosztem z etapu pisania. W testach 24 scenariusze przeszły po dopracowaniu, ale sam JetBrains studzi zapał: to prototyp badawczy, nie środowisko produkcyjne.
Tydzień 30 · 20–26 lipca 2026
 Premiera / Narzędzie
Cursor sam wybiera model do każdego zapytania i obiecuje 60% oszczędności
4 min
Cursor Router, uruchomiony w tym tygodniu, kieruje każde zapytanie do najtańszego modelu, który sobie z nim poradzi: rutyna trafia do tanich modeli, a trudne problemy do najdroższych. Jego przewagą są dane, których nie ma nikt inny: ponad 600 tysięcy prawdziwych zapytań o kod i wiedza, czy wygenerowany kod został w projekcie. Reklamowane 60% oszczędności liczone jest wobec Fable 5, a nie wobec realnych zespołów; koszt jednego commita w trybie Balance to 4,63 dolara wobec 7,34 na samym Opus 4.8. Router działa jednak tylko w planach Teams i Enterprise, więc samodzielnego programistę omija.
 Premiera / Narzędzie
Najdroższy model potrzebny tylko do planu, resztę zrobi tańszy
3 min
Cursor dał rojowi agentów 835 stron dokumentacji SQLite i kazał odtworzyć bazę w Rust bez kodu źródłowego, a efekt przeszedł 100% ukrytych testów. Prawdziwy wniosek leży jednak w rachunku: przy niemal identycznej jakości koszt rozjechał się od 1339 dolarów, gdy planował Opus 4.8, a wykonywał tani Composer 2.5, po 10 565 dolarów za GPT-5.5 grający obie role naraz. Sztuczka polega na tym, że najdroższy model tylko rozbija cel na jednoznaczne instrukcje, a tańszy je wykonuje, bo naprawdę mało momentów w dużym zadaniu wymaga najkosztowniejszej inteligencji.
 Premiera / Narzędzie
Czy agent do kodu, który gada jak kolega, pisze lepszy kod?
3 min
Cognition, twórca autonomicznego agenta Devin, zapłaciło ponad 100 milionów dolarów za Poke, asystenta żyjącego w SMS-ach i iMessage. Oficjalnie kupuje osobowość, bo Poke jest proaktywny i miło się z nim rozmawia, ale sedno leży gdzie indziej: współzałożyciel Poke, Marvin von Hagen, widzi w nim warstwę rozdzielającą pracę na kilka równoległych sesji Devina i pamiętającą, co każda zdążyła zrobić. To odpowiedź na realny brak dzisiejszych agentów do kodu, które każdą sesję zaczynają z czystą kartą. Pełne połączenie z modelem SWE-1.7 ma jednak ruszyć dopiero w przyszłym roku.
 Premiera / Narzędzie
LM Studio wypuszcza Bionic, lokalnego agenta, który nie oddaje twojego kodu w chmurę
3 min
LM Studio wypuściło 22 lipca Bionic, agenta, który pisze kod i składa dokumenty na tej samej lokalnej infrastrukturze co czat, więc kod nie wędruje na cudze serwery. Więcej niż sam agent waży cicha aktualizacja 0.4.20: dzięki LM Link ciężki model chodzi na mocnej stacji, a pracujesz na lżejszym laptopie, zespół może też wskazać jeden model serwowany w sieci firmy, zamiast trzymać osobną kopię u każdego dewelopera. Do najtrudniejszych zadań Bionic i tak sięga po GLM 5.2 czy DeepSeek V4 Pro w płatnej chmurze Secure Cloud, a na razie działa tylko na Windowsie i macOS.