Premiera / Narzędzie
Tydzień 30 · 20–26 lipca 2026
 Premiera / Narzędzie
Microsoft wypuszcza SkillOpt, narzędzie do trenowania promptów bez ruszania modelu
3 min
Microsoft wypuścił na GitHubie SkillOpt, narzędzie na licencji MIT, które nie dotyka modelu, tylko po kolei poprawia plik z instrukcjami wczytywany przez agenta na starcie zadania. Zmiany proponuje osobny model-optymalizator, ale żadna nie wchodzi do pliku, dopóki nie udowodni na odłożonym zbiorze zadań, że realnie podnosi wynik. Repozytorium chwali się rezultatem najlepszym lub na równi w 52 z 52 układów i ponad 23 punktami skuteczności na GPT-5.5. Wydanie 0.2.0 dokłada nocny silnik SkillOpt-Sleep, ale to część eksperymentalna, a liczb nikt spoza Microsoftu jeszcze nie potwierdził.
 Premiera / Narzędzie
WrenAI każe spisać reguły firmy, zanim agent napisze SQL
4 min
Canner wypuścił na licencji Apache 2.0 otwarte narzędzie WrenAI, które generuje SQL z pytań zadanych po ludzku na ponad 20 źródłach danych, od Postgresa po Snowflake i BigQuery. Nowość nie leży w samej zamianie pytania na zapytanie, tylko w tym, że Wren każe wcześniej spisać reguły firmy w wersjonowanej warstwie kontekstu: model semantyczny w formacie MDL, definicje biznesowe i pamięć sprawdzonych zapytań. Doczepia się do agenta, jak Claude Code czy Cursor, jednym poleceniem npx. Wartość jest w nadzorze i zwraca się dopiero, gdy zespół zainwestuje w utrzymanie tego kontekstu.
 Premiera / Narzędzie
Jak pozbyć się pętli, która czyści JSON po modelu
4 min
Outlines, biblioteka open-source firmy .txt, wymusza strukturę odpowiedzi modelu już w trakcie generacji: na każdym kroku wykreśla z listy możliwych tokenów te, które złamałyby zadany schemat, więc niepoprawny JSON nie ma jak powstać, a warstwa czyszczenia po fakcie znika. Piszący kod podaje tylko prompt i zwykły typ Pythona, od Literal po model Pydantic. Twarda gwarancja działa jednak wyłącznie na modelach uruchamianych lokalnie, bo przy zamkniętym API o format dba mechanizm dostawcy. Metoda z publikacji z 2023 roku pilnuje kształtu, nie prawdy.
 Premiera / Narzędzie
Czy warto indeksować całe repo, zanim agent zacznie pisać?
5 min
Anthropic i Augment Code spierają się na łamach Ars Technica o jedno: czy przed pracą agenta warto z góry zaindeksować całe repozytorium, czy lepiej, by model wyszukiwał kod grepem od nowa przy każdym zadaniu. Cat Wu z Anthropic nie widzi mierzalnej poprawy z bogatego kontekstu i celowo trzyma harness szczupłym, a Vinay Perneti chwali się, że na Terminal-Bench semantyka dała ten sam wynik o 33% taniej. Przyznaje jednak, że przewaga liczy się dopiero na dużych, prywatnych repozytoriach, których publiczne benchmarki nie mierzą, więc spór idzie o koszt tokenów, nie o samą trafność.
 Premiera / Narzędzie
Czat, repozytorium i agenty AI pod jednym dachem. Czy chcesz je tam trzymać?
4 min
21 lipca Jack Dorsey ogłosił Buzz, darmowy i otwarty na licencji Apache 2.0 komunikator, który łączy czat, hostowanie repozytoriów Git i agenty AI wpięte prosto w rozmowę, z własnym profilem i uprawnieniami. Najciekawszy jest fundament: protokół Nostr podpisuje kryptograficznie każdą wiadomość i każdy commit, więc powstaje niepodrabialny rejestr tego, który agent napisał dany kod. Reklamowana decentralizacja sprowadza się jednak do hostingu na własnym serwerze, a na przekaźnikach Block prompty nie są szyfrowane i mogą trafiać do Anthropic czy OpenAI.
 Premiera / Narzędzie
Twój serwer MCP przechodzi walidację. Czy agent w ogóle umie go użyć?
4 min
Serwer MCP może przejść każdy test zgodności ze specyfikacją i nadal być bezużyteczny dla agenta, bo protokół nie sprawdza opisów, nazewnictwa ani schematów. Teng, inżynier uczenia maszynowego w Zoomie, napisał mcpgrade wzorowany na Lighthouse i przeskanował 36 serwerów: 11 dostało ocenę D albo F, w tym oficjalny MongoDB, Notion i Airtable, a firecrawl-mcp zebrał 134 błędy, z czego 132 to nieopisane parametry. Test na żywym modelu to potwierdził: trafność wyboru narzędzia spadła u firecrawl do 84%. Recepta jest tania: dopisać do każdego parametru zdanie opisu z formatem i przykładem.
 Premiera / Narzędzie
Tokenizer 1000 razy szybszy od HuggingFace. Pytanie, czy tokenizacja w ogóle cię spowalnia.
4 min
Marcel Rød wypuścił Gigatoken, otwarty tokenizer, który na 144-rdzeniowym AMD EPYC przerabia tekst z prędkością 24,53 GB/s, około 1000 razy szybciej niż biblioteka HuggingFace. Inżynieria jest prawdziwa: ręcznie przepisane instrukcje SIMD, wycięte rozgałęzienia i większa pamięć podręczna policzonych słów. Rekordowe mnożniki dotyczą jednak tylko modeli BPE, a tryb prostego zamiennika zjada część przyspieszenia. Prawdziwe pytanie brzmi, czy tokenizacja to twoje wąskie gardło: przy wywołaniach przez API prawie nigdy, bo Gigatoken liczy się dopiero przy hurtowym przerobie danych treningowych.
Tydzień 29 · 13–19 lipca 2026
 Premiera / Narzędzie
Agent Weco przez osiem dni przepisywał sam siebie i pobił dwa lata pracy inżynierów
5 min
Weco skierowała swój autonomiczny agent badawczy na własny szkielet i po ośmiu dniach bez udziału człowieka system wymyślił wersję siebie lepszą niż ta, którą jej inżynierowie budowali przez dwa lata. Firma nazywa to pierwszym dowodem na rekurencyjne samodoskonalenie, ale uczciwie stawia się dopiero na pierwszym z czterech szczebli własnej drabiny. Zwycięski AIDE 85 pobił ręcznie strojonego agenta na trzech nieznanych mu benchmarkach i sam ograniczył naciąganie metryki z 63 do 34 procent, choć część jego kodu jest martwa i nikt nie wie, dlaczego całość wypada tak dobrze.
 Premiera / Narzędzie
Recenzja kodu, która nie zmyśla znalezisk
3 min
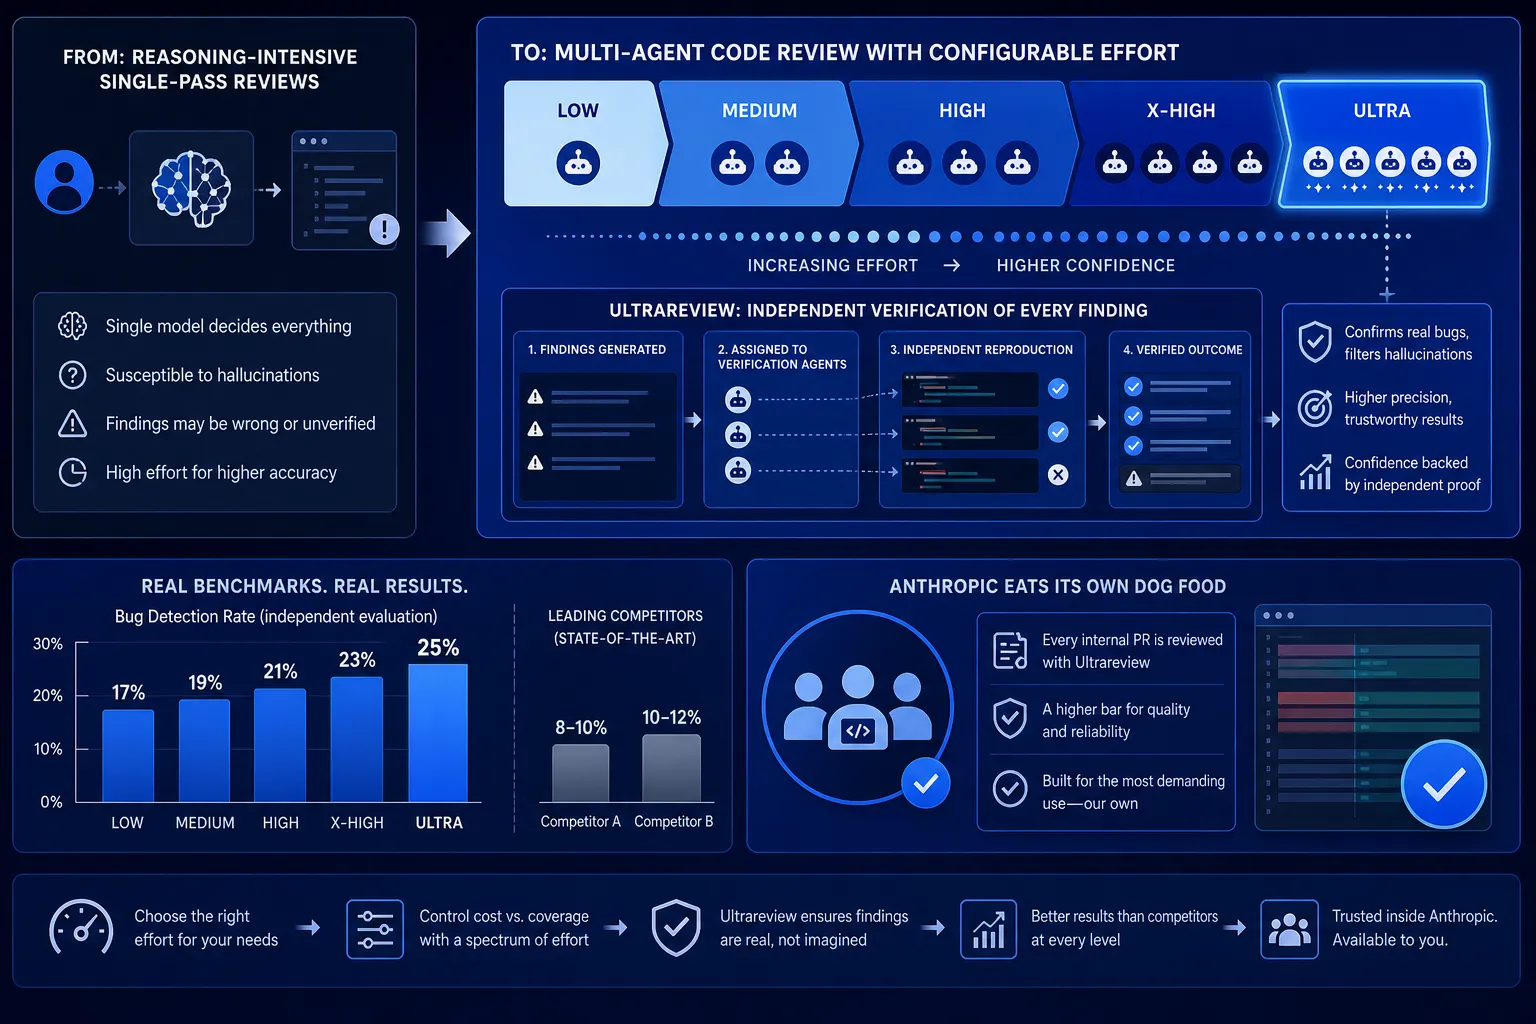
Anthropic przebudował recenzję kodu w Claude Code: zamiast jednego suwaka między krótszym a dłuższym myśleniem dostajemy pięć poziomów, od Low po Ultra. Najciekawszy jest tryb Ultra, który przenosi analizę do chmury i każdą zgłoszoną usterkę najpierw niezależnie odtwarza, więc do raportu trafiają tylko potwierdzone błędy, a nie zmyślony szum. Według domowych testów na Opusie 4.8 wykrywalność rośnie z 17% w najlżejszym trybie do 25% w najcięższym lokalnym, więc nawet on przepuszcza trzy czwarte usterek.
 Premiera / Narzędzie
OpenRouter sam wybiera model do kodu, ty podajesz tylko próg jakości
4 min
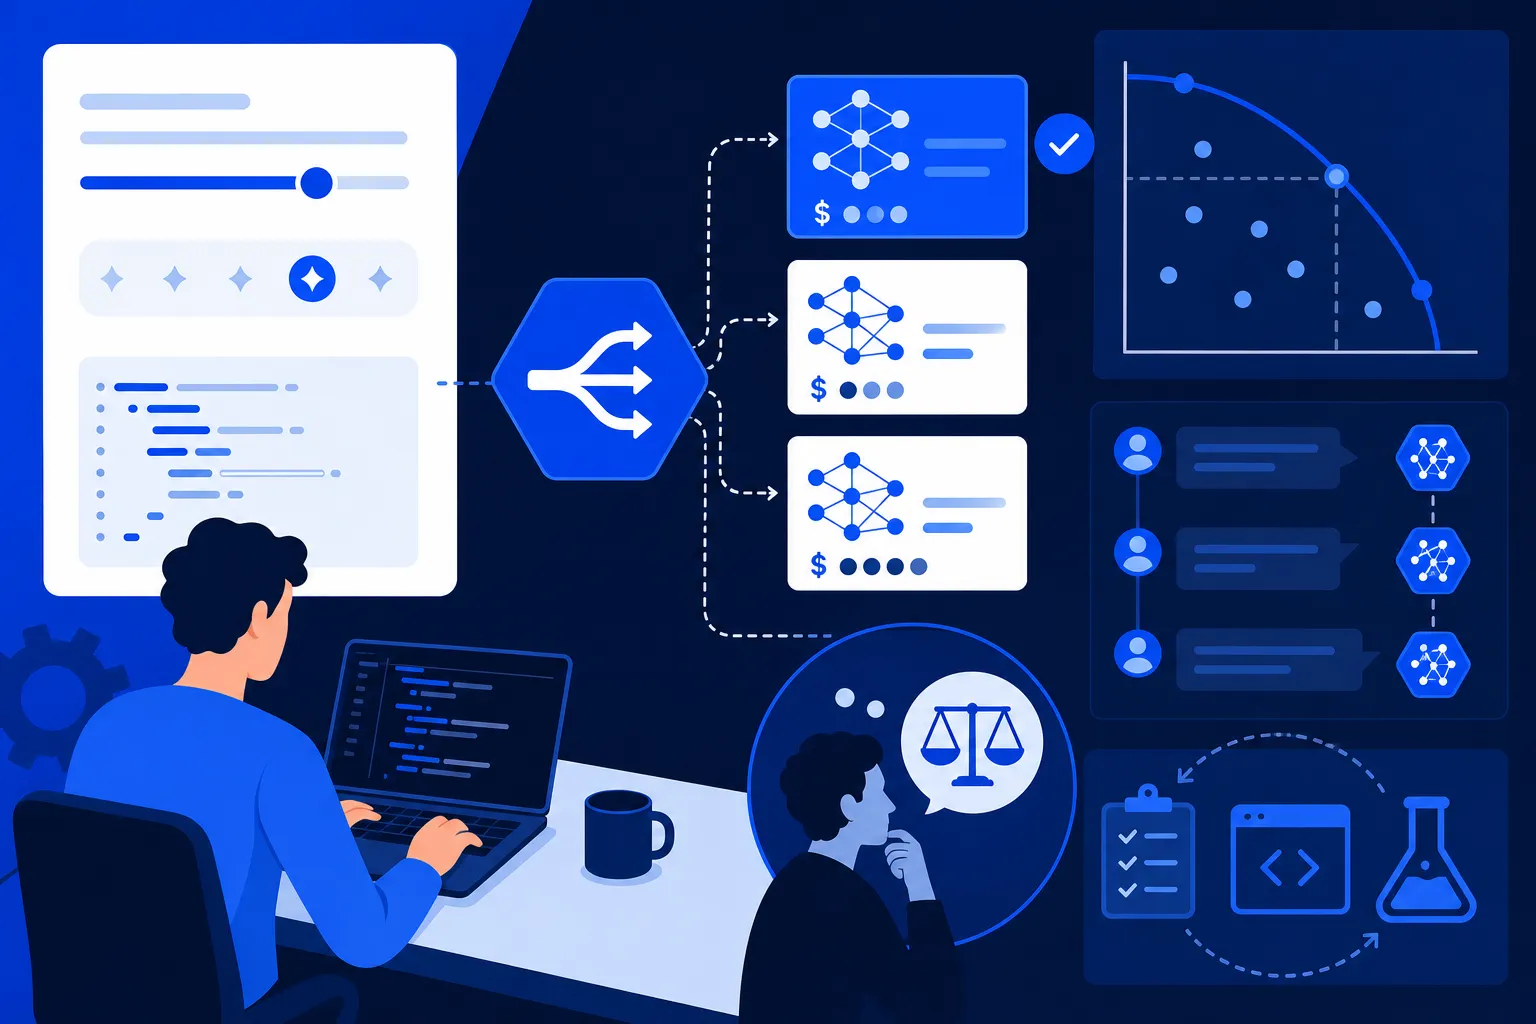
OpenRouter uruchomił router Pareto Code: zamiast wskazywać konkretny model do pisania kodu, podajesz jedną liczbę, min_coding_score od 0 do 1, a router sam dobiera najtańszy model mieszczący się w progu jakości według rankingu Artificial Analysis. Wybrany model zostaje przypięty do rozmowy na pięć minut, żeby nie stracić prompt cache. Pomysł oszczędza czas, gdy modele wymieniają się co tydzień, ale ma granice: nie ustawisz twardego limitu kosztu, a poziom jakości definiuje jeden uśredniony benchmark, który nie mówi, czy model trzyma się akurat na twoim kodzie.
 Premiera / Narzędzie
Twoje klucze, twoja maszyna, rachunek za AI niższy nawet o 70%
4 min
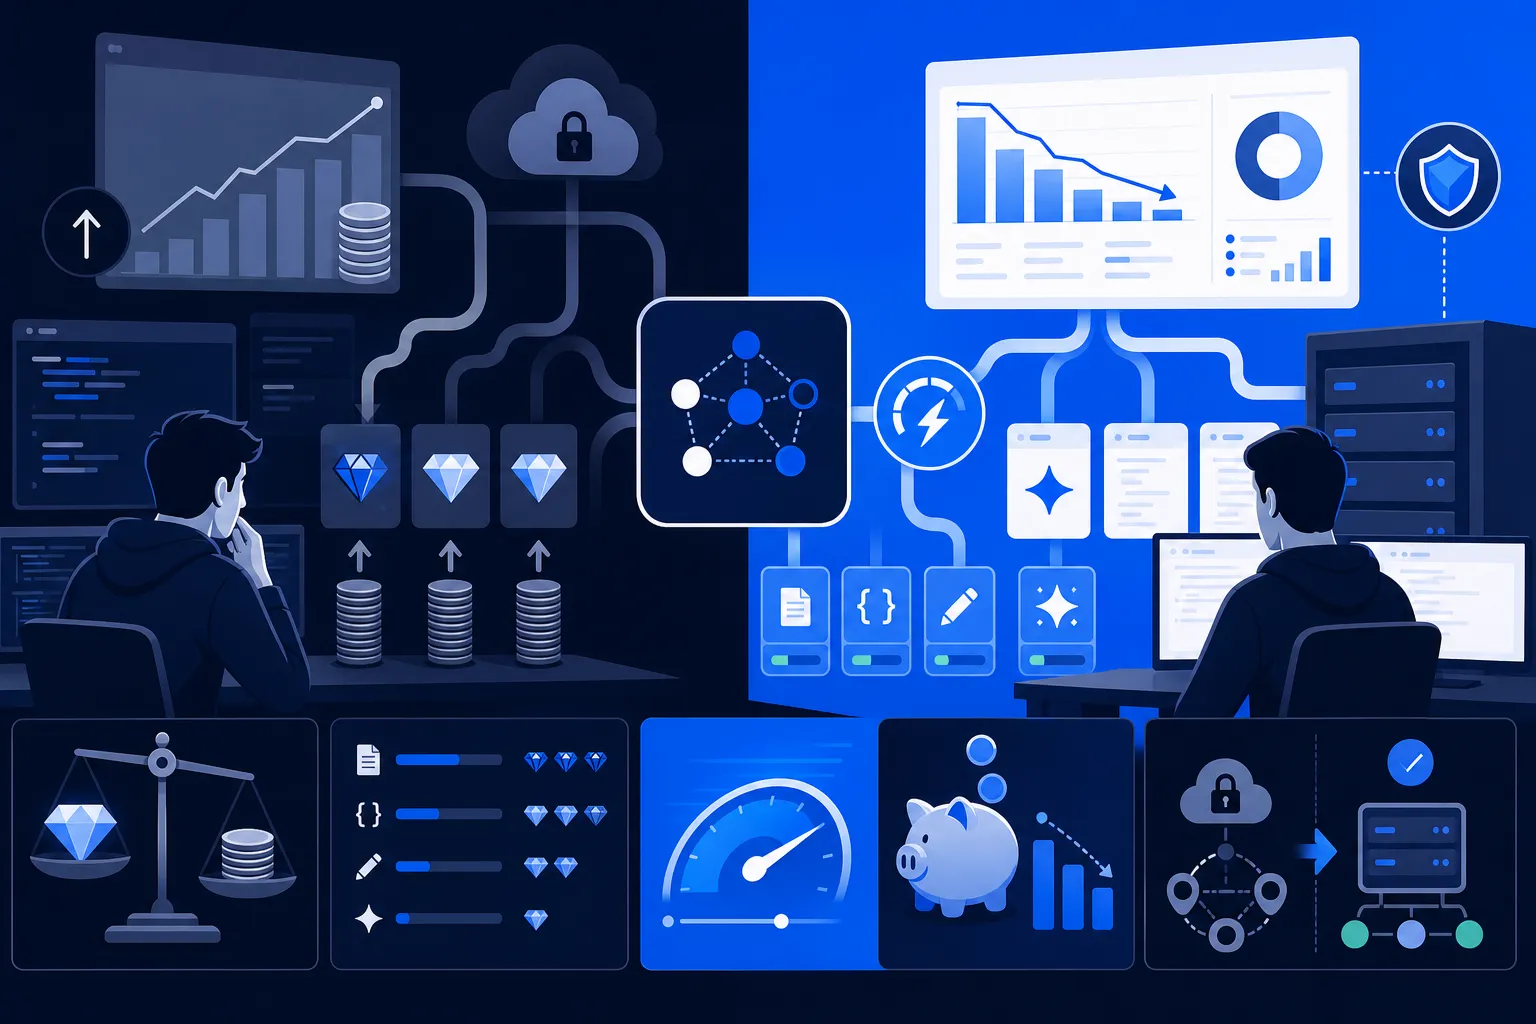
NadirClaw to otwarty router LLM, który uruchamiasz lokalnie jako pośrednik między narzędziem a dostawcą modelu, więc klucze API nigdzie nie wychodzą. Kieruje proste zapytania, czyli 60-70% typowej sesji, do tańszych modeli i sięga po mocniejszy dopiero, gdy tani nie da rady, a przy okazji kompresuje tokeny wejściowe o 30-70%, ścinając ośmiogodzinny dzień z Claude Code z około 24 do poniżej 11 dolarów. Haczyk w tym, że efektowne wyniki z rankingów pochodzą z płatnej wersji Nadir Pro, a otwarta licencja PolyForm Noncommercial i tak nie pozwala użyć go komercyjnie w firmie.
 Premiera / Narzędzie
OpenRouter Fusion: panel modeli i sędzia zamiast jednego pytania
4 min
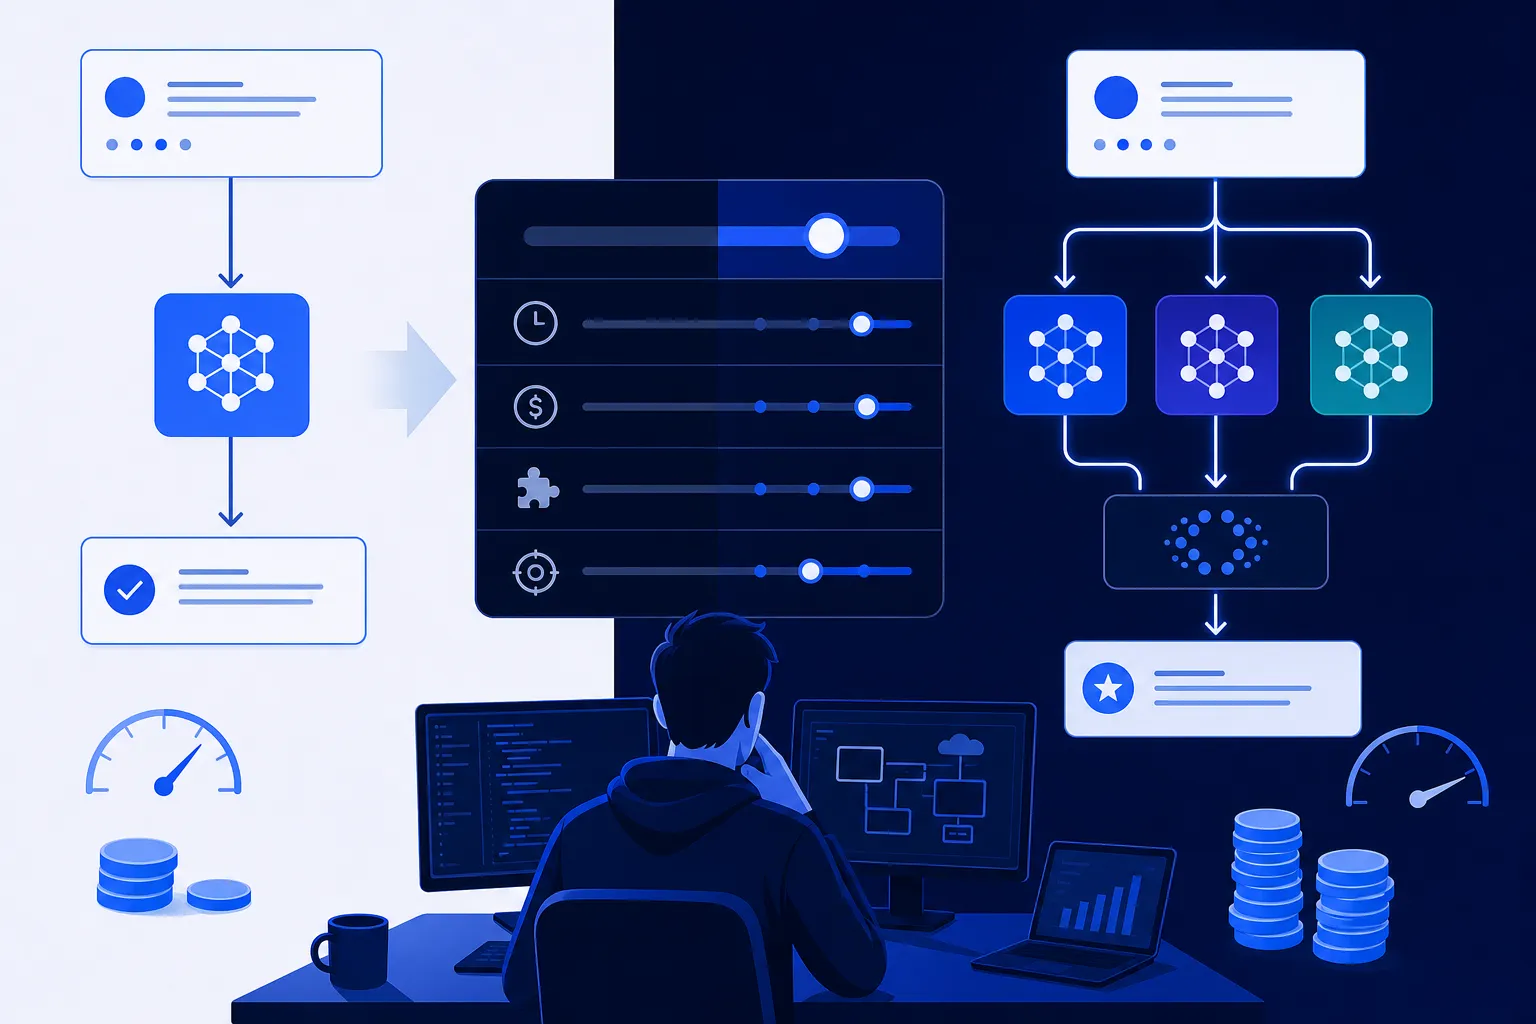
OpenRouter uruchomił 14 czerwca Fusion: ten sam prompt idzie do panelu kilku modeli, a osobny model-sędzia zestawia ich odpowiedzi i pisze z nich jedną. Na benchmarku DRACO trójka tańszych modeli sięgnęła 64,7%, o włos od najlepszego solisty Claude Fable 5 (65,3%), i to za połowę ceny. Sporo zysku bierze się nie z różnorodności modeli, tylko z drugiej próby i redakcji: Opus 4.8 sparowany sam ze sobą podskoczył z 58,8% do 65,5%. Fusion nie zastępuje modelu do kodu i trwa dwa do trzech razy dłużej, więc opłaca się dopiero tam, gdzie pomyłka kosztuje tydzień pracy.
 Premiera / Narzędzie
PR-AF stawia na wolną recenzję kodu i próbuje obalić własne uwagi, zanim je wyśle
4 min
PR-AF od Agent-Field to agent do recenzji kodu, który nad jednym pull requestem pracuje od 35 do 50 minut i zanim wyśle jakąkolwiek uwagę, próbuje ją najpierw obalić, przepuszczając dalej tylko te poparte dowodem z konkretnej linijki. Na benchmarku Code-Review-Bench z otwartym modelem GLM-5.2 osiąga 0,706 golden recall, pierwsze miejsce wśród narzędzi open-source w zestawieniu 42 pozycji, choć liczby pochodzą na razie od samych twórców. Ma być nie konkurencją dla Claude Code, tylko ostatnią bramką w GitHub Actions tuż przed mergem, z domyślnym limitem 2 dolarów na recenzję.
 Premiera / Narzędzie
Podręcznik dostrajania modeli, do którego trzeba się najpierw zapisać
4 min
Thinking Machines Lab udostępniło na GitHubie tinker-cookbook, otwartą bibliotekę dziewięciu gotowych receptur na dostrajanie modeli językowych, od trójstopniowego RLHF, przez destylację, po dane audio i modele wizualno-językowe. Kod jest otwarty, ale silnik pod spodem, Tinker, chodzi na serwerach firmy w zamkniętej becie, więc żeby cokolwiek uruchomić, trzeba poprosić o dostęp i czekać. W zestawie jest też framework do oceny z dwunastoma benchmarkami i dwie umiejętności dla Claude Code. Bliżej temu do podręcznika podpiętego pod lejek do API niż do narzędzia, które każdy odpala po południu.
 Premiera / Narzędzie
Mniej fałszywych alarmów, bo narzędzie kłóci się samo ze sobą
3 min
Capital One udostępniło 16 lipca jako open-source (Apache 2.0, GitHub) VulnHunter, agentowe narzędzie, które szuka podatności tak jak napastnik: startuje od punktów wejścia i idzie w przód przez logikę aplikacji, zamiast cofać się od groźnego wzorca. Jego falsification engine po znalezieniu dziury najpierw próbuje obalić własną tezę, więc do programisty trafia tylko to, czego narzędzie nie zdołało odrzucić, co ma ściąć lawinę fałszywych alarmów. Cała walidacja jest jednak wewnętrzna, a do uruchomienia potrzeba modelu Claude Opus 4.8 i środowiska Claude Code.
 Premiera / Narzędzie
Dlaczego lepsze narzędzia popsuły recenzenta kodu w Copilocie
3 min
GitHub podmienił narzędzia, którymi jego agent do recenzji kodu w Copilocie przeszukuje repozytorium, na wspólny uniksowy zestaw z Copilot CLI, i wyszło odwrotnie: recenzja podrożała, a agent łapał mniej problemów. Napalys Klicius prześledził zapisy przebiegu i zobaczył, że agent zwiedzał całe repozytorium zamiast badać jeden pull request, bo odziedziczył instrukcje pisane pod interaktywną pracę CLI. Przepisanie ich pod rytm recenzenta obniżyło koszt o około 20% przy tej samej jakości. Morał: na cudzym frameworku dziedziczysz nie tylko narzędzia, ale i zaszyte w ich opisach założenia o pracy.
 Premiera / Narzędzie
cangjie-skill zamienia książki i podcasty w testowane skille dla agentów
3 min
cangjie-skill, otwarte narzędzie dewelopera podpisującego się jako kangarooking, przerabia książki, wykłady i podcasty na pliki SKILL.md, które agent sam wywołuje przy pasującym zadaniu. Sercem jego procesu RIA-TV++ jest potrójna weryfikacja: przez sito co najmniej dwóch niezależnych potwierdzeń przechodzi zwykle 25 do 50 procent kandydatów, a to, co zostaje, jest jeszcze testowane pytaniami-pułapkami jak kod. W odróżnieniu od RAG, który zwraca najbardziej podobny fragment, gotowy skill z góry wie, kiedy ma się odpalić. Projekt jest jednak wczesny: ponad 20 paczek zrobił głównie sam autor.
 Premiera / Narzędzie
OpenAI sprzedaje klawiaturkę za 230 dolarów, żeby doglądać agentów
4 min
OpenAI wypuściło swój pierwszy sprzęt z własnym logo i nie jest to zapowiadany głośnik Jony'ego Ive'a, tylko Codex Micro, podświetlana klawiaturka za 230 dolarów zrobiona z Work Louder. Sześć kolorowych klawiszy pokazuje na żywo, na jakim etapie jest każdy agent Codexa, do tego dochodzi pokrętło do regulacji poziomu myślenia i joystick do gotowych scenariuszy. Całą konstrukcję trzyma teza, że praca programisty przestała polegać na pisaniu kodu, a zaczęła na doglądaniu floty agentów. Te same skróty odtworzysz jednak na Stream Decku za ułamek ceny.
 Premiera / Narzędzie
Open Interpreter obstawia, że o wyniku taniego modelu decyduje rusztowanie, nie wagi
3 min
Open Interpreter, przepisany w Ruście fork Codexa od OpenAI, stawia jedną tezę: o wyniku taniego modelu decyduje w dużej mierze rusztowanie wokół niego, a nie same wagi. Poleceniem /harness ubierasz model w otoczenie pożyczone od Claude Code, Qwena czy DeepSeeka, w nadziei, że tani model zbliży się do drogiego zestawu, a sesja agenta spadnie z kilkudziesięciu centów do groszy. Problem w tym, że repozytorium z 60 tysiącami gwiazdek pokazuje tezę bez ani jednej liczby, bez wyniku na SWE-Bench i bez porównania tego samego modelu w różnych rusztowaniach.
 Premiera / Narzędzie
Git, sandbox i dane ze stron: trzy premiery, których prawdziwym użytkownikiem jest maszyna
3 min
Na berlińskim WeAreDevelopers World Congress padły trzy premiery, które łączy jedno: narzędzia dla programistów projektuje się dziś pod agenta AI, nie pod człowieka. Thomas Dohmke, były szef GitHuba, wrócił ze startupem Entire, rozproszoną siecią Git trzymającą lustrzane kopie repozytoriów blisko agentów; Google pokazał Cloud Run sandboxes do bezpiecznego odpalania kodu, któremu nie można ufać; a Bright Data wypuściło Scraper Studio, które zwraca agentom czysty Markdown zamiast surowego HTML-a. Dwie z nich są dopiero w wersji zapoznawczej.
 Premiera / Narzędzie
Warp wpina recenzję kodu agenta w terminal, jeszcze przed commitem
3 min
Warp, terminal z wbudowanym agentem, dodał panel Code Review, w którym przeglądasz każdą zmianę agenta lokalnie, jeszcze przed commitem. Uwagi przypinasz do konkretnego pliku i linii, a Warp zbiera je wszystkie i wysyła agentowi naraz, który nanosi poprawki w jednym przebiegu i oddaje zaktualizowany diff. Możesz cofnąć pojedynczy fragment zmiany albo przełączyć widok na różnicę względem main, a panel działa z dowolnym agentem CLI, od Claude Code po agenta Warpa. Sedno jest takie, że narzędzie robi z przeglądu rzecz znośną, ale samego czytania kodu z nikogo nie zdejmuje.
 Premiera / Narzędzie
Dlaczego żaden model nie przekracza 25% na nowym benchmarku Scale?
3 min
Na nowym benchmarku SWE-Bench Pro od Scale Labs żaden model nie przekroczył 25 procent, a najlepszy GPT-5 rozwiązał tylko 23,3 procent zadań. Sekret tkwi w konstrukcji: 1865 zadań z 41 wciąż utrzymywanych repozytoriów, w tym z ukrytej i komercyjnej puli, której modele nie mogły zapamiętać podczas trenowania, gdzie pojedyncze zgłoszenie zajmuje inżynierowi kilka godzin lub dni. Agent radzi sobie z jedną funkcją, ale w cudzym, dużym projekcie gubi kontekst, więc lepiej samemu pokroić robotę na małe kawałki. Liczbę podaje firma, która sprzedaje ewaluacje, ale sygnał się trzyma.
 Premiera / Narzędzie
GitLab 19.2 wysyła agenty tam, gdzie zrobiło się wąskie gardło: do przeglądu i bezpieczeństwa
4 min
GitLab 19.2, wydany 16 lipca, przyjmuje diagnozę Manava Khurany, że agenty kodujące przesunęły wąskie gardło z pisania kodu na przegląd i bezpieczeństwo, i odpowiada na to kolejnymi agentami. Dependency Scanning Auto-Remediation sam otwiera merge requesta z poprawką podatnej zależności i iteruje, aż kompilacja przestanie się psuć, a Security Review Flow rozumuje o błędach w logice, których skanery wzorców nie wychwycą. Ostatnie słowo ma człowiek, tyle że im więcej pracy wpada do jego kolejki, tym łatwiej klika odruchowo „zatwierdź" i sam staje się nowym wąskim gardłem.
 Premiera / Narzędzie
Not Diamond trenuje router między modelami na twoich danych z ewaluacji
3 min
Not Diamond to framework, który zamiast ręcznie pisanych reguł sam uczy się kierować każde zapytanie do najlepszego z kilku modeli. Podajesz plik CSV z zapytaniami, odpowiedziami modeli kandydujących i własnymi ocenami tych odpowiedzi, wołasz train_custom_router i dostajesz identyfikator, którego select_model używa potem przy każdym prompcie. W przykładzie kandyduje pięć modeli, w tym GPT-5 i Claude Opus 4, a oceny pochodzą z HumanEval. Sednem są własne dane, ale to ich zebranie jest najdroższą częścią, a obietnica, że router pobije każdy model, to deklaracja producenta bez liczb.