Premiera / Narzędzie
Tydzień 29 · 13–19 lipca 2026
 Premiera / Narzędzie
Czy wyszukiwarka dla agentów bije zwykłe API? Google daje ją klientom, dowodów na razie brak.
4 min
16 lipca Parallel Web Systems, startup byłego szefa Twittera Paraga Agrawala, wpiął swoją wyszukiwarkę wprost do Gemini Enterprise Agent Platform, dzięki czemu przy składaniu agenta wybiera się ją jednym kliknięciem, a zużycie ląduje na tej samej fakturze Google Cloud co model i reszta. Cała przewaga leży w wygodzie: jedna konsola i jeden rachunek zamiast sklejania wyszukiwania, modelu i płatności od trzech dostawców. Że wyszukiwarka dostrojona pod modele jest realnie lepsza od zwykłego API, dowodów brak, bo nie ma ani liczb, ani porównań z konkurencją, choćby z Exą.
 Premiera / Narzędzie
Cursor dokłada boczne czaty i wyszukiwarkę, bo w sesji z agentem łatwo się zgubić
3 min
Najnowsza aktualizacja Cursora dokłada trzy rzeczy: boczne czaty (komenda /side lub /btw) biegnące obok głównej rozmowy z agentem, wyszukiwarkę po treści wcześniejszych rozmów opartą na lokalnym indeksie oraz hooki, które w agentach chmurowych sięgają teraz samego toku rozumowania modelu. Wspólny wątek jest jeden: sesje z agentem spuchły tak, że człowiek gubi się we własnej pracy. Boczne czaty i wyszukiwarka łatają tę złożoność, ale najwięcej wart jest ostatni kawałek, bo tylko hooki dają realnie nową możliwość, choćby pętlę samokorygującą wokół odpowiedzi agenta.
 Premiera / Narzędzie
Silnik w jednym pliku C uruchamia 744-miliardowy model bez GPU
3 min
Colibrì, jednoosobowy projekt open-source w jednym pliku C, uruchamia GLM-5.2 z 744 miliardami parametrów na zwykłym laptopie z 25 GB RAM, bez karty graficznej. Dzięki mieszance ekspertów silnik trzyma gęsty rdzeń w pamięci, a wyspecjalizowanych ekspertów podczytuje z dysku dopiero na żądanie. Ceną jest prędkość: od 0,05 do 0,1 tokena na sekundę na skromnym sprzęcie, choć na MacBooku M5 Max dochodzi do około 1 tokena. Pierwszy pomiar na skwantyzowanych do czterech bitów wagach dał 62,5%, a całość pokazuje, że sprzętowa ściana wokół modeli klasy frontier to kwestia inżynierii, nie prawo fizyki.
 Premiera / Narzędzie
Jeden plik Pythona zamiast bazy wektorowej: mind próbuje dać agentom pamięć
4 min
mind, jednoplikowe narzędzie Da7-Tech, próbuje dać agentom do kodu pamięć między sesjami bez embeddingów, bazy wektorowej czy zapytań do LLM: opiera się na wyszukiwaniu leksykalnym, grafie pojęć i ręcznym słowniku 83 mapowań, a nieużywane fakty gasną według krzywej Ebbinghausa. Autor podaje recall@1 równy 1,00 przy medianie 2,9 ms na grafie 1000 węzłów, choć sam przyznaje, że to tylko 20 zapytań na sztucznych danych. Największe pytanie nie dotyczy algorytmu, lecz tego, czy agent w ogóle zechce sięgnąć do pamięci wszytej w pliki CLAUDE.md i AGENTS.md.
Tydzień 28 · 6–12 lipca 2026
 Premiera / Narzędzie
37,5 tysiąca dolarów za małego Qwena obudowanego konsolą Pythona
4 min
Tufa Labs wygrało pierwszy etap konkursu ARC-AGI-3 i pulę 37,5 tysiąca dolarów rozwiązaniem zaskakująco skromnym: małym, otwartym modelem Qwen obudowanym prostym agentem, którego jedynym narzędziem była interaktywna konsola Pythona. Pobiło tym podejścia oparte na modelach wizyjno-językowych, choć samą grę jako pierwszy przeszedł dopiero większy GPT-5.6 Sol. Sedno brzmi nie "mały bije dużego", tylko subtelniej: gdy modele do kodu stają się towarem, prawdziwą przewagą jest harness, czyli minimalna pętla sterująca wokół modelu, którą da się złożyć samemu na laptopie.
 Premiera / Narzędzie
Obraz mieści trzy razy więcej treści na token, ale potrafi po cichu przekłamać identyfikator
5 min
pxpipe, otwartoźródłowe proxy dla Claude Code, przepisuje najcięższe fragmenty kontekstu na gęsto zadrukowane obrazy PNG, bo model płaci za obraz według pikseli, a nie tekstu: około 3,1 znaku na token obrazu wobec jednego na token tekstowy. Rachunek spada o 59-70% liczone od początku do końca, a w nagraniu demo sesja kończy się na 6,06 dolara zamiast 42,21. Problem w tym, że obrazowanie jest stratne i model po cichu zmyśla przekłamane znaki, więc identyfikatory, sekrety i najświeższe tury zostają tekstem.
 Premiera / Narzędzie
AgentField bierze na siebie to, czego frameworki agentowe nie robią: produkcję
3 min
AgentField, otwarty projekt na licencji Apache 2.0, nazywa siebie warstwą sterującą nad agentami: logikę piszesz jak zwykłą funkcję w Pythonie, Go albo TypeScripcie, a projekt bierze na siebie to, czego frameworki pokroju LangChain czy CrewAI nie robią, czyli kolejkowanie, ponawianie po awariach i wgląd w produkcję. Kolejka trzyma się na PostgreSQL, więc po restarcie robota wznawia się od miejsca, w którym stanęła, a każdy agent dostaje własną kryptograficzną tożsamość zamiast wspólnego klucza API. Twórcy chwalą się przepływem na ponad 10 000 wywołań, ale to na razie liczby producenta.
 Premiera / Narzędzie
Agent pisze kod, a twoje pliki i tak zostają nietknięte
3 min
Shepherd, framework ze Stanforda, nagrywa uruchomienie agenta jako odwracalny zapis i odkłada wynik na bok, więc nie dotyka twoich plików, dopóki sam zmian nie zatwierdzisz. Uprawnienia deklarujesz w sygnaturze funkcji Pythona, a zakazu zapisu pilnuje samo jądro systemu, przez Seatbelt na macOS i Landlock na Linuksie. Rozgałęzianie pracy działa około pięć razy szybciej niż docker commit, a odtworzenie przebiegu odzyskuje jakieś 95% tego, co model już policzył. Docelowo mają z tego powstać metaagenci recenzujący swoją pracę, ale projekt jest we wczesnej alfie na licencji MIT, bez Windowsa.
 Premiera / Narzędzie
Agent Gemini może teraz działać w tle. Google nie mówi tylko, jak długo.
3 min
7 lipca Google dołożył do Managed Agents w Gemini API cztery możliwości, a najważniejsza pozwala odpalić agenta w tle parametrem `background: true` i odpytywać go po identyfikatorze, zamiast trzymać kruche otwarte połączenie HTTP przez cały czas pracy. Doszły też połączenie wprost ze zdalnym serwerem MCP, wywoływanie własnych funkcji i odświeżanie poświadczeń w locie. Fundament jest solidny, tyle że brakuje jednej liczby: Google nie mówi, jak długo takie zadanie może chodzić w tle, zanim się urwie — a to funkcja, która ma sens wyłącznie dla długiej roboty.
 Premiera / Narzędzie
Osobista konfiguracja agenta jako publiczne repo na licencji MIT
3 min
David Ondrej wrzucił 7 lipca na GitHuba repozytorium skills na licencji MIT: oczyszczony zrzut własnego zestawu procesów dla agentów. Każdy proces to osobny folder z plikiem SKILL.md, który mówi agentowi, kiedy go uruchomić, a całość dzieli się na pięć kategorii, w tym warstwę meta ze skillami do pisania kolejnych skilli. W kilka dni zebrało 1700 gwiazdek i 226 forków. Sedno leży we wzorcu: osobista konfiguracja agenta staje się publicznym, forkowalnym repo, jak dawniej dotfiles, tylko warstwę wyżej. Tyle że README to jeszcze nie dowód, że skille zadziałają u ciebie.
 Premiera / Narzędzie
Co, jeśli lepszy agent nie potrzebuje większego modelu, tylko lepszego harnessu?
3 min
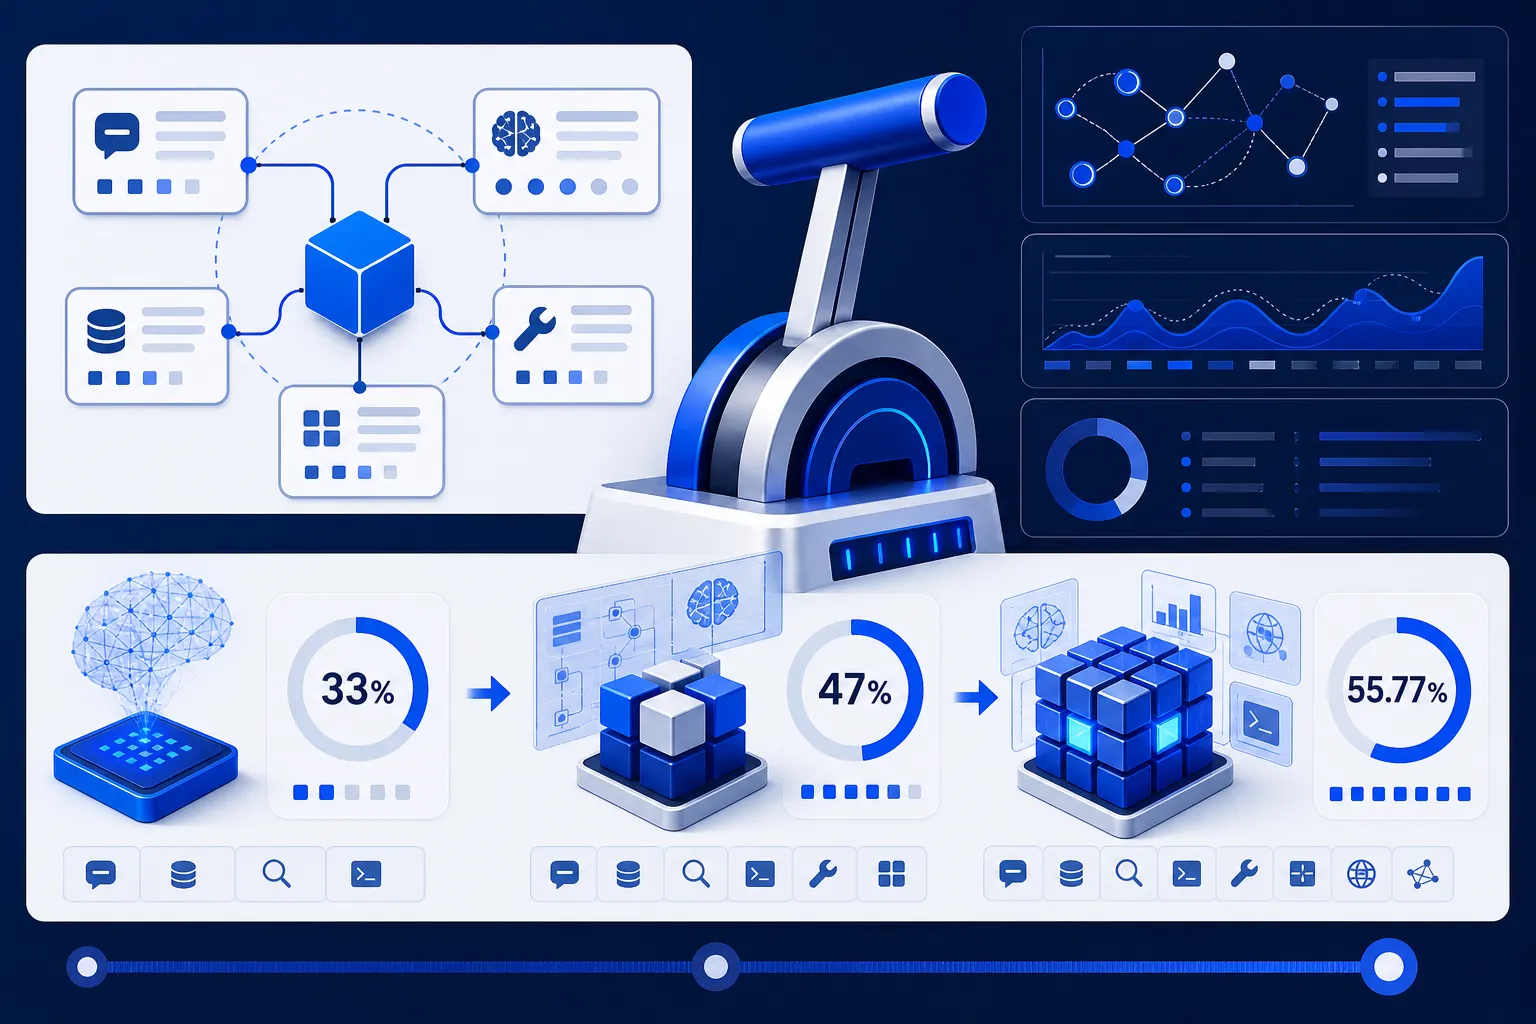
HarnessX, otwarty framework Darwin Agent na licencji MIT, traktuje harness — warstwę wokół modelu, która decyduje o narzędziach, pamięci i kontekście — jako wymienny klocek, ulepszany osobno od samych wag. Na Qwenie 3.5 9B sama przebudowa harnessu podnosi wynik na GAIA z 33,97% do 41,67%, a douczenie modelu RL-em dociąga go do 55,77%; ten sam schemat na GPT-5 idzie z 62% do 84%. Skłaniam się ku tezie, że architektura agenta to dźwignia, po którą sięga się za rzadko, ale liczby podał sam autor na jednym benchmarku, w wersji 0.1.0 beta, i wciąż czekają na niezależne powtórzenie.
 Premiera / Narzędzie
Format umiejętności dla agentów dostał własną specyfikację i otwartą licencję
4 min
Format umiejętności agenta, w którym cała procedura mieści się w jednym pliku SKILL.md, dostał własną specyfikację, licencję Apache 2.0 i formalny proces zgłaszania zmian. Sztuczką jest progressive disclosure: agent widzi na starcie tylko nazwy i opisy, a pełną treść wczytuje dopiero wtedy, gdy zadanie pasuje, więc może mieć pod ręką setkę umiejętności, trzymając w pamięci jedną. Anthropic oddał format jako otwarty standard, tak jak wcześniej MCP, ale repozytorium chwali się "rosnącą liczbą" produktów bez podania ani jednej konkretnej liczby.
 Premiera / Narzędzie
Model wymieniasz jedną linijką, całą resztę wynajmujesz od Vercela
4 min
Guillermo Rauch z Vercela stawia tezę, że model i agent powinny być rozłączne: sam model podmieniasz jedną linijką w AI SDK, a całą resztę wokół niego wynajmujesz. Skala robi wrażenie, bo przez wspólną bramę Vercela przechodzi codziennie ponad bilion tokenów, a połowę z 6 milionów wdrożeń odpalają już agenty. Po przejęciu Better Auth 7 lipca agent dostaje nawet własną tożsamość, oddzielną od człowieka, który go uruchomił. Tyle że każdy z tych klocków poza samym modelem jest produktem Vercela, więc odpinasz się od jednego laboratorium, a przywiązujesz do platformy pod spodem, jak przy AWS.
 Premiera / Narzędzie
Jedno wywołanie MCP i Claude Code czyta ci wynik na głos
3 min
Voicebox, otwarty projekt Jamiego Pine'a na licencji MIT, zbiera obie strony głosu lokalnie i podpina je do agentów kodujących przez MCP. Jedno wywołanie sprawia, że Claude Code czy Cursor mówią na głos, co skończyły, a dyktowanie na wejściu chodzi na Whisperze, przy czym modele i próbki głosu zostają na dysku i nic nie wychodzi do chmury. Najbardziej broni się powiadamianie głosem przy długich zadaniach oraz dyktowanie dłuższych myśli, bo klonowanie własnego głosu to raczej nowinka, a wpadanie transkrypcji prosto w pole tekstowe działa na razie tylko na macOS.
Tydzień 27 · 29 czerwca – 5 lipca 2026
 Premiera / Narzędzie
Jedna faktura czy pełne API? Claude w Azure każe wybrać
4 min
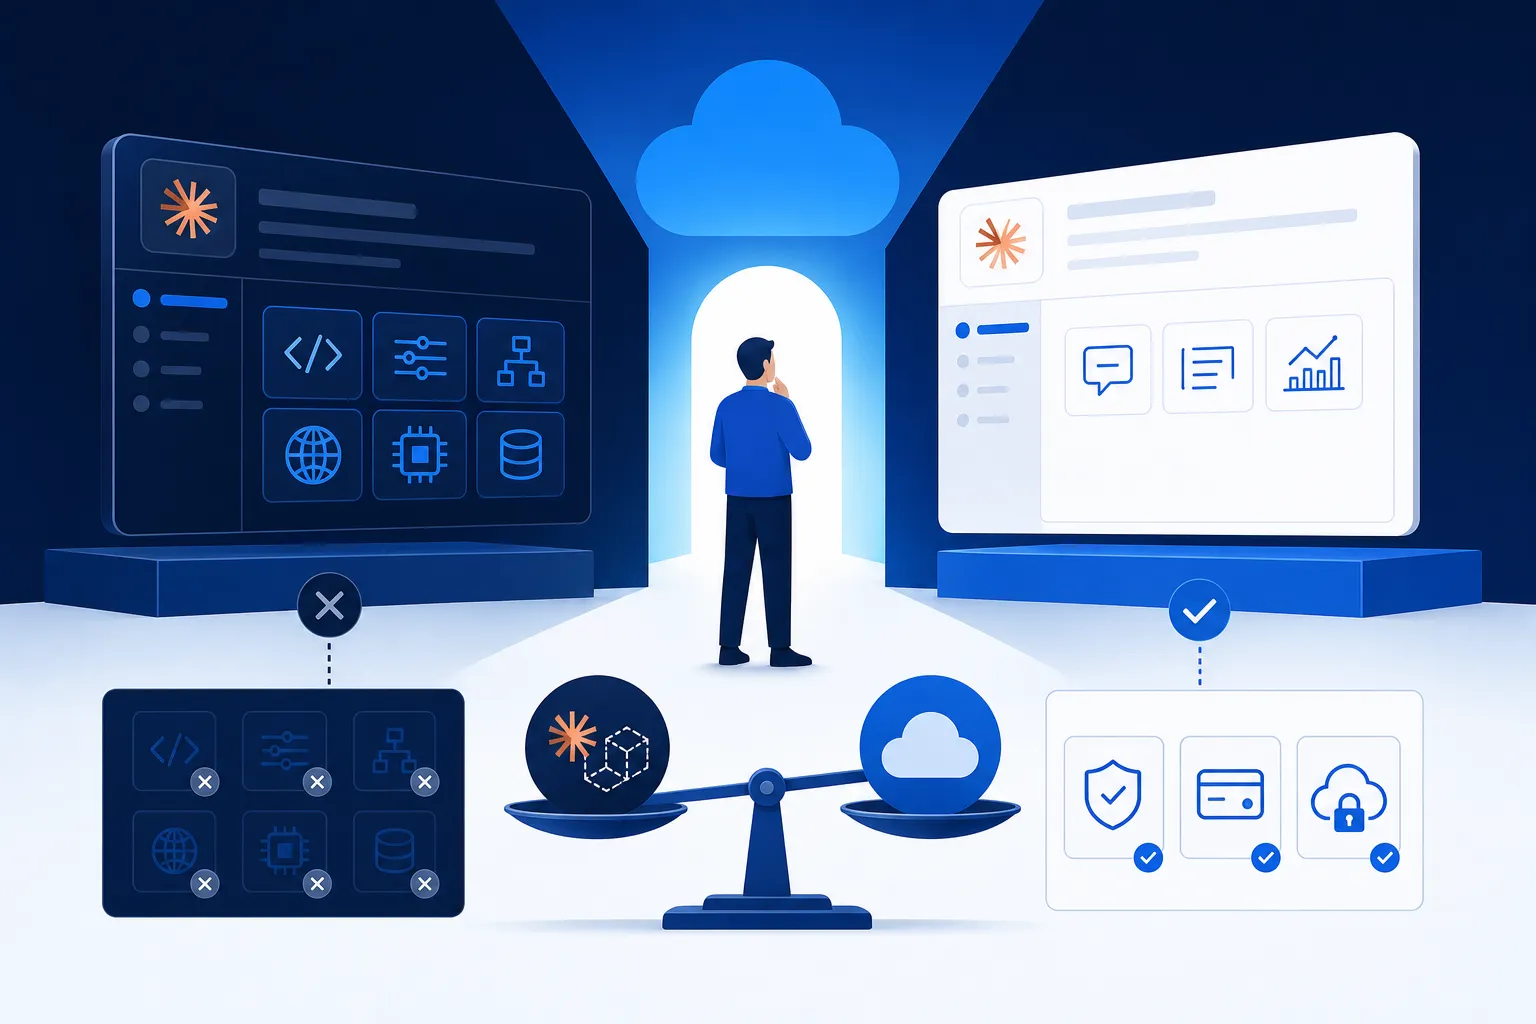
Od 29 czerwca modele Claude'a są ogólnie dostępne w Microsoft Foundry, a Anthropic każe zespołom z Azure wybrać jedne z dwojga drzwi. Wariant "hosted on Azure" zamyka rozliczenie na jednej fakturze i wpina model w firmowy nadzór, ale daje tylko Opus 4.8 i Haiku 4.5 przez Messages API. Druga ścieżka, przez Anthropic, oferuje pełne API i wszystkie modele kosztem osobnego rozliczenia. Za wygodę jednej faktury płaci się więc kompletnością, choć prompt caching i rozszerzone myślenie działają od startu. Anthropic zapowiada zrównanie obu ścieżek, ale terminu nie podaje.
 Premiera / Narzędzie
Cognition dostawia tani model do drogiego i ścina koszty o 35%
3 min
Cognition, twórca agenta Devin, wypuściło w podglądzie Devin Fusion, warstwę, która do drogiego topowego modelu dokłada drugi, znacznie tańszy, i każe im pracować równolegle: główny model planuje i robi przegląd, a pomocnik czyta pliki i wprowadza drobne zmiany. Cały zysk bierze się z cache, bo oba modele trzymają własny kontekst, a przełączanie między nimi wypada wtedy, gdy sesja i tak streszcza kontekst, więc wychodzi za darmo. Obiecane 35% oszczędności przy jakości Opusa 4.8 brzmi mocno, tylko że benchmark FrontierCode, na którym Fusion wypada tak dobrze, Cognition zbudowało samo.
 Premiera / Narzędzie
GitHub chce ujednolicić 30 agentów jedną specyfikacją
3 min
GitHub wydał na licencji MIT Spec Kit, zestaw narzędzi, który odwraca kolejność pracy z agentem: najpierw powstaje specyfikacja tego, co i po co budujemy, a dopiero z niej agent generuje kod. Prawdziwy zakład firmy to rozciągnięcie jednego formatu na ponad 30 różnych agentów naraz, w tym Claude Code i Copilota, żeby wartość została w trwałym pliku, a nie w konkretnym narzędziu. Sam GitHub nazywa to eksperymentem i przyznaje, że nie ma danych o szybszej pracy zespołów. Dla solowego programisty to głównie narzut, ale w zespole wspólny plan bywa wart więcej niż kod.
 Premiera / Narzędzie
Stary SWE-bench dawał ponad 80%, nowy ścina czołówkę do 23,3%
3 min
Scale AI wypuściło SWE-Bench Pro, zestaw 1865 zadań z 41 utrzymywanych repozytoriów, na którym najlepszy GPT-5 rozwiązał tylko 23,3% problemów, podczas gdy na starym SWE-benchu czołówka od miesięcy melduje wyniki powyżej 80%. Zadania są długodystansowe i wieloplikowe, a część pochodzi z prywatnych repozytoriów, których modele nie widziały na treningu, więc nie da się ich ugrać z pamięci. Surowa miara pass@1 i interes Scale każą czytać wynik ostrożnie, ale sygnał jest jasny: przy dłuższej robocie w firmowym projekcie wciąż jesteśmy bliżej wspomagania niż automatyzacji.
 Premiera / Narzędzie
Mapa kodu, którą agent pyta, zamiast czytać repozytorium plik po pliku
4 min
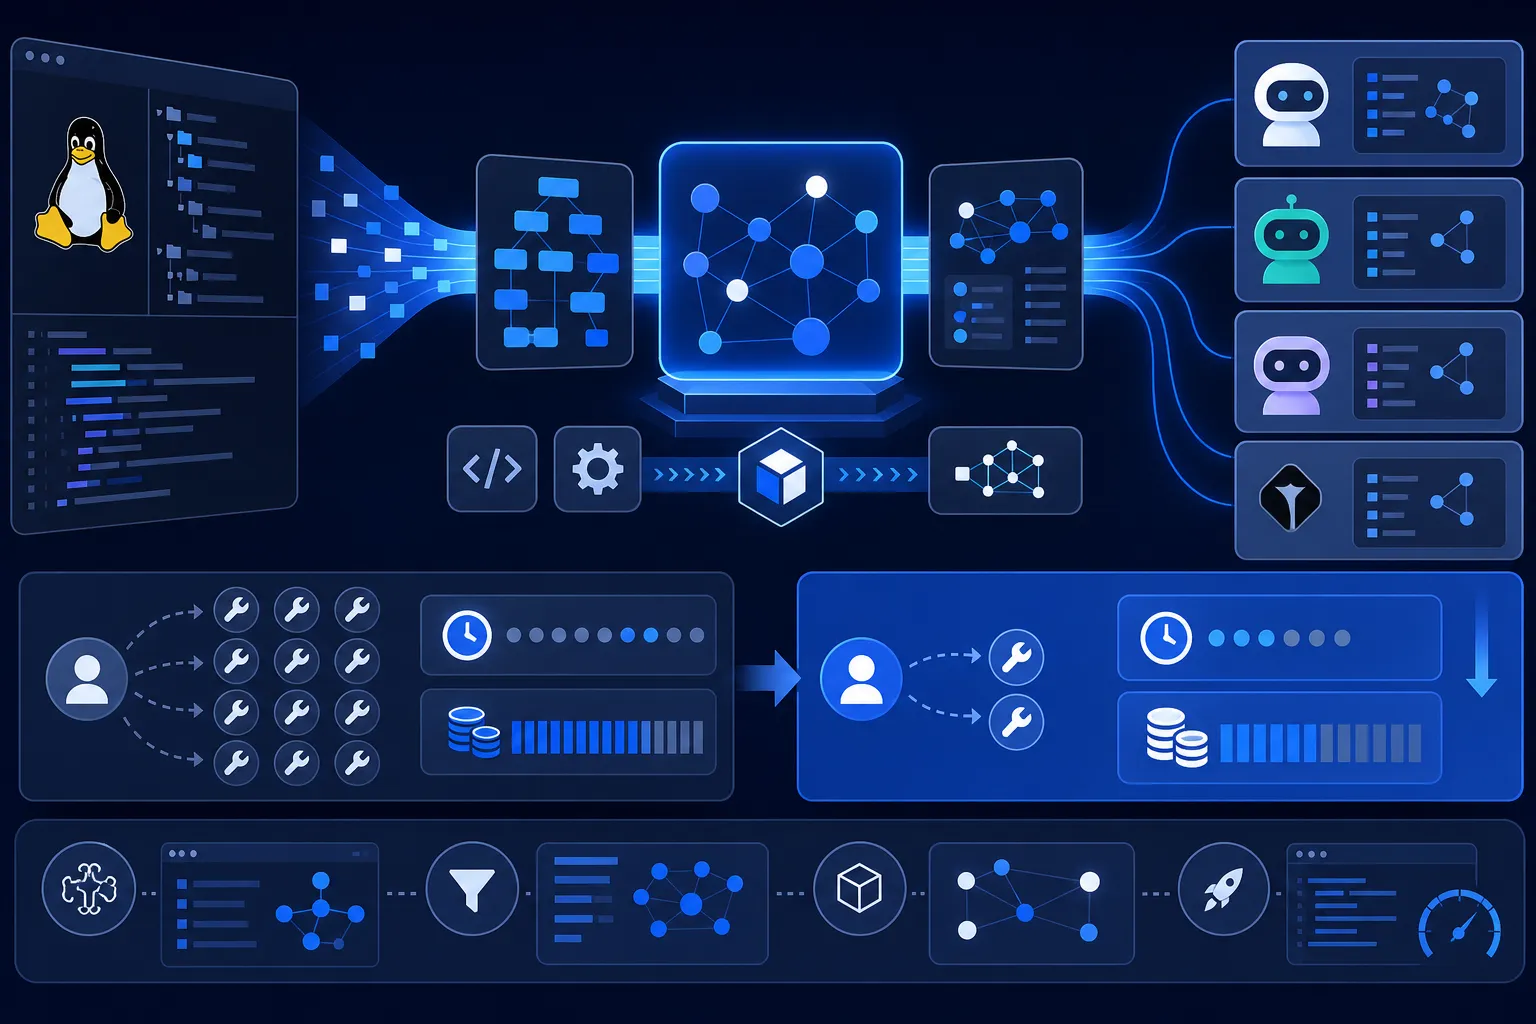
codebase-memory-mcp od DeusData raz indeksuje całe repozytorium w graf funkcji, klas i wywołań, dzięki czemu agent pyta gotową mapę, zamiast czytać plik po pliku i palić tokeny. Jądro Linuksa ogarnia w trzy minuty, a na zapytanie o strukturę odpowiada w niecałą milisekundę. Twórcy chwalą się oszczędnością do 99,2% tokenów w wybranym teście, ale ich preprint z 31 repozytoriów podaje skromniejsze 10× mniej tokenów i 2,1× mniej wywołań, a wszystkie te liczby pochodzą od nich i nikt ich jeszcze nie zrecenzował.
 Premiera / Narzędzie
Obscura chce zastąpić headless Chrome jedną binarką w Rust
4 min
Obscura to napisana w Rust binarka open-source, która ma zastąpić headless Chrome w zadaniach dla agentów AI: według autorów zużywa 30 MB pamięci zamiast ponad 200 MB i ładuje stronę w 85 ms zamiast około 500 ms. Wbudowany serwer MCP daje agentowi gotowe komendy do sterowania przeglądarką, ale pod etykietą "dla agentów" kryje się przede wszystkim scraper, bo sponsorzy README sprzedają proxy z domowych adresów IP. Projekt na licencji Apache 2.0 zebrał 10 000 gwiazdek na GitHubie, tyle że liczby wydajności pochodzą wyłącznie od autorów i nikt niezależny ich nie powtórzył.
 Premiera / Narzędzie
PMB trzyma pamięć projektu na twoim dysku, żeby agent nie pytał o wszystko od nowa
3 min
PMB, open-source'owy projekt Oleksija Bondara, trzyma pamięć projektu w lokalnym pliku SQLite i podaje ją agentom przez MCP, więc Claude Code, Cursor czy Codex nie zaczynają każdej sesji z pustą głową, bez chmury i bez kluczy API. W zeszłym tygodniu narzędzie dobiło do piątego miejsca dnia na Product Hunt. Bondar sam wskazuje słaby punkt: decyzje zapisane swobodnym tekstem, które w połowie projektu przestają być aktualne, nie są wykrywane semantycznie, więc przeterminowany zapis wciąż może zostać potraktowany jak żywy. Na razie to solidny fundament z uczciwie opisaną luką.
 Premiera / Narzędzie
Codex wypalał tygodniowy limit w dwa dni, a OpenAI zrzucił winę na wykrywanie oszustw
3 min
Programiści z planem Pro Codexa, agenta OpenAI do pisania kodu za 200 dolarów miesięcznie, wyczerpywali tygodniowy przydział w dwa dni zwykłą refaktoryzacją. Thibault Sottiaux, szef zespołu inżynierskiego Codexa, zrzucił winę na mechanizmy wykrywania nadużyć, które brały intensywną pracę za oszustwo, i wyzerował wszystkim liczniki, a 18 czerwca dorzucił podwójny reset. To łaty, nie naprawa: prawdziwy problem to cennik, który nie nadążył za tym, jak mocno ludzie realnie korzystają z agentów do kodu.
 Premiera / Narzędzie
Model przeczytał cały log dwa razy, żeby wyłuskać trzy linijki
4 min
Tejas Chopra prosił Claude'a o wskazanie awarii w logach, a jedno pytanie zjadło dwa okna kontekstowe i 287 dolarów miesięcznie, bo model raz za razem czytał całe logi, by wyłuskać trzy istotne linijki. Tak powstał Headroom, otwarta warstwa przycinająca kontekst, zanim ten doleci do modelu: wycina zbędne znaki z JSON-a (około 30% oszczędności), a oryginał chowa lokalnie na wypadek, gdyby model potrzebował pełnych danych. Chopra reklamuje 700 tysięcy dolarów oszczędności w pięć miesięcy, ale mocniejsza jest sama diagnoza: większość tego, czym karmimy modele, jest zbędna, a płacimy za wszystko.
 Premiera / Narzędzie
Zaufanie do AI spada, choć sięga po nią coraz więcej programistów
4 min
Choć według ankiety Stack Overflow z 2025 roku po narzędzia AI sięga albo zamierza sięgać 84% programistów, zaufanie do trafności ich podpowiedzi spadło do 29%, o jedenaście punktów mniej niż rok wcześniej, a najmniej ufają im ci najbardziej doświadczeni. Kłopotem są odpowiedzi prawie dobre: badanie METR pokazało, że z AI programiści pracowali o 19% wolniej, a analiza 470 pull requestów wykazała 1,7 raza więcej poważnych błędów w kodzie współtworzonym przez model. Praca nie znika, tylko przesuwa się w stronę recenzji i testów, co napędza firmy pokroju Qodo.