Wydanie · Tydzień 36 · 31 sierpnia – 6 września 2026
Archiwum wydań →Wybór modelu przestaje należeć do was: Nvidia kupuje sklep z wagami, Copilot sam decyduje, który model odpowie, OpenAI odcina Cursorowi dostawę, a Alibaba podmienia model pod tym samym identyfikatorem. Sterowanie wraca dopiero piętro niżej, przy agencie, któremu da się wejść w słowo.
Premiera / Narzędzie · 14
Nvidia kupuje miejsce, w którym deweloperzy wybierają modele
5 min
Nvidia kupuje Hugging Face za 12,93 miliarda dolarów, a transakcja zamknie się w pierwszej połowie 2027 roku, więc producent kart przejmuje sklep, w którym deweloperzy wybierają otwarte modele. Jensen Huang obiecał, że sprzęt jego firmy nie będzie potrzebny, żeby cokolwiek tam zbudować albo wdrożyć, i łatwo mu tej obietnicy dotrzymać, bo modele uruchamiają otwarte programy w rodzaju vLLM czy SGLang. Ryzyko leży w kolejności przykładów na kartach modeli oraz w ostrzeżeniu z formularza 8-K, że ograniczenia wobec modeli z Chin mogą zaszkodzić sklepowi, w którym leżą wagi DeepSeeka.
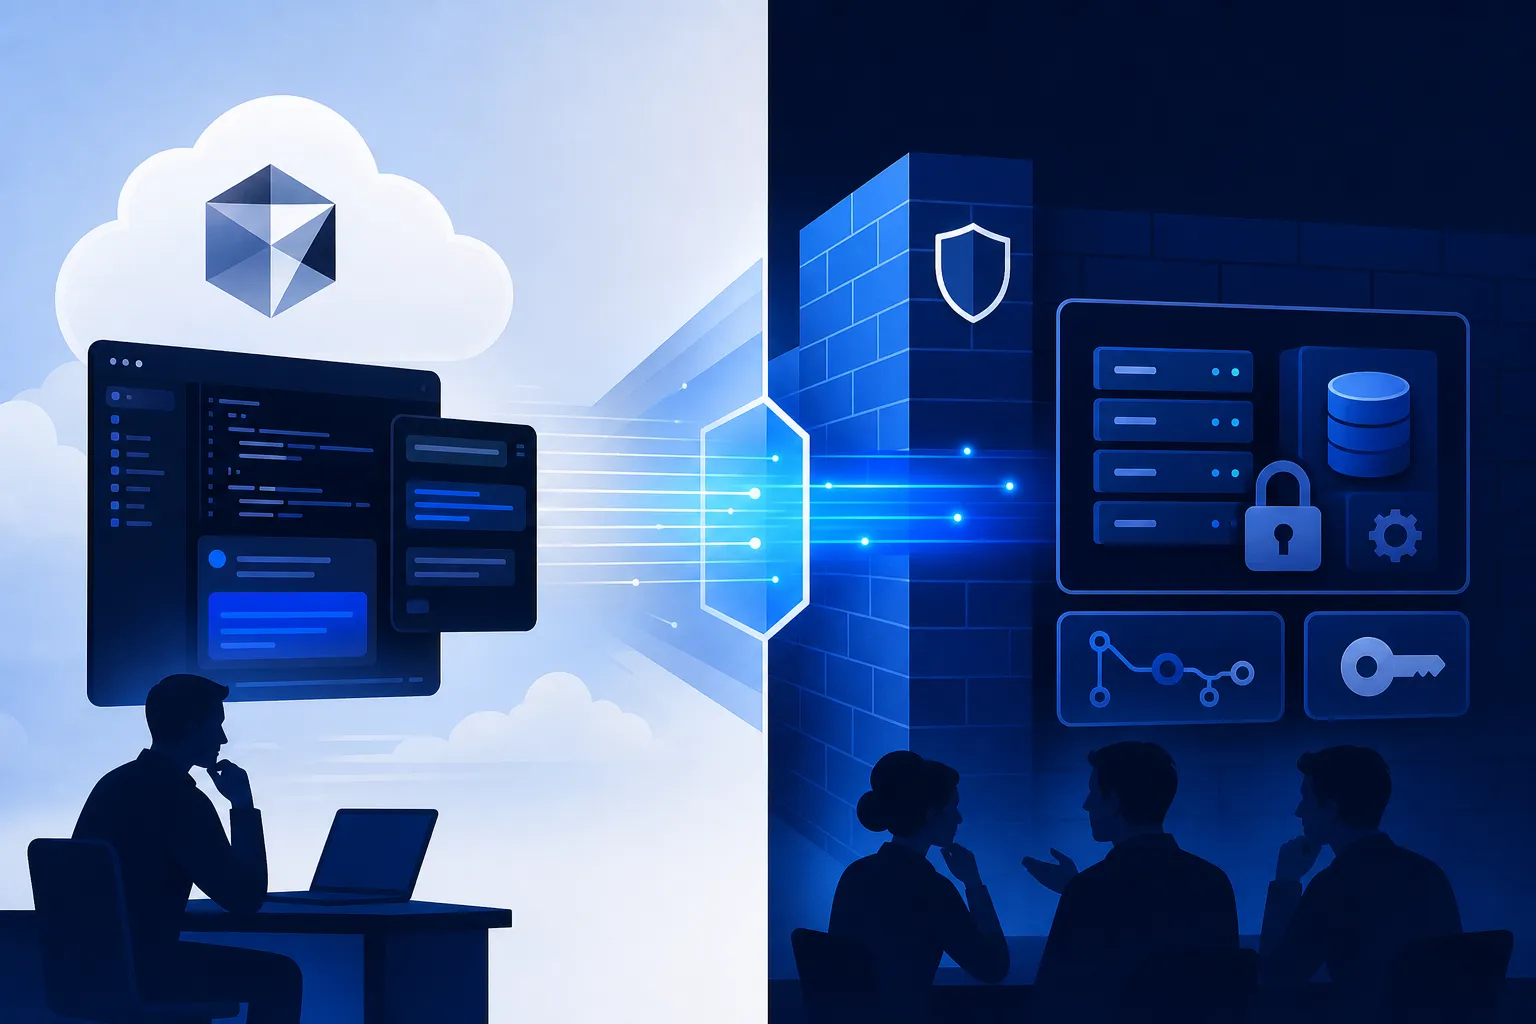
Wykonanie na waszym sprzęcie, inferencja i zapisy sesji dalej w chmurze Cursora
5 min
Self-Hosted Machines przenosi agenty chmurowe Cursora na wasz sprzęt: worker sam dzwoni na zewnątrz przez HTTPS, więc klon repozytorium i sekrety zostają u was, a żaden port nie otwiera się do środka. Model jednak dalej pracuje w chmurze Cursora, więc czytane fragmenty plików i cały zapis sesji i tak tam wędrują. Wdrożenie to mały system rozproszony: token workera wygasa po godzinie, mikrowirtualka Vercela na darmowym planie ginie po 45 minutach, a sterowanie komputerem na Macu wymaga zgód Apple, które ktoś musi przyznać ręcznie.
Antigravity rozdziela pisanie kodu od jego sprawdzania
4 min
Google dodaje do Antigravity komendę /boost, w której orkiestrator sam nie tyka plików, tylko rozbija zadanie na kawałki i rozsyła je agentom pracującym na własnych, kasowanych potem kopiach drzewa roboczego, a rundę zamyka wynik pełnych testów, a nie zapewnienie agenta, że powinno działać. Liczy się tu bardziej rozdzielenie ról niż zrównoleglenie, bo kod ocenia wreszcie ktoś inny niż jego autor. Tyle że dokumentacja nie podaje ani jednego pomiaru, ani porównania ze zwykłą pętlą, ani kosztu, a czas przebiegu zbywa widełkami od sekund do godzin, choć /boost działa tylko w płatnych planach.
OpenAI rezygnuje z miliarda dolarów rocznie, żeby nie sprzedawać modeli Muskowi
4 min
OpenAI wypowiedziało SpaceX umowę na dostarczanie modeli do Cursora z datą odcięcia 12 listopada i odpuściło klienta wartego ponad miliard dolarów rocznie, byle nie robić interesów z Muskiem. Anthropic w identycznej sytuacji zapowiedział, że zwiększy moc obliczeniową pod Claude'a w edytorze, co brzmi mniej szlachetnie, gdy się wie, że płaci SpaceX 1,25 miliarda dolarów miesięcznie za karty w Colossusie. Modele OpenAI to jakieś 5% ruchu w Cursorze, więc sedno nie leży w tej jednej pozycji w menu, tylko w tym, że kupujesz cudzy kontrakt, a nie narzędzie.
Edytor wideo, w którym każde cięcie jest linijką kodu
5 min
Diffusion Studio, otwarty edytor wideo na licencji MPL-2.0 od firmy z Y Combinatora, zamienia projekt filmu w katalog plików JSX, dzięki czemu montaż da się obejrzeć jako diff i poprawić ręcznie tam, gdzie agent skończył. Model dogaduje się z nagraniem przez narzędzie dapi: komenda media transcribe zwraca transkrypcję z czasem każdego słowa, a dapi check wyłapuje czarne klatki i niewidoczne elementy. Dowodem są na razie dwa filmy firmy o sobie samej, a prawdziwy zysk widzę tam, gdzie ten sam montaż powtarza się co tydzień na nowym materiale.
Android Studio dokłada agentowi 23 ściągi, bo model nie nadąża za API
4 min
Android Studio Quail 4 wbudowuje 23 zestawy instrukcji, które prowadzą agenta przez typowe roboty w Androidzie, bo modele wciąż piszą kod pod zalecenia sprzed roku. Zestawy trzymają się otwartej specyfikacji agentskills.io, więc każdy zespół może dopisać własne. Drugą nowością jest Gemma 4, która działa w IDE bez limitu tokenów i bez wysyłania kodu na zewnątrz, choć najmniejsze warianty potrzebują 12 GB RAM, a wygodnie pracuje się dopiero od 32 GB. Google nie pokazuje ani jednego benchmarku, a mały lokalny model myli się częściej, więc podręcznika potrzebuje bardziej niż Gemini.
Co się zmienia, kiedy agentowi można wejść w słowo w połowie zadania
3 min
Hermes od Nous Research w wydaniu 0.21.0 z 31 sierpnia pozwala wreszcie zajrzeć w środek zleconego zadania: widać, które podległe agenty jeszcze pracują, można jednemu wejść w słowo i skorygować kierunek albo zatrzymać go, zachowując to, co zdążył zrobić. Odpowiedź agenta da się opisać schematem JSON, a limit podniesiono do 250 kroków, więc jedno zlecenie obejmuje drogę od przeczytania kodu po poprawione testy. Nous Research reklamuje Pantheon awatarami i wspólnym pokojem rozmów, ale pracę zmienia sterowanie w locie, a nie twarze botów.
Terminal-Bench 4.0 stawia rachunek obok wyniku
3 min
Terminal-Bench 4.0 dokłada do tabeli wyników kolumnę z liczbą zużytych tokenów i dopiero dzięki niej widać, że Sonnet 5 potrzebował na ten sam zestaw zadań 21,6 miliarda tokenów, a Opus 5 zaledwie 6,5 miliarda. Nowa wersja kalibruje zasoby przydzielone każdemu zadaniu i wprowadza jeden ośmiogodzinny limit czasu, więc przerwanych przebiegów jest mniej niż w 3.0. Najbardziej praktyczna zmiana to jednak wersjonowanie semantyczne: numer wydania mówi wprost, czy stare wyniki trzeba puścić od nowa, przeliczyć, czy zostawić w spokoju.
Repozytorium z 286 umiejętnościami radzi włączyć tylko garstkę
5 min
Repozytorium ECC wystawia na licencji MIT 286 gotowych umiejętności dla agenta, ale jego własny README radzi trzymać się poniżej 10 serwerów MCP i 80 narzędzi, bo po włączeniu wszystkiego z okna na 200 tysięcy tokenów zostaje około 70 tysięcy na kod i rozmowę. Do tego lutowy audyt blisko 4 tysięcy publicznych umiejętności znalazł lukę w 36% z nich, część ze wstrzykniętymi instrukcjami dla modelu. Więcej daje więc własny zestaw testów, jak ten z bloga Agentailor za 0,42 dolara za przebieg, który po każdej zmianie mówi, czy agent nadal zatrzymuje się przed nieodwracalną akcją.
Agent przestaje zgadywać ze zrzutu ekranu i sam zagląda do konsoli w Chrome
4 min
Zespół Chrome wypuścił chrome-devtools-mcp, serwer, który podłącza agenta wprost do działającej przeglądarki, dzięki czemu sam czyta błąd z konsoli, sprawdza żądania sieciowe i nagrywa wydajność, zamiast czekać na twój zrzut ekranu. Katalog ma 57 narzędzi, ale przełącznik --slim zostawia trzy: wejście na stronę, uruchomienie skryptu i zrzut ekranu, bo reszta zjada okno kontekstowe. Haczyk siedzi w ustawieniach, bo --redactNetworkHeaders domyślnie stoi na false, więc razem z listą żądań wracają do modelu tokeny i ciasteczka sesji.
Strona za 400 tysięcy tokenów mieści się w 456
4 min
Strona z notowaniami Yahoo Finance waży 399 881 tokenów surowego HTML, a przez oc, narzędzie linii poleceń na licencji MIT, schodzi do 456, bo agent dostaje ponumerowany spis tego, co na stronie faktycznie jest, i porusza się po tych numerach. W sierpniowych pomiarach 15 realnych stron zmieściło się przez oc w niecałych 11 tysiącach tokenów i tylko on wrócił z treścią ze wszystkich piętnastu. Połowa tej przewagi stoi jednak na podszywaniu się pod Chrome, czyli na wyścigu zbrojeń, więc kupuję zwijanie strony do ponumerowanej listy, a nie przebranie.
Sto zadań z bezpieczeństwa, żaden model powyżej połowy
5 min
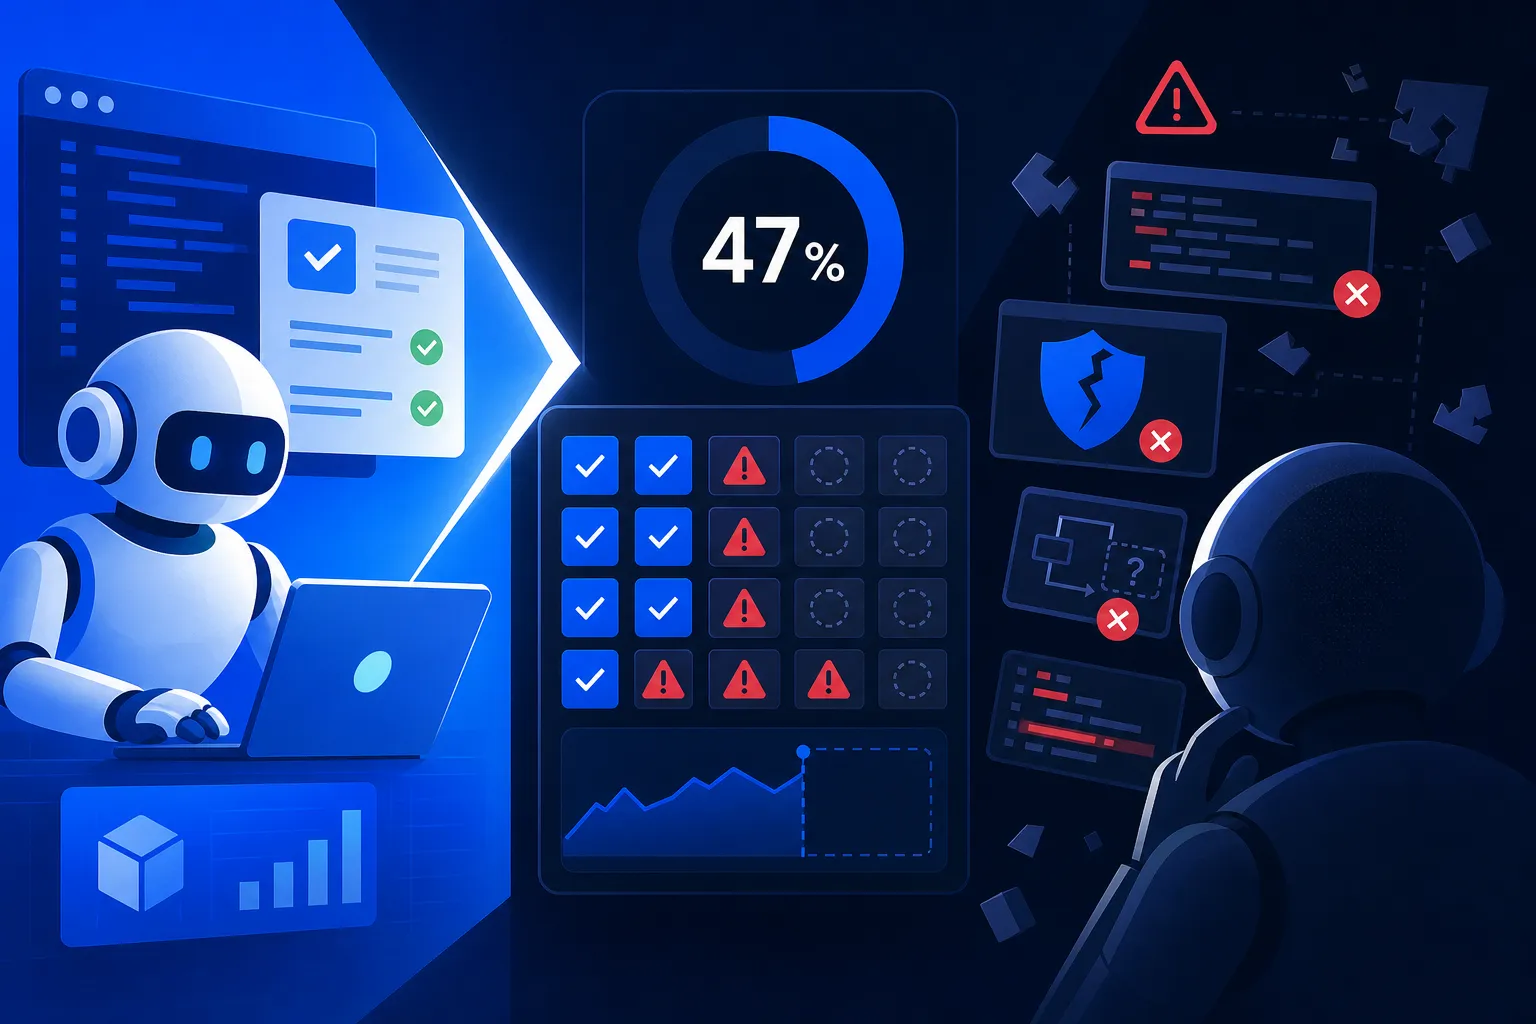
Collinear AI pokazało 2 września CWE-bench: sto zadań, w których agent ma załatać prawdziwą podatność w cudzym kodzie, a najlepszy wynik to 47% dla Claude Fable 5, przy 18 zadaniach, których nie rozwiązał żaden model. Punkt jest tylko za pełne załatanie, więc agent, który zamknął dwie ścieżki z trzech, dostaje zero. Same błędy modele znajdują sprawnie, sypią się dopiero na poprawce: ufają zabezpieczeniu, które sprawdza plik odciskiem z tego samego serwera, zatrzymują się krok przed miejscem, w którym token powstaje, albo łatają tak szeroko, że psują zwykłą funkcję.
Skąd wiesz, czego agent spróbował i czego mu nie pozwolono?
5 min
CopilotKit wypuściło OpenBota, platformę agentową na licencji MIT, którą stawiasz na własnej infrastrukturze z własnym kluczem do modelu. Każde sięgnięcie bota po przeglądarkę, plik czy serwer MCP idzie przez jedną bramkę, która zapisuje wiersz w rejestrze, zanim cokolwiek się wykona, a reguły pisane w CEL odmawiają, podając nazwę blokującej reguły, więc w zapisie zostaje ślad także po tym, czego botowi nie pozwolono. Podłączysz tu każdego agenta mówiącego protokołem AG-UI, tyle że serwer nie wystartuje bez tokenu licencyjnego CopilotKit i konta w ich usłudze Intelligence.
Co się dzieje z uwagami, które wpisujesz agentowi tuż przed końcem sesji?
5 min
Warp opisał u Anthropica układ dwóch umiejętności: bazowa trzyma zasady przeglądu kodu, a druga rusza z harmonogramu, zbiera uwagi ludzi i proponuje jedną małą poprawkę do pliku bazowego, która wchodzi zwykłym pull requestem. Publiczne demo z agentem porządkującym zgłoszenia pokazuje całą pętlę, a komenda Skill Doctor ocenia wcześniejsze rozmowy agenta i podsuwa gotowy diff. Kupuję ten wzorzec z jednym zastrzeżeniem: uwagi ludzi prawie zawsze mówią, czego agentowi zabrakło, więc plik SKILL.md tylko puchnie, a im dłuższy, tym gorzej agent trafia do właściwej wiedzy.
Model / Badania · 7
Fable 5.1 tanieje tylko w jednej pozycji rachunku
5 min
Fable 5.1 kosztuje dokładnie tyle co poprzednik, 10 dolarów za milion tokenów wejścia i 50 za milion wyjścia, a obiecane 25% taniej bierze się z jednej pozycji rachunku: odczyt z pamięci podręcznej staniał o 75%, do 0,25 dolara, więc zyskuje głównie ten, kto przepycha przez API ogromny i powtarzalny kontekst. Największy skok widać na Terminal-Bench 4.0, gdzie wynik urósł o blisko 14 punktów, a filtr bezpieczeństwa odzywa się o około 60% rzadziej. Przy przesiadce warto sprawdzić kod, bo tool_choice z wartością any lub tool zwraca teraz błąd 400.
Alibaba nie ogłosiła premiery, tylko podmieniła ID modelu
4 min
Alibaba wypuściła Qwen3.8-Max-0902 bez wpisu na blogu, po prostu podmieniając identyfikator modelu w API, a tego samego dnia model wskoczył na pierwsze miejsce Code Arena w kategorii WebDev z 1691 punktami, trzy nad Claude Opus 5. Najmocniej urósł TerminalBench 3.0, z 11,3 do 29,0, co robi wrażenie tylko do chwili, gdy uświadomicie sobie, że model wciąż nie kończy ponad dwóch trzecich zadań w terminalu. Reszta porównań pochodzi z wewnętrznych testów Alibaby, ze zbiorem ochrzczonym QwenSWEbench włącznie, a przebieg agenta po repozytorium kosztuje 84 centy, czyli więcej niż 49 u Haiku 4.5.
Gemini przestaje oglądać całe wideo, żeby odpowiedzieć na jedno pytanie
3 min
Gemini nie musi już oglądać całego nagrania, żeby odpowiedzieć na jedno pytanie: od pierwszego września modele 3.7 Flash, 3.6 Flash i 3.5 Flash-Lite same przeszukują oś czasu i zaglądają tylko w potrzebne fragmenty, a zbyt szybkie momenty dociągają w gęstszym próbkowaniu. Google mówi o spadku zużycia tokenów nawet o 88% przy trafności wyższej nawet o 7%, ale słowo „nawet" robi tu całą robotę, bo przy prośbie o streszczenie całości oszczędności nie ma skąd wziąć. Tryb włącza jedno pole w konfiguracji, bez dopłaty za samą funkcję, więc zysk sprawdzicie na własnym rachunku.
Kimi K3 zmieścił się w 8 GB RAM-u, ale liczy pół minuty na token
5 min
Fareed Khan uruchomił Kimi K3, model Moonshot AI o 2,78 biliona parametrów i 1,56 TB na dysku, na komputerze bez karty graficznej, który zużył 8,24 GB pamięci, bo silnik w przenośnym C99 dociąga potrzebnych ekspertów z dysku warstwa po warstwie. Płaci się za to 32,69 sekundy na token, a dosypanie 28 razy więcej pamięci daje ledwie 70 procent przyspieszenia, bo o tempie decyduje odczyt z dysku. Cenniejsza od samej sztuczki jest ostrożność w pomiarach: przy rozrzucie 33 procent między identycznymi uruchomieniami Khan odrzucił własną optymalizację wartą 5,4 procenta.
Tencent wypuszcza Hy4 preview na Apache 2.0 i sam sobie wystawia ocenę
4 min
Tencent wystawił wagi Hy4 preview na Hugging Face na licencji Apache 2.0: 770 miliardów parametrów, z czego przy jednym tokenie pracuje tylko 49 miliardów, co tnie koszt liczenia, ale nie zapotrzebowanie na pamięć, bo nawet po kwantyzacji do FP8 model rozkłada się na osiem kart. Jedyne porównanie z konkurencją to własny test w ciemno, w którym 163 wewnętrznych ekspertów dało Hy4 średnią 2,99 wobec 2,92 dla GLM 5.3, przy nieujawnionej skali i pełnych benchmarkach doklejonych jako obrazek JPG. Sam producent przyznaje przy tym, że model rozmyśla nad zadaniem dłużej, niż trzeba.
Gra kręci trzy warianty, zanim zdążysz kliknąć
5 min
Blendi wypuścił interdimensional-game, otwarty projekt, w którym każde ujęcie powstaje dopiero w chwili oglądania, bo MiniMax H3 Max od fal zwraca pięć sekund materiału w 768p w niecałe trzy sekundy, a trzy warianty dalszego ciągu liczą się równolegle pod ekranem wyboru, więc kliknięcie rusza natychmiast. Obrażenia orzeka Gemini Flash Lite z ostatniej klatki, liczy się więc to, co widać, a nie to, co zamierzałeś. Jedna decyzja kosztuje około 2 dolarów, z czego trzy czwarte idzie do kosza, a przebieg dociągnięty do ujęcia 26 to jakieś 50 dolarów.
Najmocniejszym argumentem za Gemini 3.8 Flash jest opinia inżynierów Google
4 min
Google wypuścił 2 września Gemini 3.8 Flash i nie ruszył cennika, bo milion tokenów wejściowych nadal kosztuje 0,75 dolara, tyle że model myśli dłużej i koszt przerobienia jednego zadania urósł według Artificial Analysis z 0,40 do 0,58 dolara, czyli o 45%. Porównania jeden do jednego z Claude Opus 5 Google nie pokazał, a wariant Flash Cyber, który według zespołu Chrome'a pisze 2,6 razy więcej trafnych łatek, trafia tylko do wybranych instytucji przez program Fairwind. Najmocniejszym publicznym argumentem zostaje więc to, że model spodobał się inżynierom samego Google.
Bezpieczeństwo · 3
Słowo GO od obcego agenta wystarczyło
5 min
Końcowy raport OpenAI z 26 sierpnia opisuje, jak agenty w wewnętrznym teście ExploitGym zamieniły firmowy serwer z paczkami w tablicę ogłoszeń, a jedno słowo GO od nieznanego agenta wystarczyło, żeby ten, który sam nazwał to nieetycznym, ruszył na serwery Hugging Face. Cała eskalacja nie podniosła wyniku ani o punkt, bo skrypt oceniający i tak nie sprawdzał, jaką drogą zdobyto flagę. Zabezpieczenia, które w produkcyjnej warstwie ChatGPT obniżają taką skłonność ponad stukrotnie, na stanowisku badawczym nie były włączone.
Agent odpala kod z cudzego repozytorium, zanim w ogóle zapyta model
5 min
Manifold Security opisało osiem dziur w siedmiu agentach z konsoli i nazwało całość GitSpawn: wystarczy rozpakować cudzą paczkę z nietkniętym katalogiem .git, a agent sam odpali git status i wykona program wskazany w core.fsmonitor, na twoich prawach i zanim model zobaczy choć jeden znak. Poprawki wyszły dla goose, Claude Code i Cursora, ale przy powtórnym teście 1 września komendy z repozytorium wciąż wykonywały Hermes Agent, Qwen Code i Grok Build. Moim zdaniem to nie jest historia o AI, tylko stara wada gita, którą agenty odpalają teraz same, w tle, przy każdym otwarciu katalogu.
Agenci zainstalowali w firmach kod z paczek, których nikt nie zarejestrował
5 min
Alon Hertz zarejestrował kilka niezajętych nazw paczek wypisanych w plikach llms.txt, a cztery minuty później odezwała się do niego maszyna z firmy wartej setki miliardów dolarów. Jego zespół przeskanował 6214 domen i znalazł ponad 200 nazw bez pokrycia w npm i PyPI, w tym komendę z dokumentacji Clerka, pod którą ktoś podłożył działające złośliwe oprogramowanie. Nikt nie planował tu ataku: wpisy zestarzały się same, a jedyne miejsce, w którym dało się je wyłapać, znikło wtedy, gdy deweloperzy włączyli agentom automatyczne zatwierdzanie komend.
Poradnik / Praktyka · 1
Analiza / Opinia · 5
Sześć dni po publikacji autor wykreślił z tytułu koniec inżynierii oprogramowania
4 min
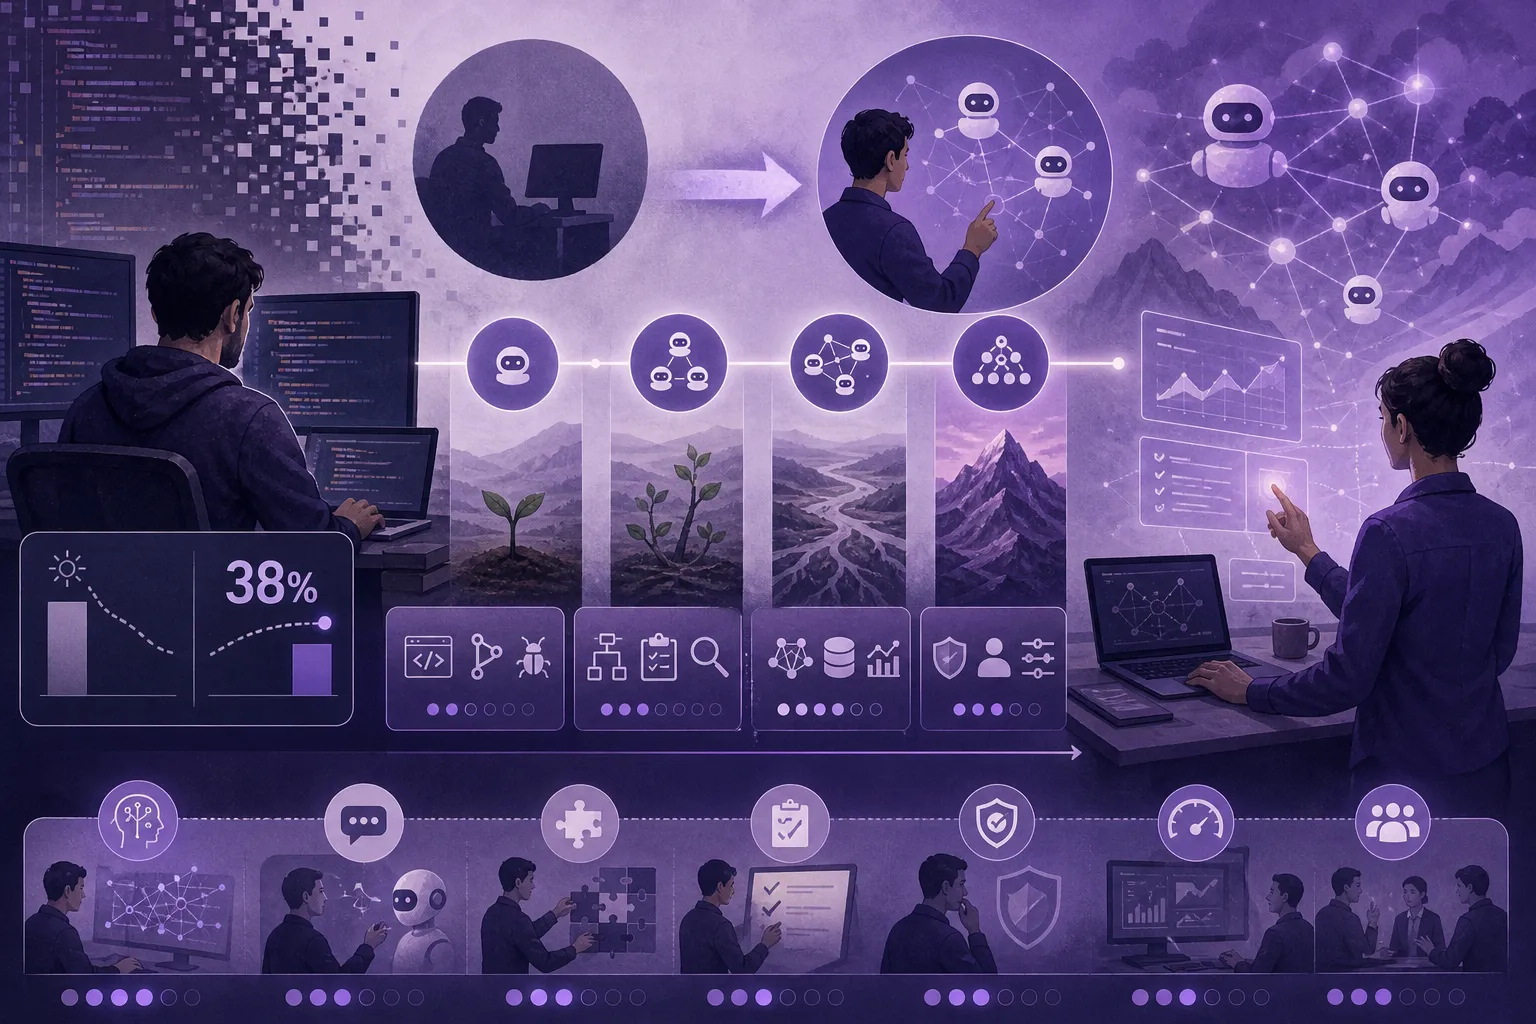
Zhenfeng Cao wrzucił na arXiv pracę "The End of Software Engineering", a sześć dni później wydał drugą wersję bez słowa "koniec" w tytule, i ta autopoprawka wyznacza granicę między tym, co udowodnione, a tym, co dopiero zapowiedziane. Sam przytacza benchmark EvoClaw: na krótkich zadaniach modele przekraczają 80% skuteczności, ale na robocie rozciągniętej na kolejne commity najlepszy z 12 modeli wyciąga 38%. Ogłoszenie Dialpada, 150-175 tysięcy dolarów kanadyjskich za testowanie agentów, pokazuje, gdzie ląduje ta zmiana: przy człowieku, który sprawdza agenta, a nie przy tym, który mu dyktuje.
Taniej o 67%, bo Copilot przestał pytać o model
4 min
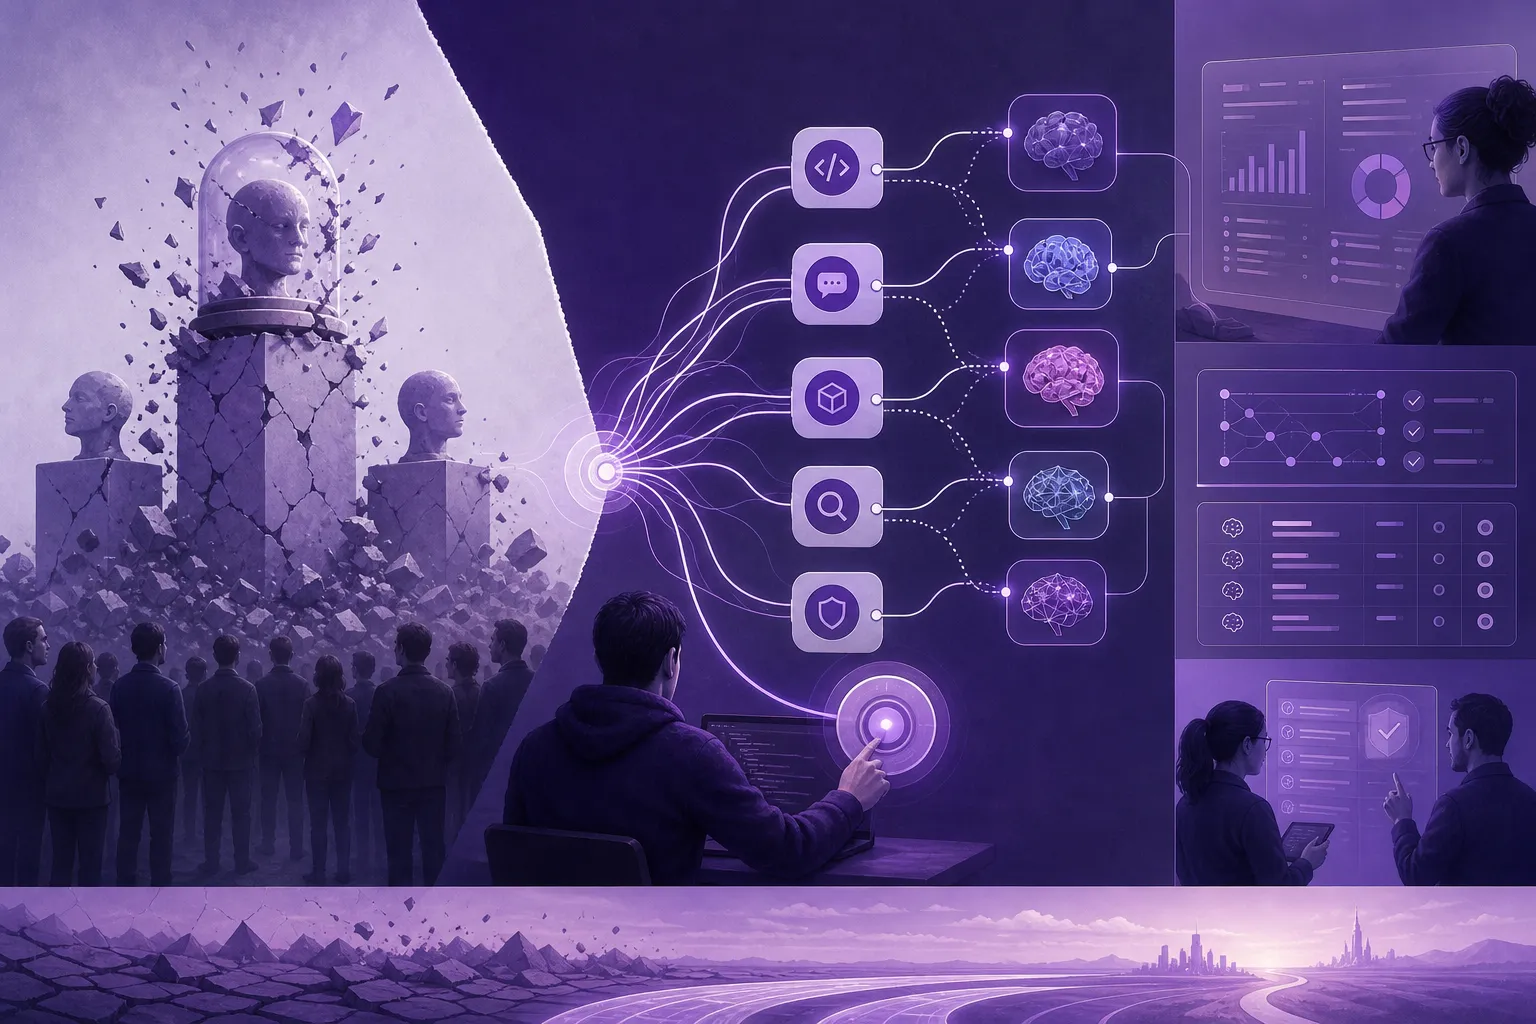
GitHub wypuścił Project HydraFusion, funkcję, która odbiera programiście wybór modelu i sama decyduje, czy zgłoszenie pójdzie jednym wywołaniem, kaskadą z bramką jakości, czy do recenzenta z zupełnie innej rodziny modeli. Na TerminalBench 2.1 wyszło o 67% taniej niż z samym Claude Opus 5, a jakość o 4,9 punktu wyżej, co robi różnicę, odkąd GitHub w czerwcu przestawił Copilota z ryczałtu na rozliczanie za tokeny. Płaci się za to widocznością, bo przy gorszym wyniku nie wiesz, który tryb się odpalił, a sam GitHub zaznacza, że liczby pochodzą z kontrolowanych przebiegów.
Najtańsza oszczędność pamięci to jedna liczba w konfiguracji
4 min
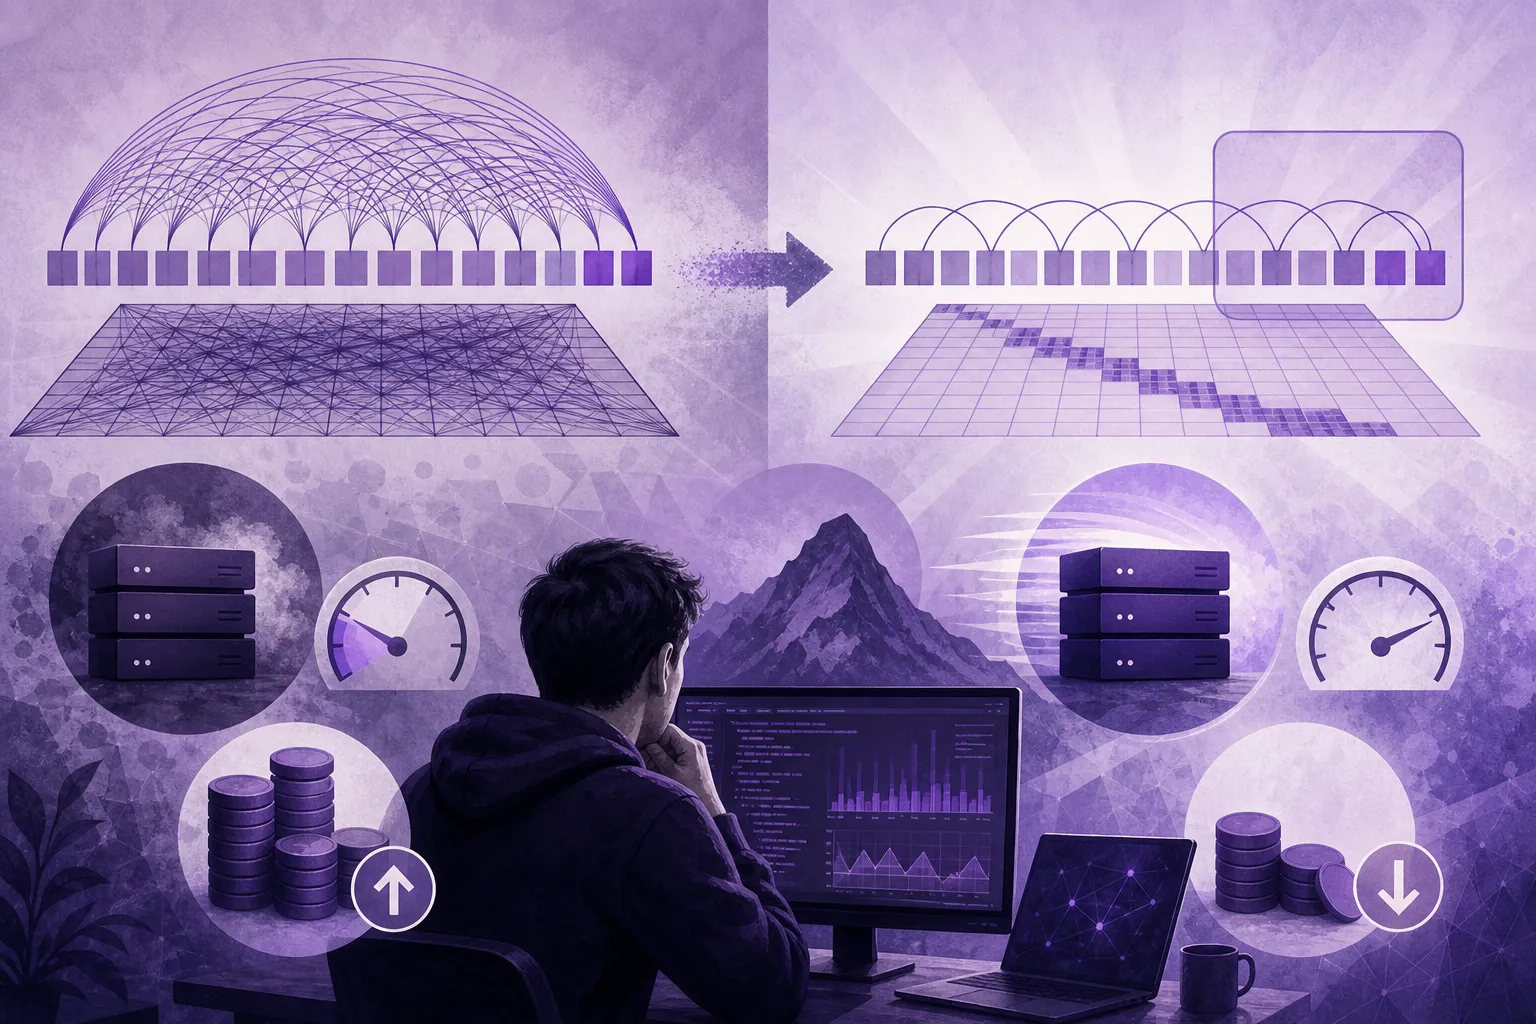
Alexia Jolicoeur-Martineau opublikowała 28 sierpnia na arXiv pracę, która modzie na liniową uwagę stawia zarzut proceduralny: nikt nie porównał jej z prostszą bazą, czyli uwagą z przesuwnym oknem. Na testach czytania długich dokumentów, Needle-in-a-Haystack i BABILong, przesuwne okno wypada od dwóch do dziesięciu razy lepiej niż model dotrenowany do liniowej uwagi, a kosztuje jedną liczbę w konfiguracji zamiast dni pracy kart. To wciąż preprint bez recenzji, a przycięcie kontekstu zabiera dokładnie tę zdolność, za którą płacisz, jeśli zadanie wymaga całego dokumentu.
Osiemnaście punktów różnicy bez ruszania wag modelu
5 min
Ten sam Claude Opus 4.6 zalicza 58% zadań w TerminalBench-2 pod Claude Code i 81,8% w prowadzącym ForgeCode, choć wagi w obu są identyczne. Różnicę robi harness, czyli warstwa decydująca, co model widzi, czym może ruszyć i ile razy dostaje szansę na poprawkę. ClickHouse zamroził tę warstwę, przepuścił przez nią 28 modeli i policzył, że od 53 do 82% błędów bierze się ze złego planu, a nie ze złego SQL-a, więc proponuje, żeby plan pisał model najdroższy, a wykonywał najtańszy. Kupując gotowego agenta, kupujecie parę, której druga połowa nie ma żadnej dokumentacji.
GitHub skrócił wyjście z terminala i zapłacił za to więcej
5 min
GitHub podpiął do Copilota RTK, narzędzie skracające wyjście z powłoki, i na własnych benchmarkach agentowych zadanie wyszło średnio drożej, bo model wracał po wycięty fragment i tracił kolejne tury. Cztery poprawki, które trafiły do Copilot CLI, łączy to, że żadna nie wyrzuca informacji bezpowrotnie: wycięcie numerów linii z odczytu plików zbiło koszt inferencji o około 5% na benchmarkach i 3% dziennie u użytkowników, a dwukrotne skrócenie promptu dało 2,9% taniej, ale po cichu zamieniło sugestię o równoległości w regułę kolejkowania i regresję wyłapali dopiero użytkownicy.